설명
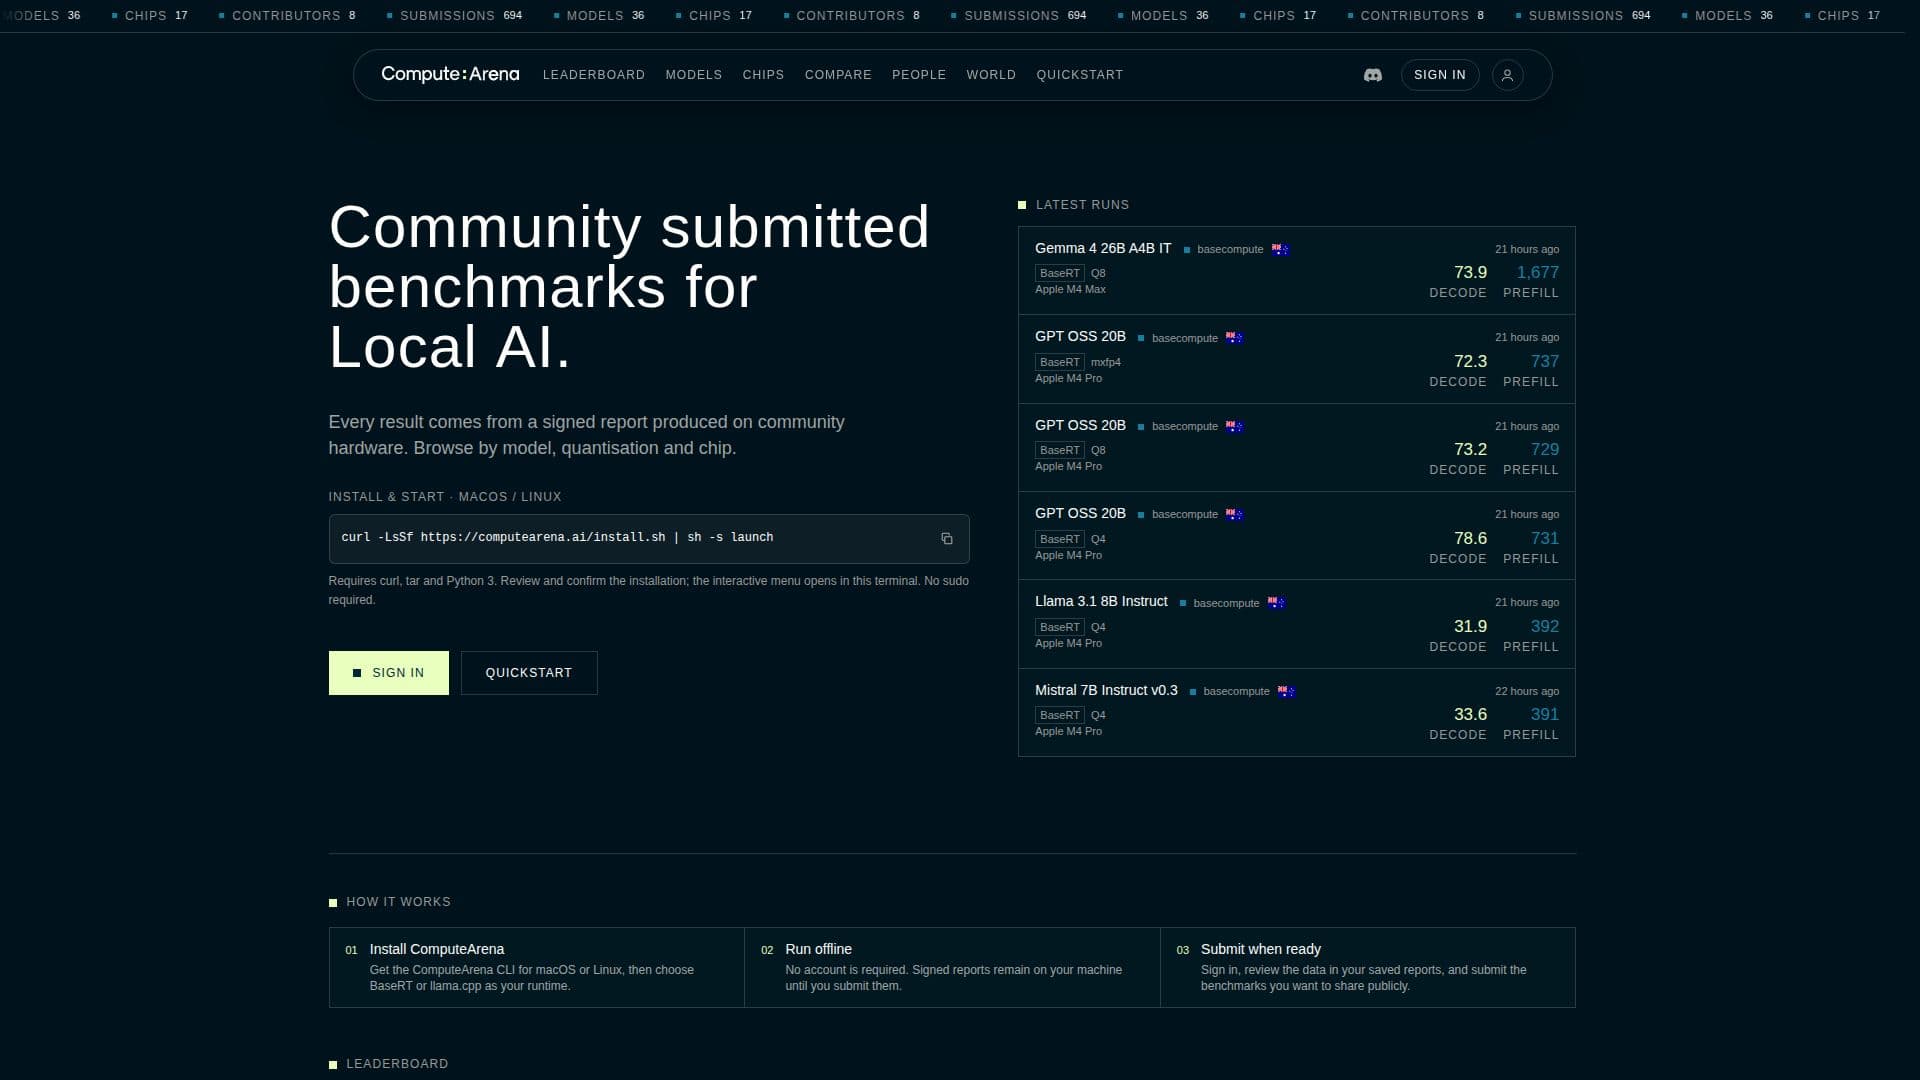
ComputeArena는 커뮤니티 기여를 통해 로컬 AI 벤치마크를 제공하는 플랫폼입니다. 8명의 커뮤니티 구성원이 기여한 36개 모델과 17개 칩에 걸쳐 694개의 벤치마크를 호스팅합니다. 이 플랫폼은 사용자가 모델, 양자화 및 칩별로 초당 토큰을 디코딩하고 미리 채울 수 있도록 하며, BaseRT 또는 llama.cpp로 측정됩니다.
더 읽기
벤치마크는 커뮤니티에 의해 제출되며, 커뮤니티 하드웨어에서 생성된 서명된 보고서를 기반으로 합니다. 사용자는 모델, 양자화 및 칩별로 결과를 탐색할 수 있어 다양한 구성 간의 성능 비교가 용이합니다. 이 플랫폼은 macOS와 Linux를 지원하며, 설치를 위해 curl, tar 및 Python 3이 필요합니다. 사용자는 ComputeArena CLI를 설치하고 BaseRT 또는 llama.cpp 중에서 런타임을 선택할 수 있습니다.
ComputeArena는 오프라인으로 작동하므로 벤치마크를 실행하기 위해 계정이 필요하지 않습니다. 서명된 보고서는 사용자의 기계에 남아 있으며, 사용자가 제출하기로 결정할 때까지 유지됩니다. 준비가 되면 사용자는 로그인하여 저장된 보고서를 검토하고 공개적으로 공유할 벤치마크를 제출할 수 있습니다.
이 플랫폼은 호환 가능한 PP512 미리 채우기 및 TG128 디코드 작업 부하를 비교하는 헤드라인 순위를 제공하며, 각 결과와 함께 측정된 작업 부하가 표시됩니다. 이 기능은 사용자가 다양한 AI 모델 및 구성의 성능에 대한 통찰력을 얻을 수 있도록 하여, 필요에 맞는 최상의 설정을 선택하는 데 도움을 줍니다.
- 카테고리머신러닝 및 데이터 사이언스
- 요금제무료
- 배포셀프 호스팅
- 플랫폼macOS, Linux
ComputeArena의 핵심 기능
커뮤니티 제출 벤치마크
macOS 및 Linux 지원
오프라인 사용을 위한 계정 불필요
신뢰성을 위한 서명된 보고서
모델, 양자화 및 칩별 비교
BaseRT 또는 llama.cpp 런타임 사용
인터랙티브 설치 메뉴
성능 비교를 위한 헤드라인 순위
ComputeArena 사용 방법은?
설치: macOS 또는 Linux용 ComputeArena CLI를 가져옵니다.
런타임 선택: BaseRT 또는 llama.cpp를 선택합니다.
오프라인 실행: 계정 없이 벤치마크를 실행합니다.
제출: 준비가 되면 로그인하고 벤치마크를 제출합니다.
ComputeArena의 사용 사례
- 모델 성능 비교
- 커뮤니티 벤치마킹
- 오프라인 벤치마킹
- 양자화 분석
- 칩 성능 평가