メインコンテンツへスキップ
ToolPotion
AI アドバイザー
送信(無料)

WeMM-Video-35B-A3B

LLM#38AIモデルとLLMオープンソース · Web

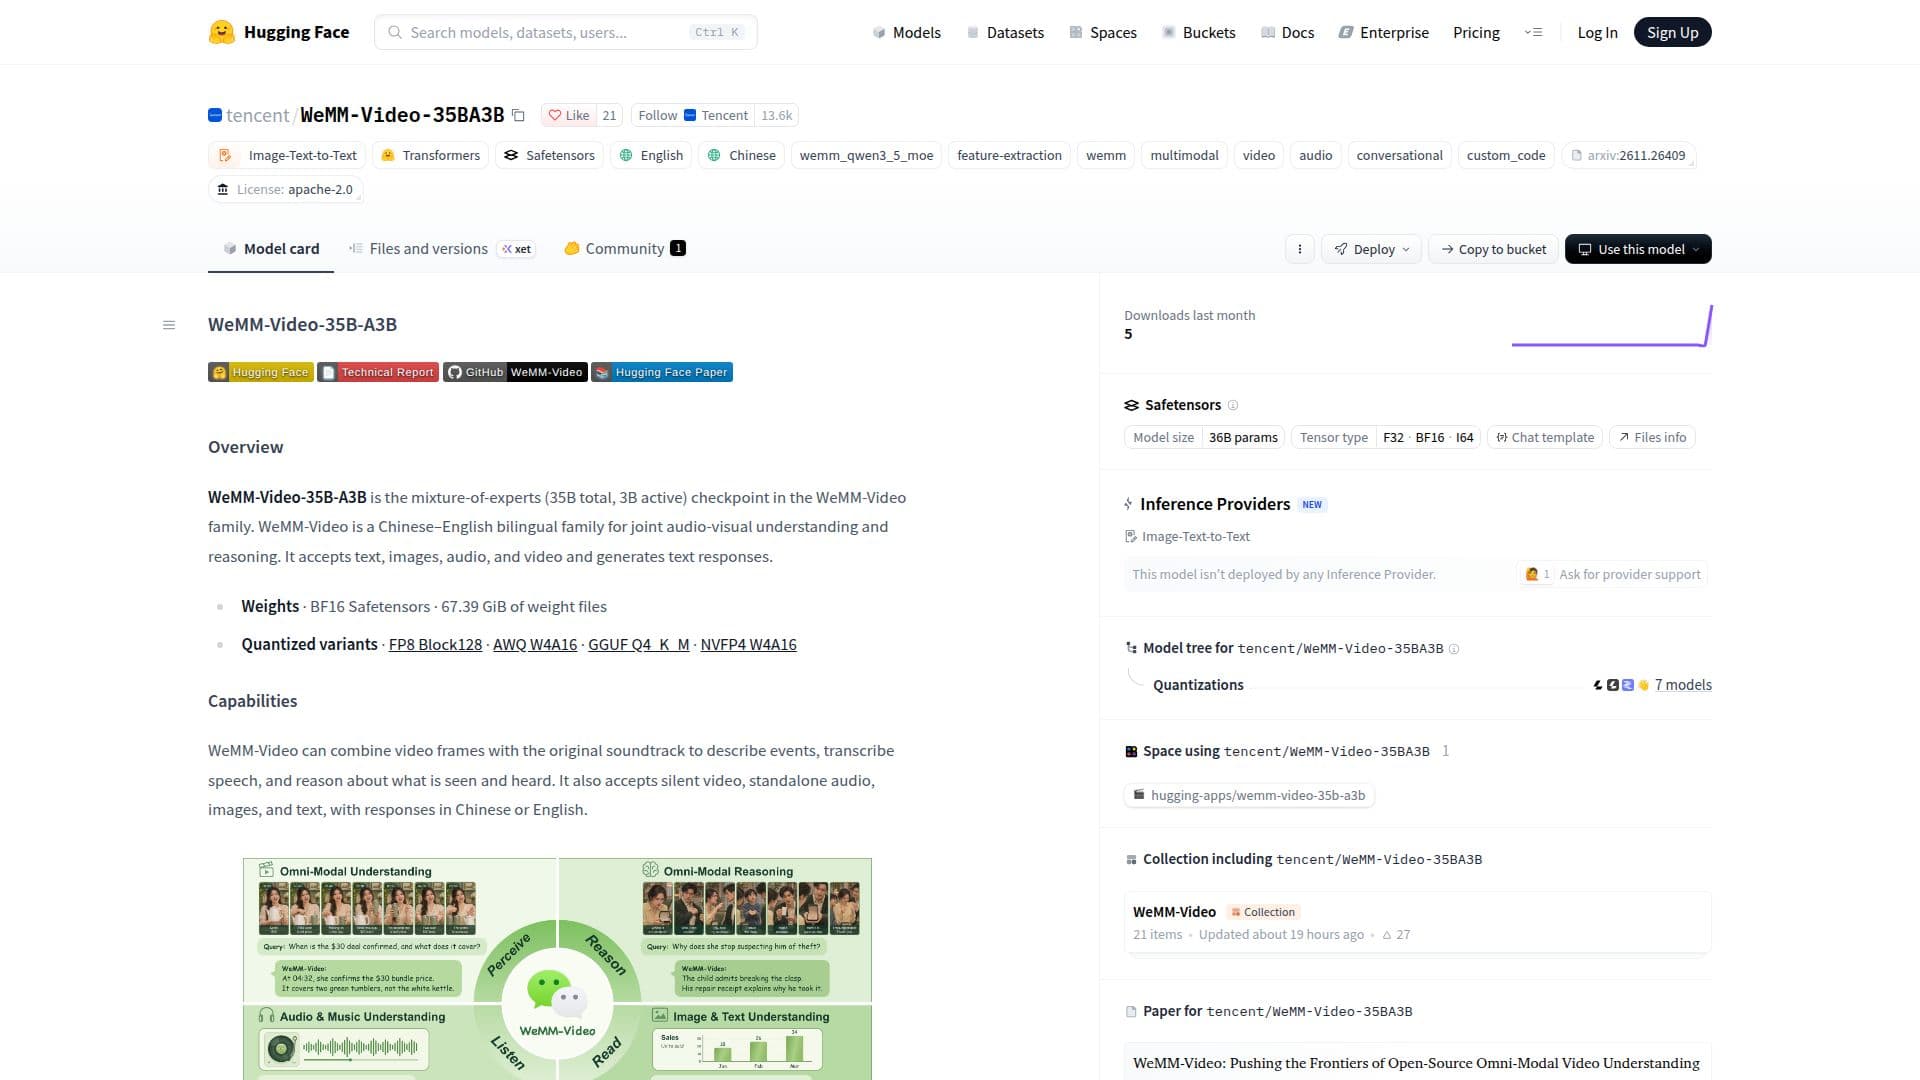
WeMM-Video-35B-A3Bは、音声と視覚の共同理解と推論のために設計されたWeMM-Videoファミリーのミクスチャー・オブ・エキスパートモデルです。この中英バイリンガルモデルは、テキスト、画像、音声、動画の入力を受け付け、テキスト応答を生成します。イベントを説明したり、スピーチを文字起こししたり、見たり聞いたりしたことについて推論したりすることができ、直接的な応答モードと推論応答モードの両方を提供します。

URLを訪問
共有
WeMM-Video-35B-A3B のスクリーンショット

WeMM-Video-35B-A3Bは、包括的な音声と視覚の理解と推論のために開発された高度なミクスチャー・オブ・エキスパートモデルで、WeMM-Videoファミリーの一部です。合計350億のパラメータと30億のアクティブパラメータを持つこのモデルは、テキスト、画像、音声、動画などのマルチモーダル入力を処理し、中文または英語で一貫したテキスト応答を生成するように特別に設計されています。

続きを読む

このモデルの主な機能には、動画フレームとその元のサウンドトラックを組み合わせてイベントを説明する能力、音声を正確に文字起こしする能力、視覚情報と聴覚情報の両方に基づいて推論タスクを実行する能力が含まれます。また、サイレント動画、スタンドアロン音声、画像、テキスト入力を独立して処理することもできるため、異なるメディアタイプにわたる深い文脈理解を必要とする幅広いアプリケーションに適しています。

WeMM-Video-35B-A3Bは、メディア入力をトークンに変換するために視覚および音声エンコーダを使用し、テキストと共に言語モデルによって処理されます。動画フレームには、時間的文脈を維持するためにタイムスタンプが付加されます。このモデルファミリーは、約1.2兆のマルチモーダルトークンで広範な事前トレーニングを受け、その後、パフォーマンスと堅牢性を向上させるために、マルチティーチャーOPD、反復防止MrDPO、専門的強化学習などの高度なポストトレーニング技術が適用されました。

デプロイメントと統合は、さまざまなサービングオプションを通じて容易に行えます。ユーザーはTransformers環境を設定し、WeMM-Videoリポジトリから直接例を実行できます。このモデルは、FP8 Block128、AWQ W4A16、GGUF Q4_K_M、NVFP4 W4A16などの量子化されたバリアントをサポートしています。サービングには、vLLM(0.18.0および0.31.0)のパッチ版およびSGLang(0.5.16または0.5.19)と互換性があり、複数のGPUにわたるテンソル並列処理を含む効率的な推論を可能にします。また、デフォルトのインストラクトモードと推論応答用の「思考モード」を含むさまざまなチャットモードも提供しています。

WeMM-Video-35B-A3Bは、強力なパフォーマンスを示し、新しいオープンソースの最先端を確立しました。Qwen3.5-Omni-FlashやSeed2.0-Mini-0428などのプロプライエタリモデルを上回り、Gemini-3.0-Flashなどの高度なモデルとのパフォーマンスギャップを大幅に縮小することが示されています。このモデルはApache License 2.0の下でリリースされており、AIコミュニティ内でのオープンアクセスとコラボレーションを促進しています。

  • カテゴリーAIモデルとLLM
  • 料金モデルオープンソース
  • デプロイクラウド
  • プラットフォームWeb

  • 中英バイリンガル処理

  • 音声と視覚の共同理解と推論

  • テキスト、画像、音声、動画の入力を受け付ける

  • テキスト応答を生成する

  • 動画フレームとサウンドトラックからイベントを説明する

  • 音声からスピーチを文字起こしする

  • 視覚情報と聴覚情報について推論する

  • サイレント動画とスタンドアロン音声の処理をサポートする

  • ミクスチャー・オブ・エキスパートアーキテクチャ(合計35B、アクティブパラメータ3B)

  • 1.2兆のマルチモーダルトークンで事前トレーニング済み

  • マルチティーチャーOPDおよびMrDPOでポストトレーニング済み

  • パフォーマンス向上のための専門的強化学習

  • さまざまな量子化バリアントをサポート(FP8、AWQ、GGUF、NVFP4)

  • サービング用にパッチされたvLLMおよびSGLangと互換性がある

  • インストラクトおよび思考チャットモードを提供

  1. 環境の設定: Transformers環境と必要な依存関係をインストールします。

  2. モデルの読み込み: Hugging Face HubからWeMM-Video-35B-A3Bモデルとプロセッサを読み込みます。

  3. 入力の準備: MP4動画ファイル、スタンドアロン音声、画像、またはテキストなどのメディア入力を提供します。

  4. メディアの処理: スクリプトを使用して、動画フレームを元の音声トラックと共に処理します。

  5. 応答の生成: モデルにリクエストを送信し、テキスト生成のためにチャットモード(インストラクトまたは思考)を指定します。

  6. モデルの提供(オプション): WeMMランタイムパッチをインストールし、APIサービングのためにパッチされたvLLMまたはSGLangを使用します。

  7. APIリクエストの送信: バンドルされたリクエストクライアントを使用して、メディアをOpenAI互換のチャットエンドポイントにインラインで送信します。

  • 動画コンテンツ分析
  • スピーチ文字起こし
  • マルチモーダル推論
  • バイリンガルコンテンツ処理
  • 音声視覚イベント説明
  • AIモデル開発
  • 研究と実験

WeMM-Video-35B-A3B に似た人気のAIツール

Llama-3.2-11B-Vision-Instructは、視覚認識、画像推論、キャプショニングのために設計されたマルチモーダルAIモデルです。Metaによって開発され、テキストと画像の入力を統合して高度な画像理解能力を提供します。

AIモデルとLLM
ツールを見る

視覚認識、画像推論、キャプショニングのために設計されたマルチモーダルAIモデルです。Metaによって開発され、テキストと画像の入力を統合して高度な画像理解能力を提供します。Llama-3.2-11B-Vision-Instructは、視覚認識、画像推論、キャプショニングのために設計されたマルチモーダルAIモデルです。Metaによって開発され、テキストと画像の入力を統合して高度な画像理解能力を提供します。

AIモデルとLLM
AI モデル トップ5を見る

ステップ 3.7 フラッシュは、高頻度の生産ワークロード向けに設計されたスパースなMixture-of-Expertsビジョン・ランゲージモデルです。言語バックボーンとビジョンエンコーダーを組み合わせて、財務報告の解析やマルチステップ検索ループの実行などの集中的なタスクをサポートします。

AIモデルとLLM

LLMで第81位

ツールを見る

高頻度の生産ワークロード向けに設計されたスパースなMixture-of-Expertsビジョン・ランゲージモデルです。言語バックボーンとビジョンエンコーダーを組み合わせて、財務報告の解析やマルチステップ検索ループの実行などの集中的なタスクをサポートします。ステップ 3.7 フラッシュは、高頻度の生産ワークロード向けに設計されたスパースなMixture-of-Expertsビジョン・ランゲージモデルです。言語バックボーンとビジョンエンコーダーを組み合わせて、財務報告の解析やマルチステップ検索ループの実行などの集中的なタスクをサポートします。

AIモデルとLLM
LLMで第81位

Apertus 1.5は、多言語対応のマルチモーダル言語モデルのファミリーであり、幅広い言語とコンテキストをサポートするように設計されています。オープンソースアクセスと改善された推論能力を提供し、多様なAIアプリケーションに適しています。

AIモデルとLLM

LLMで第72位

ツールを見る

多言語対応のマルチモーダル言語モデルのファミリーであり、幅広い言語とコンテキストをサポートするように設計されています。オープンソースアクセスと改善された推論能力を提供し、多様なAIアプリケーションに適しています。Apertus 1.5は、多言語対応のマルチモーダル言語モデルのファミリーであり、幅広い言語とコンテキストをサポートするように設計されています。オープンソースアクセスと改善された推論能力を提供し、多様なAIアプリケーションに適しています。

AIモデルとLLM
LLMで第72位

Llama-4 Maverick 17B-128E Instructは、Metaによって開発されたマルチモーダルAIモデルで、高度なテキストおよび画像理解のために設計されています。さまざまなアプリケーションで高いパフォーマンスを発揮するために、エキスパートの混合アーキテクチャを活用しています。

AIモデルとLLM
ツールを見る

Metaによって開発されたマルチモーダルAIモデルで、高度なテキストおよび画像理解のために設計されています。さまざまなアプリケーションで高いパフォーマンスを発揮するために、エキスパートの混合アーキテクチャを活用しています。Llama-4 Maverick 17B-128E Instructは、Metaによって開発されたマルチモーダルAIモデルで、高度なテキストおよび画像理解のために設計されています。さまざまなアプリケーションで高いパフォーマンスを発揮するために、エキスパートの混合アーキテクチャを活用しています。

AIモデルとLLM
AI モデル トップ5を見る

Nemotron-Labs-Audex-2Bは、理解、認識、翻訳などの音声タスクのために設計された統合音声テキスト大規模言語モデルです。思考モードと指示モードの両方をサポートし、多様な音声およびテキストアプリケーションに対してコンパクトで効率的なソリューションを提供します。

AIモデルとLLM

LLMで第33位

ツールを見る

理解、認識、翻訳などの音声タスクのために設計された統合音声テキスト大規模言語モデルです。思考モードと指示モードの両方をサポートし、多様な音声およびテキストアプリケーションに対してコンパクトで効率的なソリューションを提供します。Nemotron-Labs-Audex-2Bは、理解、認識、翻訳などの音声タスクのために設計された統合音声テキスト大規模言語モデルです。思考モードと指示モードの両方をサポートし、多様な音声およびテキストアプリケーションに対してコンパクトで効率的なソリューションを提供します。

AIモデルとLLM
LLMで第33位

Gemini 3.1 Proは、複雑なタスクと深い推論のために設計された高度なAIモデルです。マルチモーダル理解に優れ、スマートで簡潔な応答を提供し、学習、計画、革新的なアプリケーションの構築に最適です。

AIモデルとLLM
ツールを見る

複雑なタスクと深い推論のために設計された高度なAIモデルです。マルチモーダル理解に優れ、スマートで簡潔な応答を提供し、学習、計画、革新的なアプリケーションの構築に最適です。Gemini 3.1 Proは、複雑なタスクと深い推論のために設計された高度なAIモデルです。マルチモーダル理解に優れ、スマートで簡潔な応答を提供し、学習、計画、革新的なアプリケーションの構築に最適です。

注目AIモデルとLLM
AI モデル トップ5を見る

Llama-4-Scout-17B-16E-Instructは、Metaによって設計されたマルチモーダルAIモデルです。専門家の混合アーキテクチャを活用して、先進的なテキストおよび画像理解機能を提供し、多言語出力と多様なアプリケーション向けのファインチューニングをサポートします。

AIモデルとLLM
ツールを見る

Metaによって設計されたマルチモーダルAIモデルです。専門家の混合アーキテクチャを活用して、先進的なテキストおよび画像理解機能を提供し、多言語出力と多様なアプリケーション向けのファインチューニングをサポートします。Llama-4-Scout-17B-16E-Instructは、Metaによって設計されたマルチモーダルAIモデルです。専門家の混合アーキテクチャを活用して、先進的なテキストおよび画像理解機能を提供し、多言語出力と多様なアプリケーション向けのファインチューニングをサポートします。

AIモデルとLLM
AI モデル トップ5を見る

Qwen3-VL

AI GitHub リポジトリ

Qwen3-VLは、Alibaba CloudのQwenチームによるビジョン・ランゲージモデルシリーズで、DenseおよびMixture-of-Expertsサイズで、指示版と推論版("Thinking")がリリースされています。画像、動画、テキストを同時に読み取り、ネイティブの256Kコンテキストウィンドウを持ち、1Mまで拡張可能で、GUI自動化、OCR、…

AIモデルとLLM
ツールを見る

AI GitHub リポジトリ

Alibaba CloudのQwenチームによるビジョン・ランゲージモデルシリーズで、DenseおよびMixture-of-Expertsサイズで、指示版と推論版("Thinking")がリリースされています。画像、動画、テキストを同時に読み取り、ネイティブの256Kコンテキストウィンドウを持ち、1Mまで拡張可能で、GUI自動化、OCR、…Qwen3-VLは、Alibaba CloudのQwenチームによるビジョン・ランゲージモデルシリーズで、DenseおよびMixture-of-Expertsサイズで、指示版と推論版("Thinking")がリリースされています。画像、動画、テキストを同時に読み取り、ネイティブの256Kコンテキストウィンドウを持ち、1Mまで拡張可能で、GUI自動化、OCR、…

AIモデルとLLM
AI GitHub リポジトリ トップ250を見る
1 / 8