説明
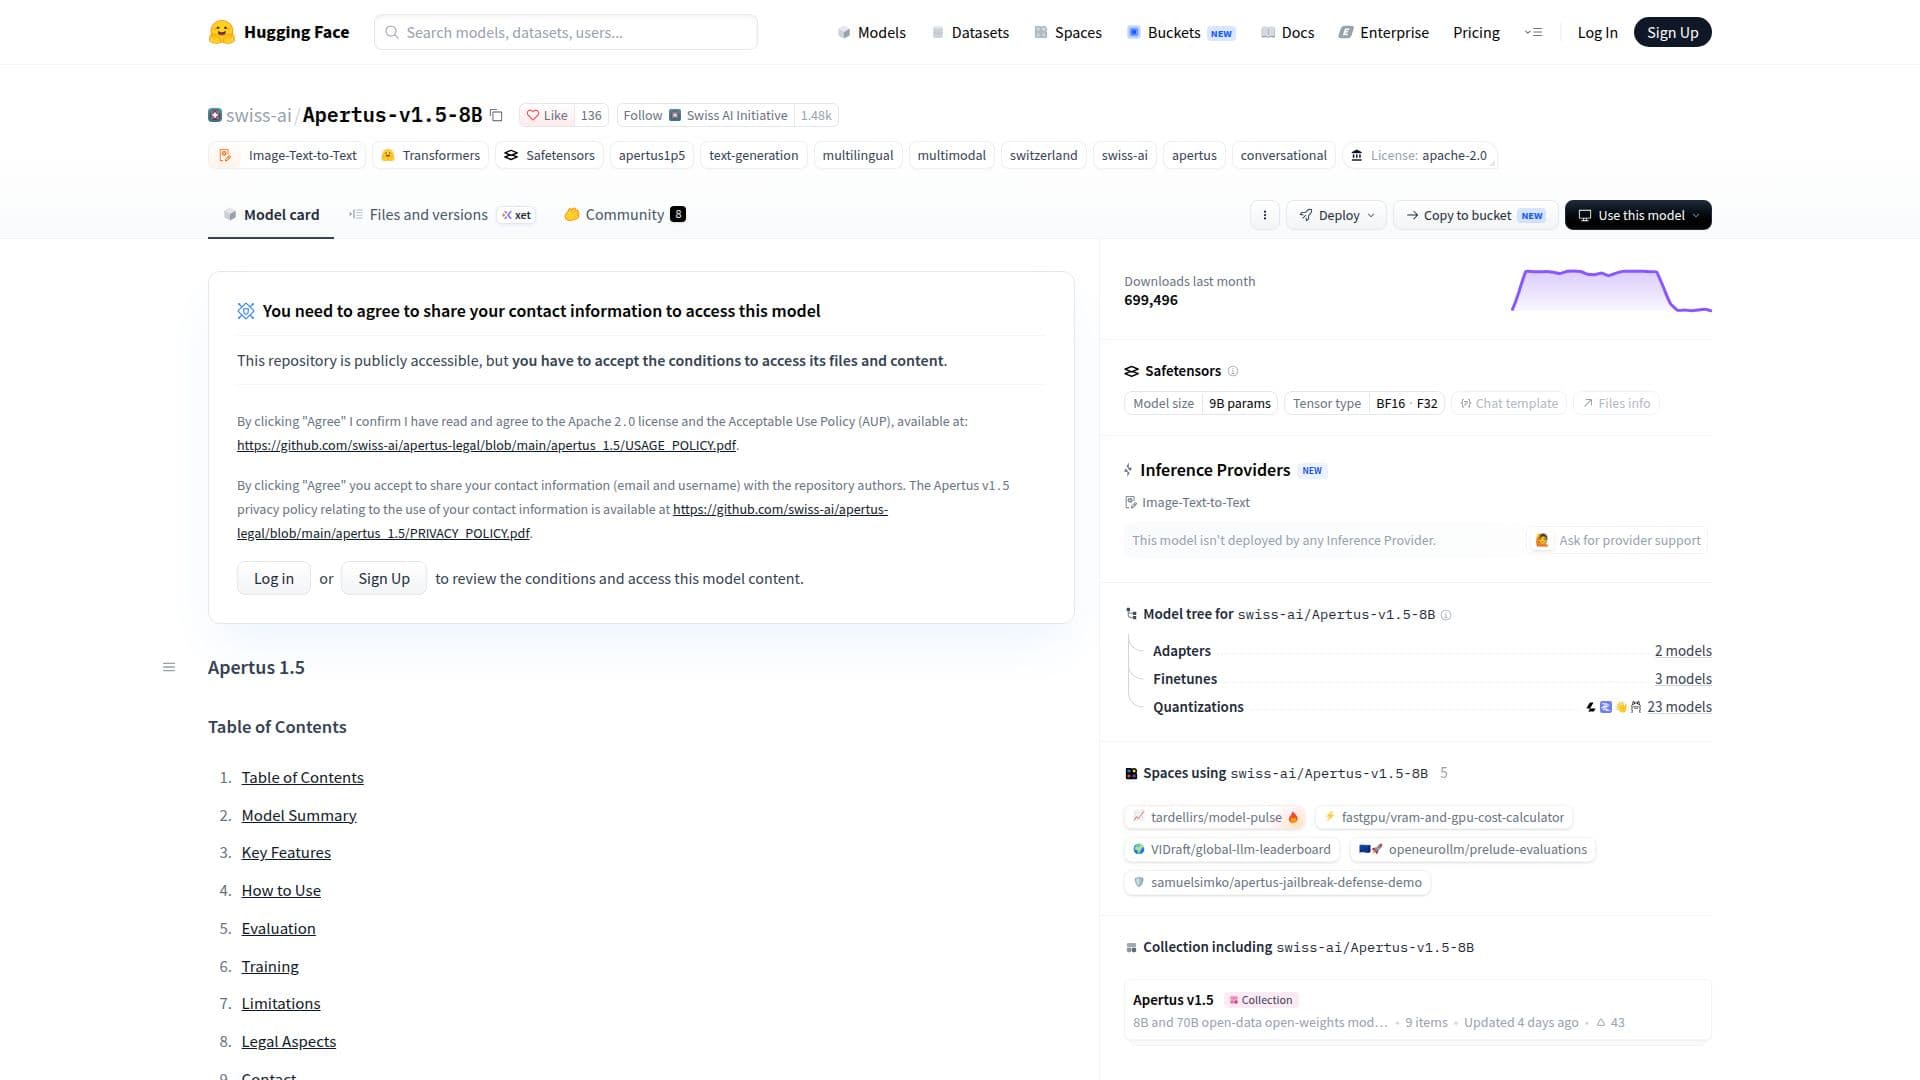
Apertus 1.5は、多言語およびマルチモーダルAI機能を強化するために開発された高度な言語モデルのシリーズです。8億および700億のパラメータを持つモデルを備え、Apertus 1.5は幅広い言語をサポートし、最大262,144トークンのコンテキストを処理できます。これにより、テキスト生成から複雑な推論タスクまで、さまざまなアプリケーションに非常に柔軟に対応できます。
続きを読む
モデルはデコーダー専用のトランスフォーマーアーキテクチャに基づいて構築されており、8Bモデルには4兆トークン、70Bモデルには2兆トークンのマルチモーダルデータを使用して事前トレーニングされています。この広範なトレーニングにより、Apertus 1.5は画像、音声、テキスト入力からテキストを処理および生成でき、開発者に革新的なアプリケーションを作成する新しい可能性を提供します。
Apertus 1.5は、責任ある開発を考慮して設計されており、データ所有者のオプトアウト同意を尊重し、トレーニングデータの記憶を防ぐ方法を採用しています。モデルは完全にオープンであり、オープンウェイト、データ、およびトレーニングの詳細が一般に公開されており、透明性とアクセス可能性を確保しています。
モデルはまた、推論能力を強化する「思考モード」を導入しており、より正確で文脈に応じた応答を可能にします。この機能は、改善された指示遵守およびツール使用能力と組み合わさることで、開発者が高度なAI機能をプロジェクトに統合するための強力なツールとなります。
Apertus 1.5の展開は、TransformersやvLLMなどのオープンソースフレームワークでサポートされており、開始するための詳細な手順が提供されています。モデルはデスクトップおよびクラウド環境の両方で使用可能であり、さまざまな展開シナリオに柔軟性を提供します。
- カテゴリーAIモデルとLLM
- 料金モデルオープンソース
- デプロイクラウド, セルフホスト
- プラットフォームWeb
Apertus 1.5のハイライト
多言語サポート
マルチモーダル入力処理
オープンソースアクセス
長いコンテキスト処理
改善された推論能力
強化された指示遵守
ツール使用統合
責任あるデータ処理
Apertus 1.5をはじめる
モデルページにアクセス: Hugging FaceのApertus 1.5ページを訪問
認証: モデルにアクセスするためにログインまたはサインアップ
設定: モデルのパラメータと環境を設定
プロンプトを送信: 処理するためにテキスト、画像、または音声を入力
ファインチューニング: 特定のタスクに合わせてモデル設定を調整
Apertus 1.5の使用例
- 多言語テキスト生成
- マルチモーダルコンテンツ作成
- 高度な推論タスク
- 指示遵守
- ツール統合