説明
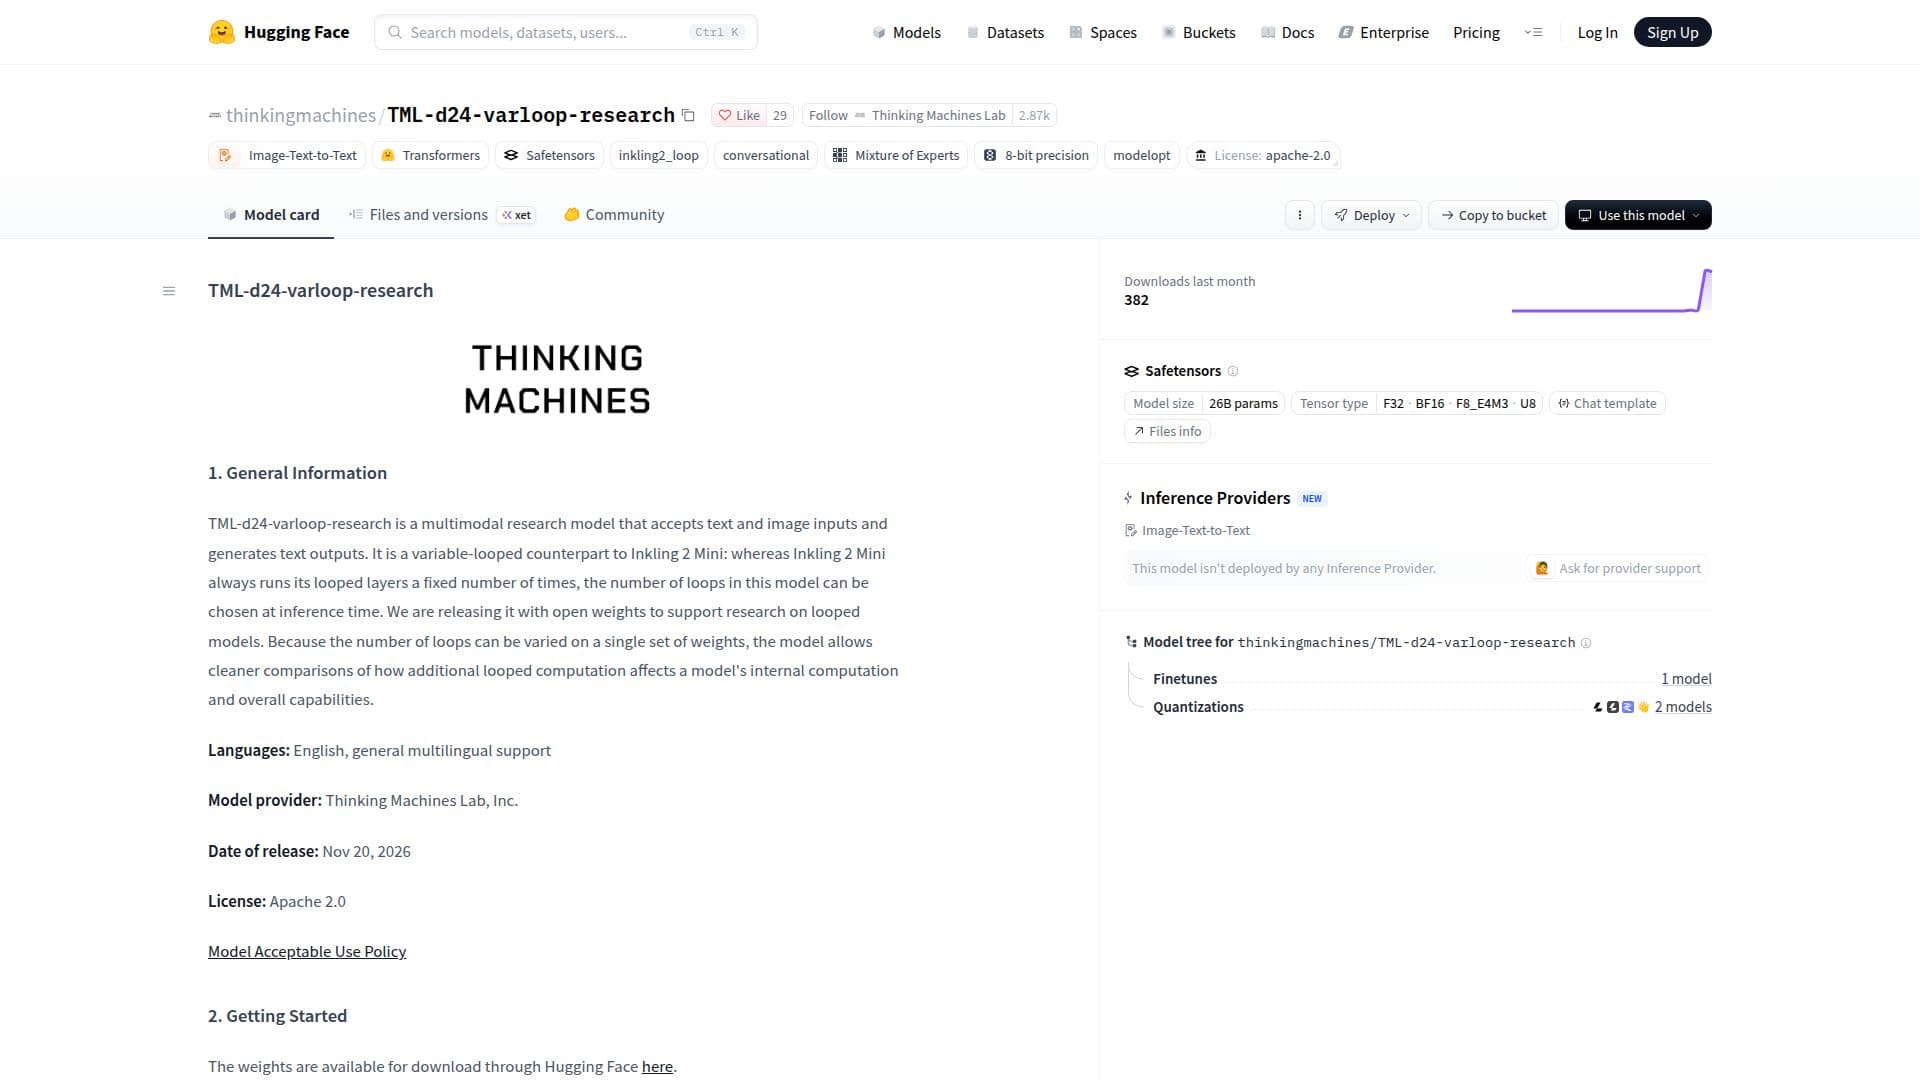
TML-d24-varloop-researchは、Thinking Machines Lab, Inc.によって開発されたマルチモーダル研究モデルで、テキストと画像の入力を処理し、テキスト出力を生成するように設計されています。2026年11月20日にApache 2.0ライセンスの下でリリースされたこのモデルは、ループモデルの分野における重要な貢献であり、固定ループのInkling 2 Miniとは異なる可変ループアーキテクチャを提供します。研究者は推論中にループの数を動的に調整でき、追加の計算がモデルの内部プロセスや全体的な能力に与える影響をより明確に比較できます。
続きを読む
このモデルは、Hugging Faceを通じてオープンウェイトとして配布されており、単一のチェックポイントサイズは約20GBです。NVIDIA DGX Spark、NVIDIA GPU(例:GeForce RTX 5090またはRTX PRO 6000 Blackwell)、またはAppleシリコンMacなど、少なくとも32GBのGPUまたは統合メモリを備えたマシンが必要です。TML-d24-varloop-researchは、Hugging Face、SGLang、vLLM、TokenSpeed、NVIDIA Dynamo、Unsloth、llama.cpp、Llama App、Ollama、Exo Labsなどのさまざまなフレームワークを使用してローカル推論をサポートします。また、MilesおよびSkyRLを使用したポストトレーニングもサポートしています。
アーキテクチャ的には、TML-d24-varloop-researchは、スパースMixture-of-Experts(MoE)フィードフォワード層を持つ24層のデコーダー専用トランスフォーマーです。中央の12層は可変回数実行でき、重みを共有し、1から5回のパスでトレーニングされました。各層は128の専門家のうち8つにトークンをルーティングし、注意はローカル層とグローバル層のハイブリッドです。このモデルはネイティブにマルチモーダルであり、ビジョントランスフォーマーを介して画像をエンコードし、テキストと共有された隠れ空間で共同処理します。26.4億のパラメータ(1パスで3.4億がアクティブ)を特徴とし、NVFP4およびMXFP8数値をサポートします。UTF-8エンコードされたテキストとピクセルベースの画像入力(各次元40pxから4096px)を処理し、最大1百万トークンのコンテキストウィンドウを持ちます。
TML-d24-varloop-researchのトレーニングデータには、公開されているソース、サードパーティの取得、内部/合成生成データからのさまざまなコンテンツタイプが含まれています。データのキュレーションには、品質と安全性を確保するためのクリーニング、重複排除、フィルタリングが含まれました。このモデルは、Inkling 2 Miniと共に事前トレーニングと中間トレーニングの最初の段階を共有していますが、特に可変ループトレーニングにおいて後の段階で分岐します。評価は、Agentic Coding、Vision Interpretation、ReasoningなどのベンチマークにおいてInkling 2 Miniと比較して異なるパフォーマンスを示していますが、主に研究用のアーティファクトとして意図されており、異なるパス数での予測不可能な動作や、ハルシネーションやトレーニングデータからのバイアスなど、基盤モデルに共通する一般的な制限のため、製品用途には推奨されません。
- カテゴリーAIモデルとLLM
- 料金モデルオープンソース
- デプロイローカルで実行
- プラットフォームWeb
TML-d24-varloop-researchのハイライト
マルチモーダル入力:テキストと画像の入力を受け付けます
テキスト出力:入力に基づいてテキストを生成します
可変ループ:推論時にループ層の数を選択できます
オープンウェイト:研究を支援するためにダウンロード可能です
26.4億のパラメータ:1パスで3.4Bのアクティブパラメータを持つ大規模モデル
多言語サポート:複数の言語に対する一般的なサポート
Apache 2.0ライセンス:使用と変更のためのオープンソースライセンス
ローカル推論サポート:Hugging Face、SGLang、vLLM、TokenSpeed、NVIDIA Dynamo、Unsloth、llama.cpp、Llama App、Ollama、Exo Labsに対応
ポストトレーニングサポート:MilesおよびSkyRLでポストトレーニング可能
スパースMixture-of-Experts(MoE):MoEフィードフォワード層を利用
ハイブリッド注意:ローカルおよびグローバルな注意層を組み合わせ
ネイティブマルチモーダリティ:ビジョントランスフォーマーを介して画像をエンコードし、テキストと共同処理
高コンテキストウィンドウ:最大1百万トークンをサポート
混合精度数値:NVFP4およびMXFP8をサポート
TML-d24-varloop-researchをはじめる
ウェイトのダウンロード:Hugging Faceを通じてモデルのウェイトにアクセスします。
ハードウェアの準備:少なくとも32GBのGPUまたは統合メモリを備えた単一のマシンを用意します。
ソフトウェアのインストール:Hugging Face、SGLang、またはvLLMなどの必要な推論フレームワークとその依存関係を設定します。
モデルの構成:選択したフレームワークに20GBのチェックポイントをロードします。
ループパスの設定:推論のために希望するループ層の数を選択します。
入力の提供:UTF-8エンコードされたテキストとピクセルベースの画像(40px-4096pxの寸法)をモデルに供給します。
出力の生成:提供された入力に基づいてモデルからテキスト出力を受け取ります。
TML-d24-varloop-researchの使用例
- マルチモーダル研究
- ループモデル研究
- 画像からのテキスト生成
- 多言語テキスト処理
- オープンウェイトモデル開発
- ローカル推論展開
- モデルのファインチューニング