説明
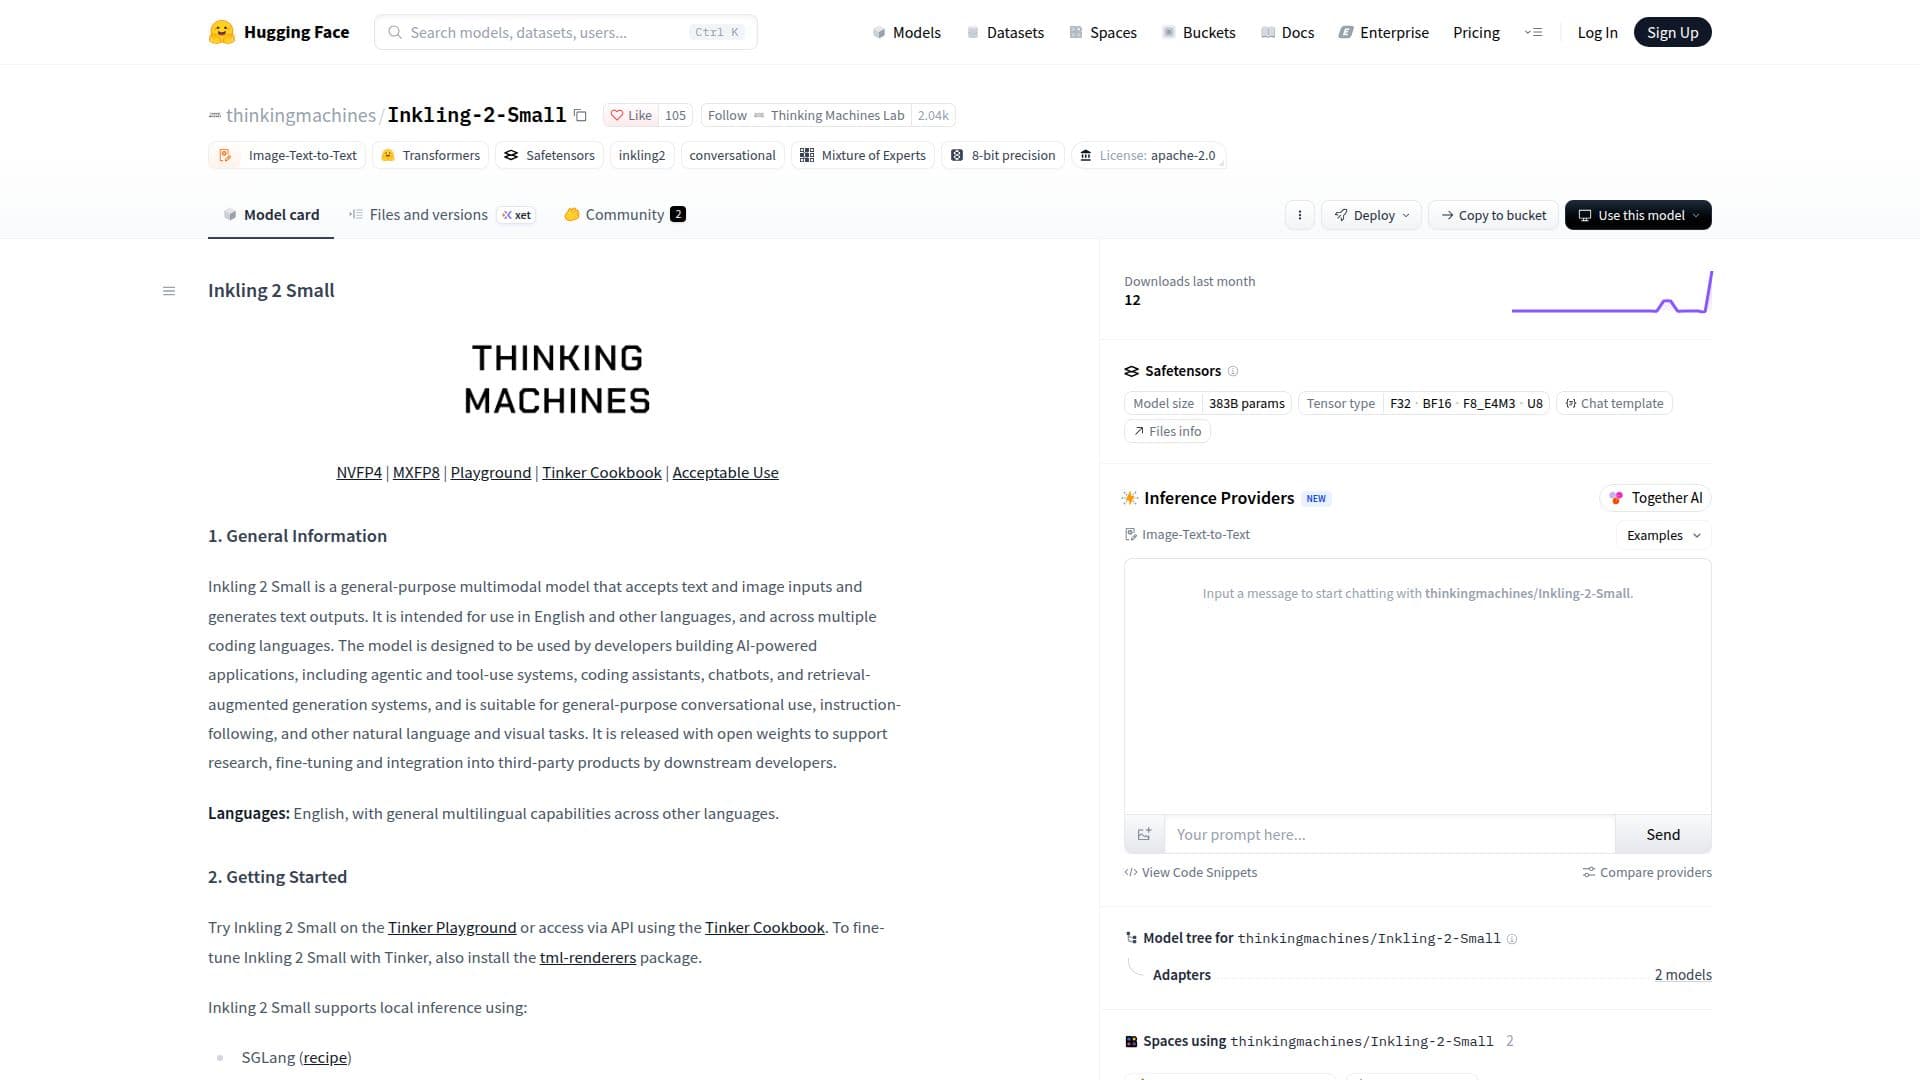
Inkling 2 Smallは、テキストと画像の入力を処理してテキスト出力を生成することができる多用途のマルチモーダルモデルです。広範な適用性を考慮して設計されており、英語や他の言語、さまざまなコーディング言語をサポートしています。このモデルは、エージェントシステムやツール使用システム、コーディングアシスタント、チャットボット、検索強化生成(RAG)システムなど、AI駆動のアプリケーションを構築する開発者を特に対象としています。また、一般的な会話インタラクション、指示に従うタスク、さまざまな自然言語および視覚タスクにも適しています。
続きを読む
オープンウェイトでリリースされたInkling 2 Smallは、研究、ファインチューニング、サードパーティ製品への統合を促進します。ユーザーはTinker Playgroundでモデルを試したり、Tinker Cookbookを使用してAPI経由でアクセスしたりできます。Tinkerでのファインチューニングには、tml-renderersパッケージが必要です。このモデルは、SGLang、vLLM、TokenSpeed、Unslothなどのさまざまなフレームワークを通じてローカル推論をサポートしています。さらに、Miles、SkyRL、Snowflake Cortex Trainingを使用してポストトレーニングが可能です。APIアクセスは、NVIDIA、Fireworks、Together、Baseten、Nebius、Modal、Cloudflareなどのサードパーティ推論プロバイダーを通じても利用できます。
Inkling 2 Smallのハードウェア要件は、チェックポイント形式によって異なります。主要なNVFP4チェックポイントは、合計500GBのVRAMを持つGPUクラスターを必要とし、2x NVIDIA B300 GPUまたは4x NVIDIA H200 GPUなどの構成で実現可能です。代替のMXFP8チェックポイントは、合計800GBのVRAMを必要とし、4x NVIDIA B300 GPUまたは8x NVIDIA H200 GPUで満たされます。NVFP4チェックポイントは、モデルのネイティブ精度であり、最適なパフォーマンスを提供するため、すべてのユースケースに推奨されます。
アーキテクチャ的に、Inkling 2 Smallはマルチモーダル自己回帰トランスフォーマーです。48層のデコーダ専用トランスフォーマーを備え、384の専門家のうち8つに各トークンがルーティングされるスパースMixture-of-Experts(MoE)フィードフォワードバックボーンを特徴としています。その注意メカニズムは、ローカルおよびグローバルレイヤーを組み合わせています。このモデルはネイティブにマルチモーダルであり、ビジョントランスフォーマーを介して画像をエンコードし、デコーダによる共同処理のために画像とテキストの入力を共有の隠れ空間に投影します。最大1百万トークンのコンテキストウィンドウをサポートし、UTF-8エンコーディングのテキストと、理想的には各次元が40pxから4096pxの範囲のピクセルベースの画像フォーマットを受け入れます。出力はUTF-8エンコードされたテキストとして生成されます。
Inkling 2 Smallのトレーニングデータには、テキスト、画像、ビデオなどの多様なコンテンツタイプが含まれており、公開されているリポジトリ、サードパーティ、内部生成、合成拡張から取得されています。データキュレーションプロセスには、データセットのクリーンアップ、処理、修正が含まれ、重複排除や品質と安全性のフィルタリングが行われます。安全性評価は、日常的な人間とAIのインタラクションや危険な能力テストにおいて実施され、リスクを軽減するための対策が適用されました。モデルの知識はトレーニングのカットオフに制限されており、高リスクのアプリケーションには、ハルシネーションやトレーニングデータからのバイアスなどの潜在的な制限があるため、人間の監視を適用することが推奨されます。
- カテゴリーAIモデルとLLM
- 料金モデルオープンソース
- デプロイクラウド, セルフホスト
- プラットフォームWeb
Inkling 2 Smallのハイライト
マルチモーダル入力:テキストと画像の両方の入力を受け付ける
テキスト出力:UTF-8エンコードされたテキスト出力を生成する
汎用モデル:幅広いアプリケーションに適している
多言語対応:英語や他の言語をサポート
複数のコーディング言語サポート:さまざまなコーディング言語で動作
オープンウェイト:研究、ファインチューニング、統合のために利用可能
APIアクセス:Tinker Cookbookおよびサードパーティプロバイダーを介してアクセス可能
ローカル推論サポート:SGLang、vLLM、TokenSpeed、Unslothと互換性がある
ポストトレーニングオプション:Miles、SkyRL、Snowflake Cortex Trainingでポストトレーニング可能
自己回帰トランスフォーマー:48層のデコーダ専用アーキテクチャを利用
Mixture-of-Experts(MoE):384の専門家を持つスパースフィードフォワードバックボーン
共有隠れ空間:画像とテキストの入力を共同で処理
コンテキストウィンドウ:最大1百万トークンをサポート
高パラメータ数:合計594Bパラメータ、17Bアクティブ
Inkling 2 Smallをはじめる
モデルにアクセス:Hugging FaceのInkling 2 Smallページを訪問してください。
プレイグラウンドを試す:Tinker Playgroundでモデルを直接試してみてください。
API経由でアクセス:Tinker Cookbookを使用してAPIを介してモデルを統合します。
モデルをファインチューニング:tml-renderersパッケージをインストールして、TinkerでInkling 2 Smallをファインチューニングします。
ローカル推論:SGLang、vLLM、TokenSpeed、またはUnslothなどのフレームワークを利用してローカル展開を行います。
ポストトレーニング:Miles、SkyRL、またはSnowflake Cortex Trainingでモデルを強化します。
プロバイダーと共に展開:NVIDIAやFireworksなどのサードパーティ推論プロバイダーを介してAPIにアクセスします。
ハードウェアを構成:NVFP4チェックポイントには少なくとも500GBのVRAM、MXFP8チェックポイントには少なくとも800GBのVRAMを持つGPUクラスターを確保してください。
Inkling 2 Smallの使用例
- AIアプリケーションの構築
- エージェンティックシステムの開発
- コーディングアシスタント
- チャットボットの作成
- 検索強化生成
- 一般的な会話利用
- 指示に従う
- 視覚タスク
- 研究と実験
- サードパーティ製品の統合