説明
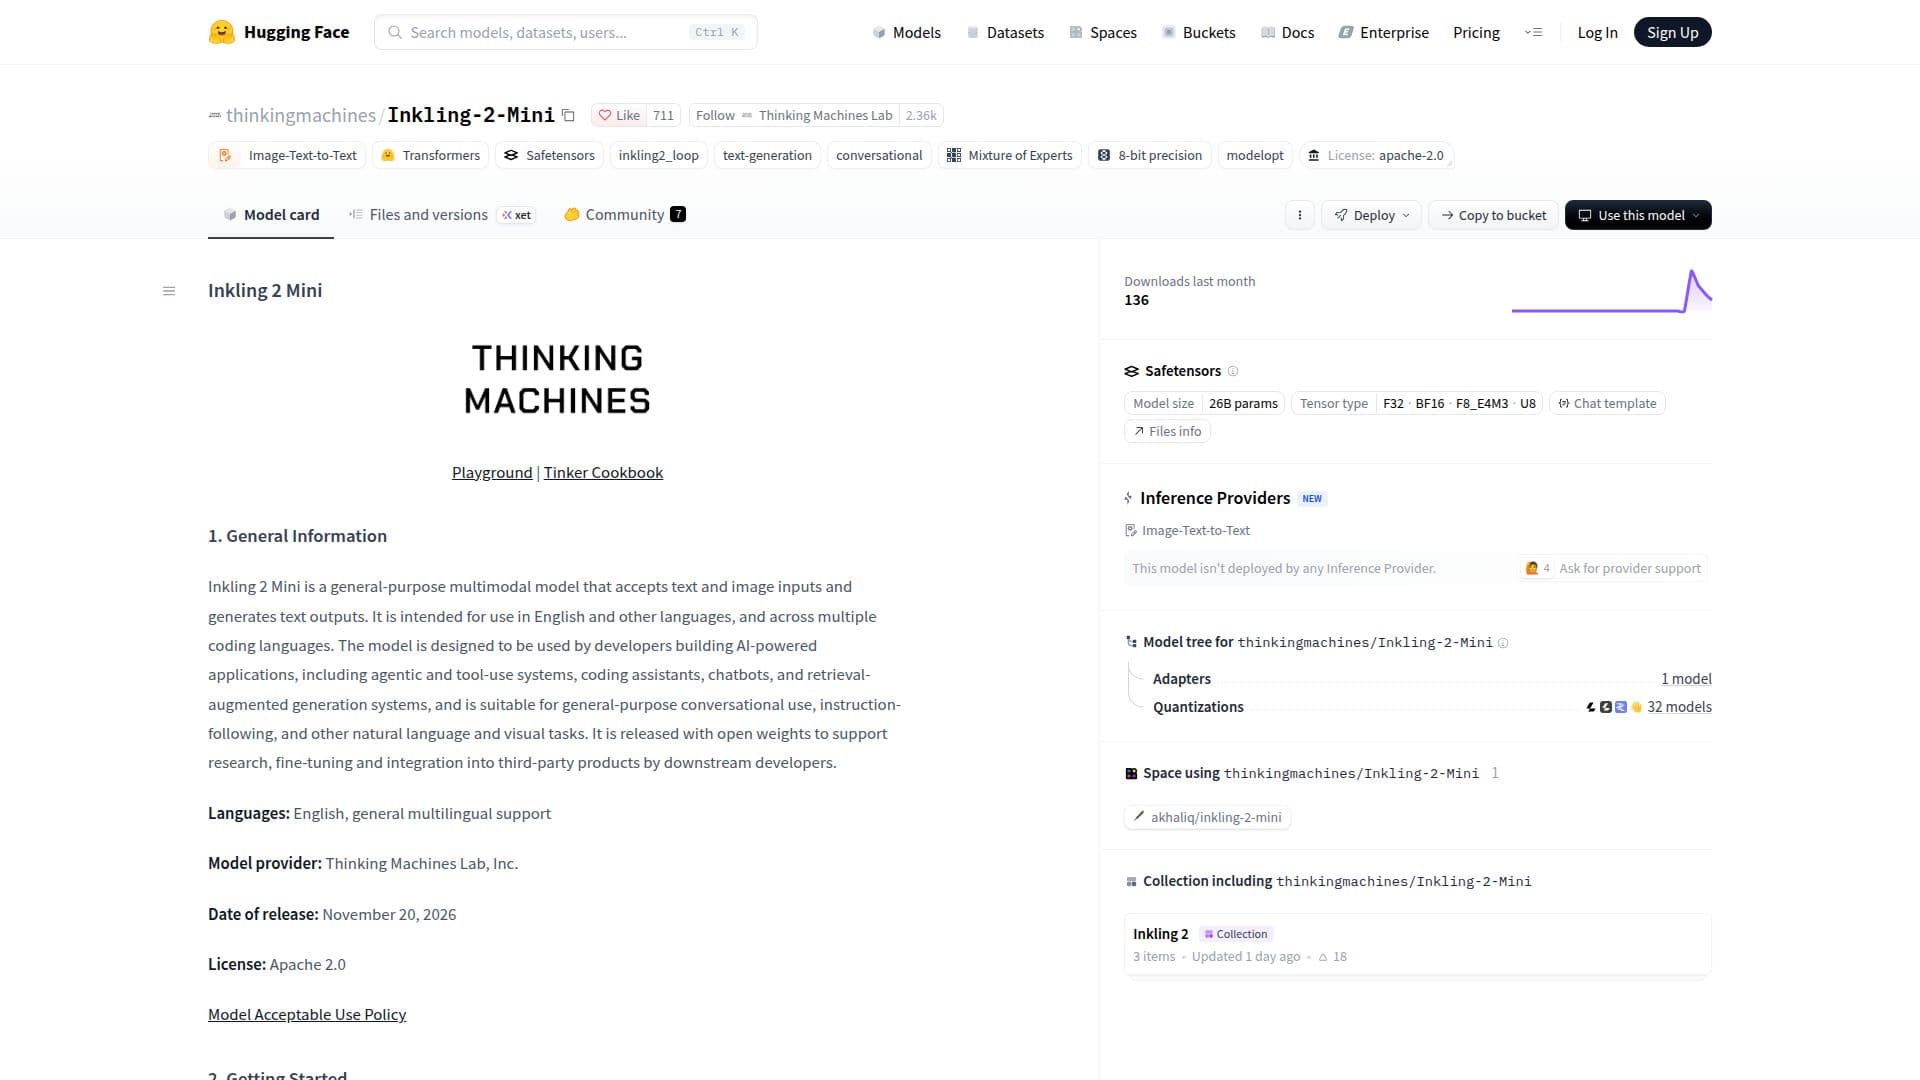
Inkling 2 Miniは、テキストと画像の入力を処理し、その後テキスト出力を生成するために設計された多用途のマルチモーダルモデルです。Thinking Machines Lab, Inc.によって開発されたこのモデルは、広範な適用性を持ち、英語や他の言語、さらには複数のコーディング言語をサポートしています。特に、エージェントシステムやツール使用システム、コーディングアシスタント、チャットボット、情報強化生成(RAG)システムなどのAI駆動アプリケーションを構築する開発者に適しています。さらに、一般的な会話の使用、指示の実行、さまざまな自然言語および視覚タスクにも対応可能です。
続きを読む
このモデルは、Apache 2.0ライセンスの下でオープンウェイトとしてリリースされており、研究、ファインチューニング、サードパーティ製品への統合を促進します。約20GBの単一チェックポイントとして配布され、混合NVFP4およびMXFP8精度を利用しています。このコンパクトなサイズにより、1x NVIDIA DGX Spark、32GB以上のメモリを持つAppleシリコンデバイス(MacBook、Mac mini、Studio)や、推奨される32GB以上のVRAMを持つ他のGPUでのローカル推論が可能です。
Inkling 2 Miniは、Hugging Face、SGLang、vLLM、TokenSpeed、NVIDIA Dynamo、Unsloth(量子化GGUFバージョンを含む)、llama.cpp(量子化GGUFバージョン用)、Llama App、Ollama、Exo Labs(Appleシリコン上)など、複数のフレームワークを通じてローカル推論をサポートしています。また、MilesおよびSkyRLでのポストトレーニングも可能です。このモデルは、スパースMixture-of-Experts(MoE)フィードフォワード層を持つ24層のデコーダ専用トランスフォーマーアーキテクチャを特徴としています。中央の12層は、共有ウェイトで3回実行され、24層のウェイトからトークンごとに48層の適用を効果的に提供します。各層は128の専門家のうち8にトークンをルーティングし、注意はローカルおよびグローバル層のハイブリッドです。画像はビジョントランスフォーマーを介してエンコードされ、画像とテキストの入力はデコーダによる共同処理のために共有された隠れ空間に投影されます。このモデルは264億のパラメータを持ち、34億のアクティブパラメータを有し、最大100万トークンのコンテキストウィンドウをサポートします。
Inkling 2 Miniのトレーニングデータは、公開されているリポジトリ、サードパーティの取得、内部生成、合成拡張から得られたテキスト、画像、動画など、さまざまなコンテンツタイプを含んでいます。データのキュレーションには、データセットのクリーンアップ、処理、修正が含まれ、重複排除や品質と安全性のフィルタリングが行われます。安全性評価は、日常的な人間とAIの相互作用や危険な能力のテストをカバーし、整合性トレーニングを通じて緩和策が適用されました。このモデルの制限には、潜在的な幻覚、時折の指示実行の失敗、長い会話でのパフォーマンスの低下、トレーニングデータからのバイアスが含まれます。事実の記憶や知識が重視される質問においては、より大きなモデルよりも能力が劣り、特に非英語の言語では繰り返しの推論やエージェントの信頼性の欠如が見られることがあります。開発者には、人間の監視を適用し、エージェントの作業をサンドボックスで実行し、展開前に独立した評価を行うことが推奨されます。
- カテゴリーAIモデルとLLM
- 料金モデルオープンソース
- デプロイローカルで実行
- プラットフォームWeb
Inkling 2 Miniのハイライト
マルチモーダル入力:テキストと画像の入力を受け付けて処理します。
テキスト出力生成:マルチモーダル入力に基づいてテキスト出力を生成します。
汎用モデル:幅広いアプリケーションやタスクに対応するように設計されています。
多言語サポート:英語および他の言語で機能します。
複数のコーディング言語サポート:さまざまなコーディング環境で互換性があります。
オープンウェイトリリース:オープンウェイトでダウンロードおよび使用可能です。
Apache 2.0ライセンス:研究、ファインチューニング、統合の柔軟性を提供します。
開発者向け:AI駆動アプリケーションの構築を目的としています。
エージェントシステムサポート:エージェントおよびツール使用システムの開発に適しています。
コーディングアシスタント機能:コーディングアシスタントを作成するために使用できます。
チャットボット統合:チャットボットの開発を促進します。
情報強化生成(RAG)システム:RAGシステムの作成をサポートします。
ローカル推論機能:指定されたハードウェアでローカルAIコンピュートを実行できます。
広範なフレームワークサポート:Hugging Face、SGLang、vLLMなどと互換性があります。
ポストトレーニングオプション:MilesおよびSkyRLでポストトレーニングが可能です。
大きなコンテキストウィンドウ:最大100万トークンをサポートします。
Inkling 2 Miniをはじめる
モデルウェイトのダウンロード:Hugging FaceからInkling 2 Miniのウェイトにアクセスしてダウンロードします。
Tinkerプラットフォーム経由でのアクセス:APIアクセスとモデルインタラクションのためにTinkerファインチューニングプラットフォームを利用します。
Tinkerレンダラーのインストール:Tinkerプラットフォーム統合のためにtml-renderersパッケージをインストールします。
ローカルハードウェアの構成:必要なハードウェア(例:NVIDIA DGX Spark、32GB以上のメモリを持つAppleシリコン)が利用可能であることを確認します。
ソフトウェアフレームワークのインストール:Hugging Face、SGLang、またはllama.cppなどのサポートされているローカル推論フレームワークを設定します。
推論の実行:選択したフレームワークを使用して、画像とテキスト入力からのテキスト生成のためにモデルをローカルで実行します。
Inkling 2 Miniの使用例
- AIアプリケーション開発
- エージェントシステムの作成
- コーディングアシスタントツール
- チャットボットの実装
- 情報強化生成
- 一般的な会話AI
- 自然言語処理
- 視覚タスク処理
- モデルのファインチューニング
- サードパーティ製品の統合