メインコンテンツへスキップ
ToolPotion
AI アドバイザー
送信(無料)

SenseNova-Loop-9B-Preview

LLM#85AIモデルとLLMオープンソース · Web

SenseNova-Loop-9B-Previewは、長いコンテキストとエージェントワークフローに対応するために設計されたマルチモーダル言語モデルです。テキストと画像の両方を処理してテキスト出力を生成し、文書理解、コーディング、外部ツールとの相互作用におけるアプリケーションをサポートします。このモデルは、ユニークなループデコーダアーキテクチャと、効率的で深い実行パスのための二重ストリーム多様体制約ハイパーコネクションを特徴としています。

URLを訪問
共有
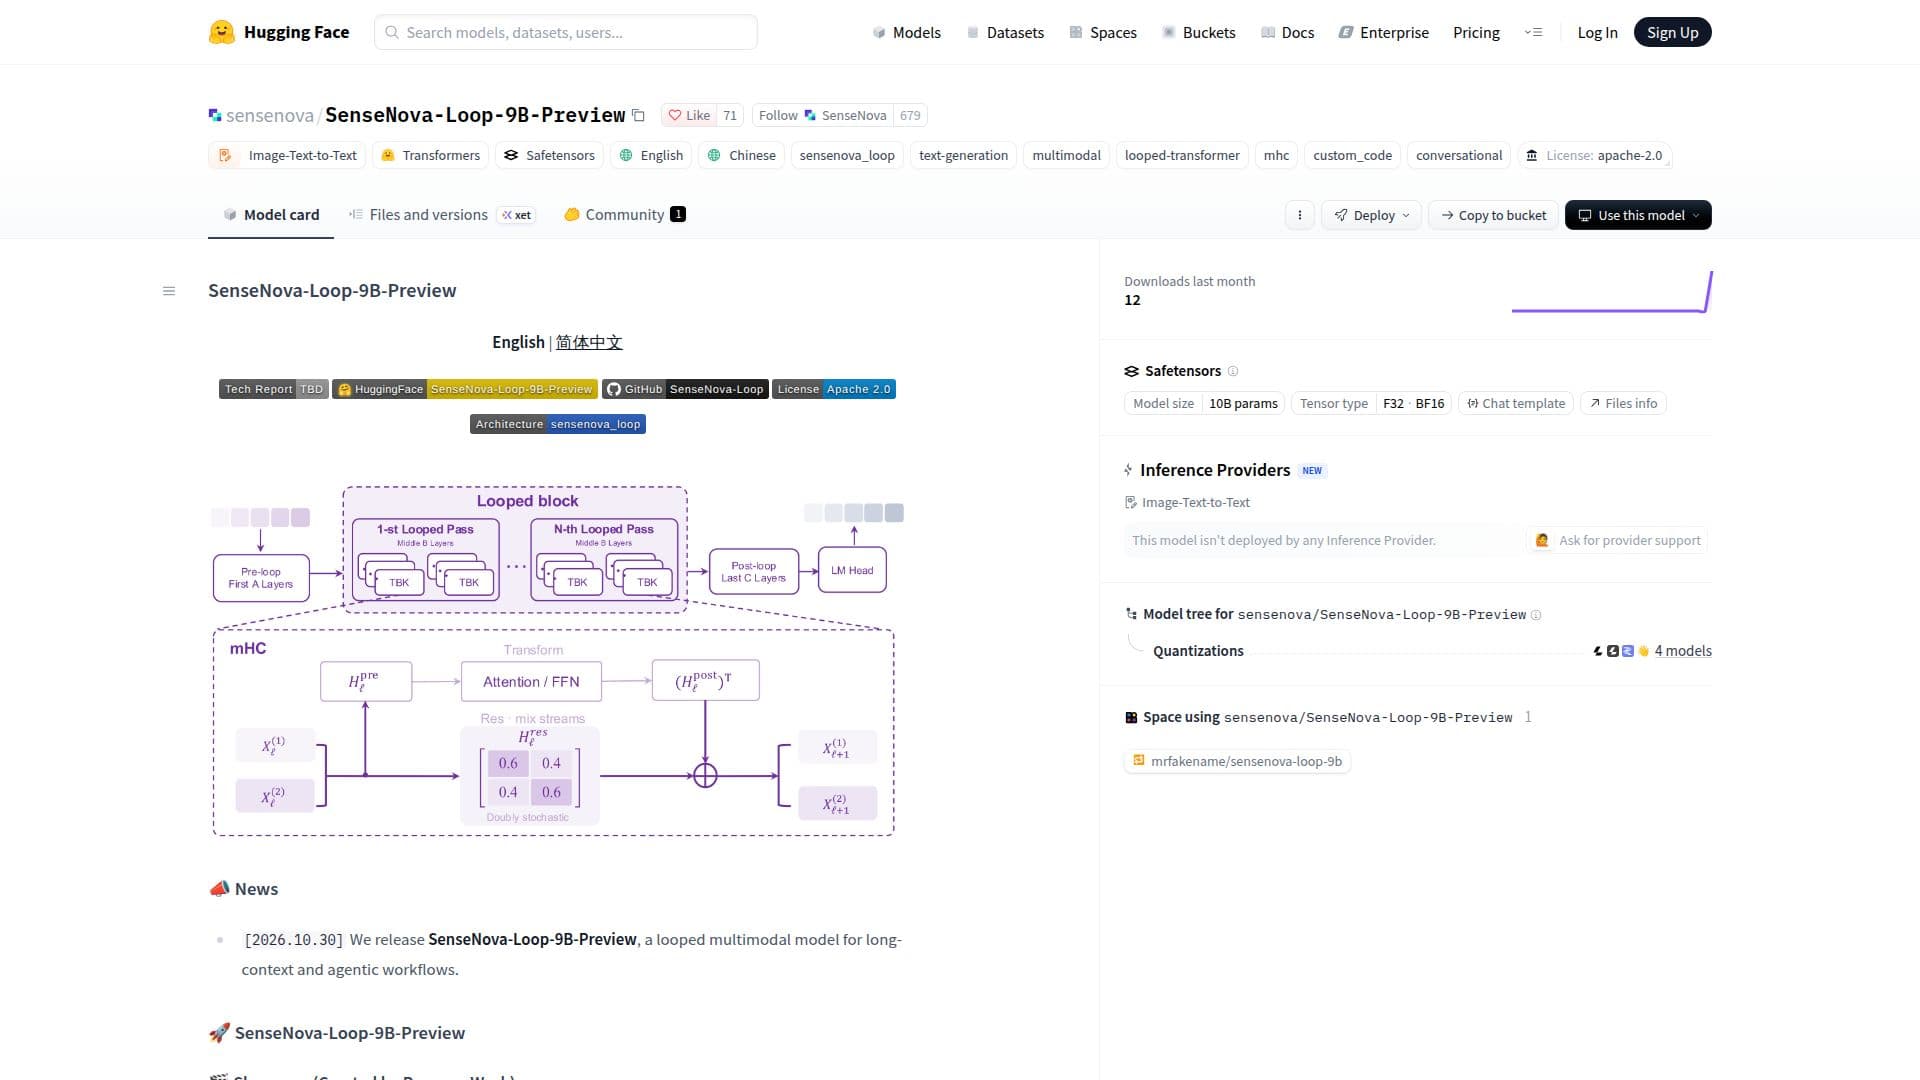
SenseNova-Loop-9B-Preview のスクリーンショット

SenseNova-Loop-9B-Previewは、複雑で長いコンテキストのシナリオやエージェントワークフローを処理するために設計された先進的なマルチモーダル言語モデルです。SenseNovaによって開発されたこのモデルは、テキストと画像の両方の入力を受け入れ、その後テキスト出力を生成することができます。主なアプリケーションは、包括的な文書理解、洗練されたコーディングタスク、さまざまな外部ツールとのシームレスな相互作用などの分野に広がります。

続きを読む

SenseNova-Loop-9B-Previewのアーキテクチャの核心は、ループデコーダと二重ストリーム多様体制約ハイパーコネクション(mHC)の革新的な組み合わせにあります。この設計により、デコーダ層の連続ブロックを共有重みを使用して2回実行でき、パラメータを重複させることなく実行パスを大幅に深めることができます。mHCシステム内の学習されたマッピングは、ループセクション内の2つの残差ストリーム間の情報フローを効率的に管理し、モデルの情報処理および統合能力を向上させます。

モデルのトレーニングレシピには、長いシーケンス、多様なマルチモーダル入力、および監視されたタスクの軌跡が含まれており、最大トレーニングシーケンス長は262,144トークンに達します。この広範なトレーニングにより、さまざまな複雑なタスクに対して堅牢なパフォーマンスが可能になります。最適な操作のために、ユーザーは文書化されたデプロイメント環境と構成パラメータを利用することをお勧めします。

主なアーキテクチャのハイライトには、24のデコーダ層が2回適用される共有ループブロックが含まれ、32の異なる層から56のデコーダ層の実行が得られます。二重ストリームmHCは、残差ストリーム間の情報のインテリジェントなルーティングと組み合わせを促進します。さらに、デコーダはハイブリッドアテンションメカニズムを採用しており、線形アテンションとフルアテンションを繰り返し4層パターンで交互に配置し、ループパス全体で保持されます。このモデルは、加速された推論のためのMTPもサポートしており、現在、速度をさらに向上させるためにDsparkとDflash2が開発中です。

  • カテゴリーAIモデルとLLM
  • 料金モデルオープンソース
  • デプロイクラウド
  • プラットフォームWeb

  • マルチモーダル入力: テキストと画像の両方を受け入れます

  • テキスト生成: テキスト出力を生成します

  • ループデコーダアーキテクチャ: 共有重みでデコーダ層を2回実行します

  • 二重ストリーム多様体制約ハイパーコネクション(mHC): 残差ストリーム間の情報フローを管理します

  • 長いコンテキスト処理: 最大262,144トークンのトレーニングシーケンス長をサポートします

  • エージェントワークフローサポート: 外部ツールとの相互作用のために設計されています

  • ハイブリッドアテンション: 線形アテンションとフルアテンション層を交互に配置します

  • パラメータ効率: 32の異なる層から56のデコーダ層の実行を達成します

  • 文書理解: 複雑な文書を処理する能力があります

  • コーディングアプリケーション: コード関連のタスクをサポートします

  • MTP推論加速: より高速な処理のために利用可能です

  • ファインチューニングサポート: カスタマイズのための文書化されたトレーニングレシピを提供します

  • Apache License 2.0: 使用および変更のためのオープンソースライセンス

  • Hugging Face統合: Hugging Faceでのダウンロードとデプロイが可能です

  1. モデルページにアクセス: Hugging FaceのSenseNova-Loop-9B-Previewページに移動します。

  2. 依存関係をインストール: CUDA環境に適したPyTorchをインストールし、その後Transformers 5.18.0とPyTorch 2.11.0をインストールします。

  3. モデルをロード: Transformersライブラリを使用して、Hugging Faceリポジトリまたはローカルディレクトリからモデルとそのカスタム実装をロードします。

  4. 推論を構成: `model_id`をリポジトリIDまたはローカルパスに設定し、`enable_thinking`や`device`などのパラメータを構成します。

  5. テキストを生成: 提供されたPythonの例を実行してテキスト生成を行い、新しいトークンの数を指定します。

  6. モデルをファインチューニング: 文書化されたトレーニングコマンドを使用して、8つのGPUを持つ単一ノードでSFTデータセットを使用してファインチューニングを行います。

  7. モデルをデプロイ: 提供された例のローカルモデルパスを置き換えて、LightLLMやSGLangなどのデプロイメントオプションを利用します。

  • 長いコンテキストの文書理解
  • エージェントワークフローの自動化
  • マルチモーダルコンテンツ生成
  • 高度なコーディング支援
  • PPTデザインの自動化
  • モーションデザインテキスト生成
  • データ分析報告
  • マルチモーダル研究開発

SenseNova-Loop-9B-Preview のレビュー

読み込み中...

SenseNova-Loop-9B-Preview に似た人気のAIツール

MiniMax M3は、コーディングとエージェンティックタスクに優れた高度なAIモデルです。1Mのコンテキストウィンドウとネイティブなマルチモーダル理解を備え、MSAアーキテクチャによって支えられています。このモデルはオープンウェイト機能を提供し、開発者や研究者にとって多用途なツールとなっています。

AIモデルとLLM

LLMで第61位

ツールを見る

コーディングとエージェンティックタスクに優れた高度なAIモデルです。1Mのコンテキストウィンドウとネイティブなマルチモーダル理解を備え、MSAアーキテクチャによって支えられています。このモデルはオープンウェイト機能を提供し、開発者や研究者にとって多用途なツールとなっています。MiniMax M3は、コーディングとエージェンティックタスクに優れた高度なAIモデルです。1Mのコンテキストウィンドウとネイティブなマルチモーダル理解を備え、MSAアーキテクチャによって支えられています。このモデルはオープンウェイト機能を提供し、開発者や研究者にとって多用途なツールとなっています。

AIモデルとLLM
LLMで第61位

LiquidAI LFM3-1.7Bは、ローカルエージェントおよび専門的なアプリケーション向けに設計されたテキストモデルです。トライハイブリッドアーキテクチャを特徴とし、256Kトークンのコンテキストウィンドウをサポートしているため、エッジデバイスに適しています。このモデルは、ドメイン特化型のファインチューニングに適応可能です。

AIモデルとLLM

LLMで第91位

ツールを見る

ローカルエージェントおよび専門的なアプリケーション向けに設計されたテキストモデルです。トライハイブリッドアーキテクチャを特徴とし、256Kトークンのコンテキストウィンドウをサポートしているため、エッジデバイスに適しています。このモデルは、ドメイン特化型のファインチューニングに適応可能です。LiquidAI LFM3-1.7Bは、ローカルエージェントおよび専門的なアプリケーション向けに設計されたテキストモデルです。トライハイブリッドアーキテクチャを特徴とし、256Kトークンのコンテキストウィンドウをサポートしているため、エッジデバイスに適しています。このモデルは、ドメイン特化型のファインチューニングに適応可能です。

AIモデルとLLM
LLMで第91位

DeepSeek-V4-Flash-Vision-Expは、視覚理解能力を強化するDeepSeek-V4ファミリーの実験的なマルチモーダルモデルです。DeepSeek-V4-Flashアーキテクチャに基づき、テキスト専用のパフォーマンスを維持しながら、マルチモーダルエージェントの能力を向上させます。

AIモデルとLLM

LLMで第70位

ツールを見る

視覚理解能力を強化するDeepSeek-V4ファミリーの実験的なマルチモーダルモデルです。DeepSeek-V4-Flashアーキテクチャに基づき、テキスト専用のパフォーマンスを維持しながら、マルチモーダルエージェントの能力を向上させます。DeepSeek-V4-Flash-Vision-Expは、視覚理解能力を強化するDeepSeek-V4ファミリーの実験的なマルチモーダルモデルです。DeepSeek-V4-Flashアーキテクチャに基づき、テキスト専用のパフォーマンスを維持しながら、マルチモーダルエージェントの能力を向上させます。

AIモデルとLLM
LLMで第70位

Inkling-Smallは、テキスト、画像、音声入力を処理してテキスト出力を生成する多用途のマルチモーダルモデルです。開放された重みを持ち、研究や統合をサポートし、チャットボットやコーディングアシスタントなどのAIアプリケーションの開発を支援します。

AIモデルとLLM

LLMで第27位

ツールを見る

テキスト、画像、音声入力を処理してテキスト出力を生成する多用途のマルチモーダルモデルです。開放された重みを持ち、研究や統合をサポートし、チャットボットやコーディングアシスタントなどのAIアプリケーションの開発を支援します。Inkling-Smallは、テキスト、画像、音声入力を処理してテキスト出力を生成する多用途のマルチモーダルモデルです。開放された重みを持ち、研究や統合をサポートし、チャットボットやコーディングアシスタントなどのAIアプリケーションの開発を支援します。

AIモデルとLLM
LLMで第27位

pplx-embed-v2-context-9b-previewは、RAGシステムにおける文書チャンク用に設計されたコンテキスト埋め込みモデルです。文書チャンクを一緒にエンコードし、その周囲のコンテキストを反映し、チャンクごとに1つの埋め込みを返します。

AIモデルとLLM
ツールを見る

RAGシステムにおける文書チャンク用に設計されたコンテキスト埋め込みモデルです。文書チャンクを一緒にエンコードし、その周囲のコンテキストを反映し、チャンクごとに1つの埋め込みを返します。pplx-embed-v2-context-9b-previewは、RAGシステムにおける文書チャンク用に設計されたコンテキスト埋め込みモデルです。文書チャンクを一緒にエンコードし、その周囲のコンテキストを反映し、チャンクごとに1つの埋め込みを返します。

AIモデルとLLM
AI モデル トップ5を見る

DeepSeek V4 Flash

AI モデル

DeepSeek V4 Flashは、高度なテキスト生成タスクのために設計されたAIモデルコレクションです。オープンソースとオープンサイエンスの原則を活用し、人工知能を民主化することを目的とし、さまざまなアプリケーションに対応する異なるパラメータを持つモデルを提供します。

AIモデルとLLM
ツールを見る

AI モデル

高度なテキスト生成タスクのために設計されたAIモデルコレクションです。オープンソースとオープンサイエンスの原則を活用し、人工知能を民主化することを目的とし、さまざまなアプリケーションに対応する異なるパラメータを持つモデルを提供します。DeepSeek V4 Flashは、高度なテキスト生成タスクのために設計されたAIモデルコレクションです。オープンソースとオープンサイエンスの原則を活用し、人工知能を民主化することを目的とし、さまざまなアプリケーションに対応する異なるパラメータを持つモデルを提供します。

AIモデルとLLM
AI モデル トップ5を見る

Muse Spark 1.3

AI モデル

Muse Spark 1.3は、信頼性のあるツール呼び出しと多段階推論を必要とする長期的なタスクのために構築された、Metaのエージェントワークフローおよびコーディングワークフロー用のAIモデルです。動画、画像、文書のネイティブなマルチモーダル認識、100万トークンのコンテキストウィンドウを提供し、Meta Model…

AIモデルとLLM
ツールを見る

AI モデル

信頼性のあるツール呼び出しと多段階推論を必要とする長期的なタスクのために構築された、Metaのエージェントワークフローおよびコーディングワークフロー用のAIモデルです。動画、画像、文書のネイティブなマルチモーダル認識、100万トークンのコンテキストウィンドウを提供し、Meta Model…Muse Spark 1.3は、信頼性のあるツール呼び出しと多段階推論を必要とする長期的なタスクのために構築された、Metaのエージェントワークフローおよびコーディングワークフロー用のAIモデルです。動画、画像、文書のネイティブなマルチモーダル認識、100万トークンのコンテキストウィンドウを提供し、Meta Model…

注目AIモデルとLLM
AI モデル トップ5を見る

LLaVA

AI GitHub リポジトリ

LLaVAは、大規模言語とビジョン機能を組み合わせたビジュアル指示チューニングモデルです。GPT-4Vレベルのパフォーマンスを目指し、マルチモーダルな理解とインタラクションを可能にします。このプロジェクトは、研究者や開発者向けにコード、モデル、リソースを提供します。

AIモデルとLLM
ツールを見る

AI GitHub リポジトリ

大規模言語とビジョン機能を組み合わせたビジュアル指示チューニングモデルです。GPT-4Vレベルのパフォーマンスを目指し、マルチモーダルな理解とインタラクションを可能にします。このプロジェクトは、研究者や開発者向けにコード、モデル、リソースを提供します。LLaVAは、大規模言語とビジョン機能を組み合わせたビジュアル指示チューニングモデルです。GPT-4Vレベルのパフォーマンスを目指し、マルチモーダルな理解とインタラクションを可能にします。このプロジェクトは、研究者や開発者向けにコード、モデル、リソースを提供します。

AIモデルとLLM
AI GitHub リポジトリ トップ250を見る
1 / 8