メインコンテンツへスキップ
ToolPotion
AI アドバイザー
送信(無料)

MiMo-V2.6-Pro-RL

LLMAIモデルとLLMオープンソース · Web

MiMo-V2.6-Pro-RLは、自己改善のための強化学習を拡張するように設計されたMiMoシリーズのフラッグシップモデルです。テキスト、画像、動画、音声処理を統合し、さまざまな分野での多様なアプリケーションを可能にします。

URLを訪問
共有
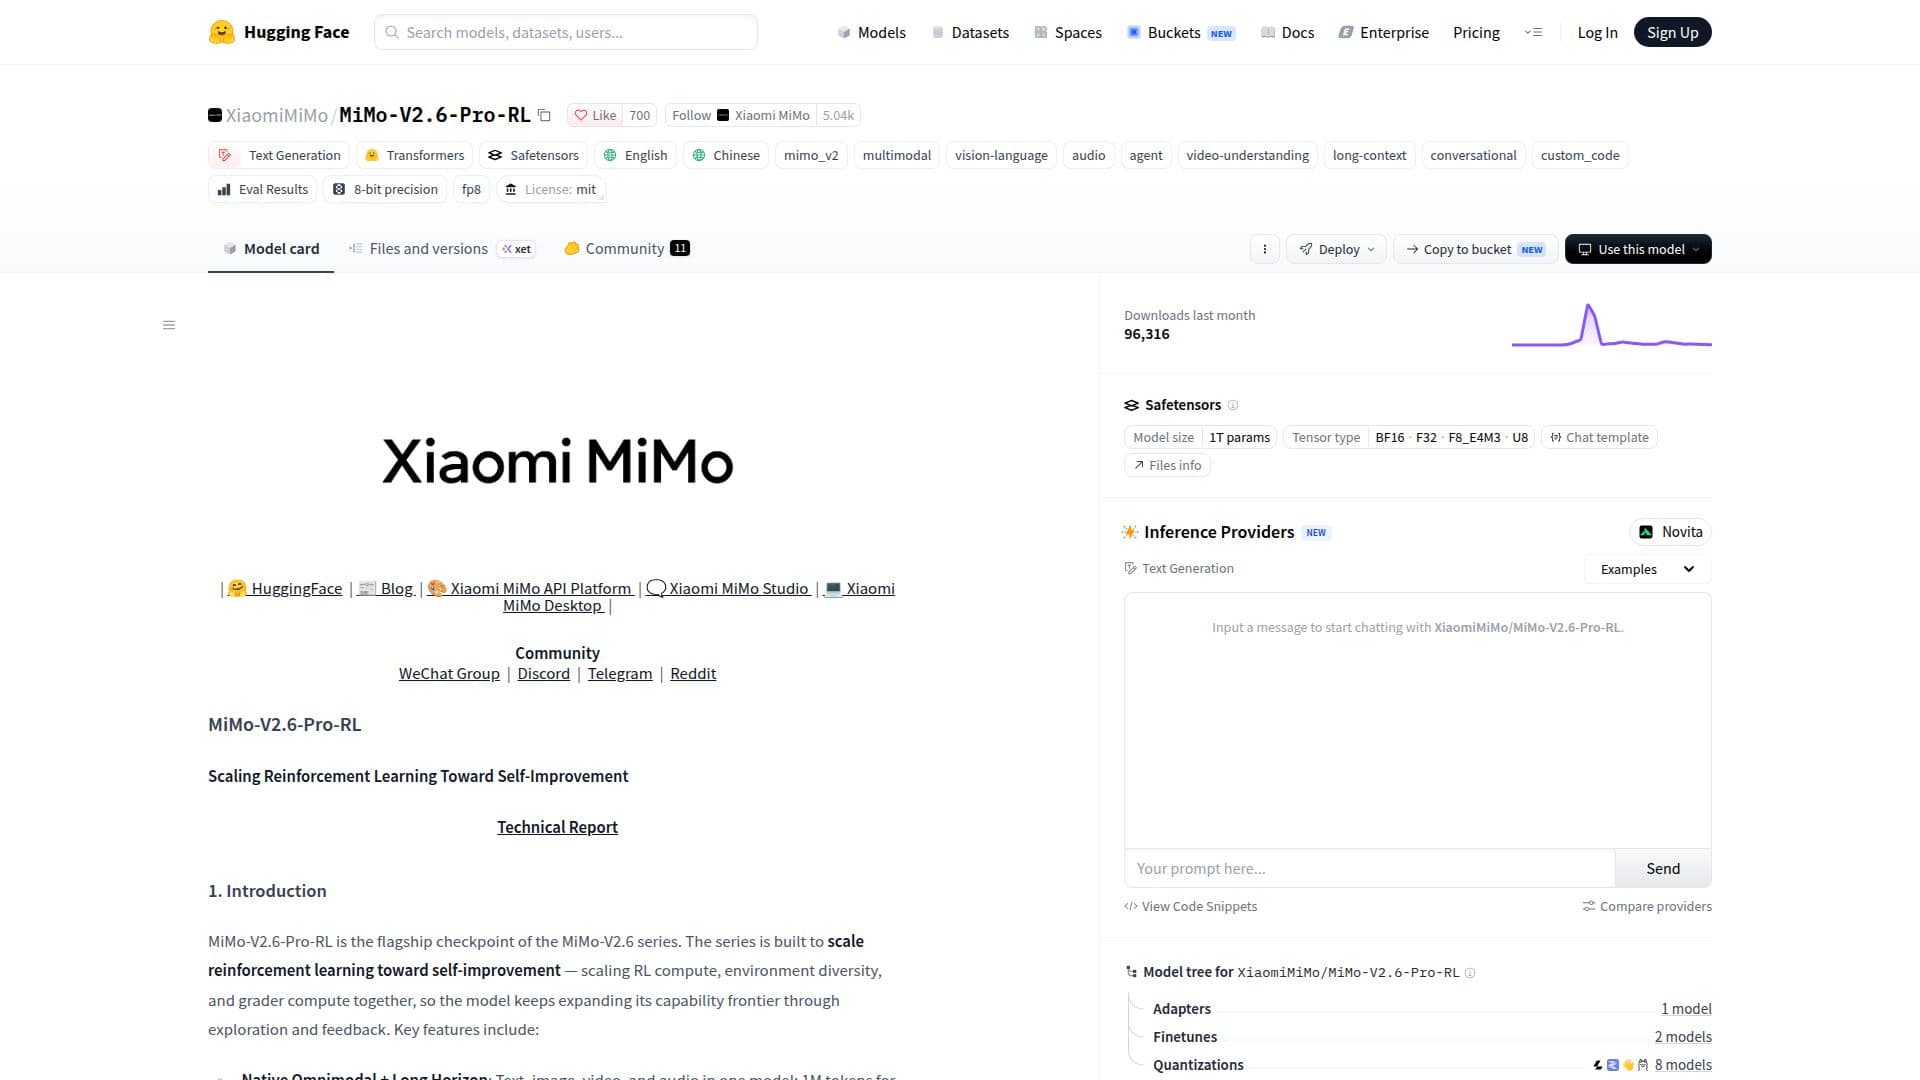
MiMo-V2.6-Pro-RL のスクリーンショット

MiMo-V2.6-Pro-RLは、自己改善に向けた強化学習を進化させるために開発されたMiMoシリーズの主要モデルです。このモデルは、RLコンピュート、環境の多様性、グレーダーコンピュートを一緒にスケールするように構築されており、探索とフィードバックを通じてその能力を拡張することができます。主な特徴には、テキスト、画像、動画、音声を1つのモデルに統合するネイティブオムニモーダルアプローチと、広範なリポジトリやマルチセッションエージェントの実行を処理するための100万トークンの長いコンテキスト長が含まれます。

続きを読む

このモデルは、タスクを混合し、単一のバッチで能力を強化し、ドメイン間で戦略を転送するためのユニークな「You Only RL Once」戦略を採用しています。大規模なバッチで完全非同期のグループ相対ポリシー最適化(GRPO)を利用し、更新ごとに数十億のトークンを処理します。グループ単位のエージェントグレーディングシステムは、解決策をランク付けし、効率的なパスに導くことで自己改善ループを強化します。

MiMo-V2.6-Pro-RLは、複雑なタスクへの能力を拡張するために、自律的な学生ロールアウトとプレフィックス条件付きロールアウトを組み合わせたマルチプレフィックスマルチティーチャーオンポリシーディスティレーション(MOPD2)も特徴としています。このモデルのアーキテクチャには、1.02兆の総パラメータを持つスパースエキスパートの混合と、681百万のパラメータを持つビジョンエンコーダーが含まれています。

このモデルは、AI Studio、MiMo Code、Xiaomi MiMo Desktopなどのさまざまなプラットフォームを通じて展開可能です。最適なパフォーマンスのためにDocker展開をサポートし、Xiaomi MiMo Open Platform APIおよびOpenRouterを介してアクセスできます。

  • カテゴリーAIモデルとLLM
  • 料金モデルオープンソース
  • デプロイクラウド
  • プラットフォームWeb

  • ネイティブオムニモーダル統合

  • 100万トークンのコンテキスト長

  • You Only RL Once戦略

  • グループ相対ポリシー最適化

  • グループ単位のエージェントグレーディング

  • マルチプレフィックスマルチティーチャーディスティレーション

  • スパースエキスパートの混合アーキテクチャ

  • 複数のプラットフォームで利用可能

  1. モデルページにアクセス: MiMo-V2.6-Pro-RLの公式Hugging Faceページを訪問します。

  2. 認証: モデルにアクセスするために必要な資格情報を確認します。

  3. 設定: 要件に応じてモデルパラメータを設定します。

  4. プロンプトを送信: モデルと対話し、出力を受け取るためにデータを入力します。

  • マルチモーダル処理
  • 強化学習
  • 大規模データ処理
  • ドメイン間戦略転送
  • 高度なグレーディングシステム

MiMo-V2.6-Pro-RL のレビュー

読み込み中...

MiMo-V2.6-Pro-RL に似た人気のAIツール

LiquidAI LFM2.5-2.6Bは、デバイス上での展開を目的としたハイブリッドモデルで、効率的な推論とエージェント機能を提供します。複数の言語をサポートし、さまざまなプラットフォームに最適化されているため、多様なアプリケーションに対応可能です。

AIモデルとLLM

LLMで第26位

ツールを見る

デバイス上での展開を目的としたハイブリッドモデルで、効率的な推論とエージェント機能を提供します。複数の言語をサポートし、さまざまなプラットフォームに最適化されているため、多様なアプリケーションに対応可能です。LiquidAI LFM2.5-2.6Bは、デバイス上での展開を目的としたハイブリッドモデルで、効率的な推論とエージェント機能を提供します。複数の言語をサポートし、さまざまなプラットフォームに最適化されているため、多様なアプリケーションに対応可能です。

AIモデルとLLM
LLMで第26位

Mellum2.1 Thinkingは、コーディング、数学、推論における複雑なタスクのために設計された大規模言語モデルです。広範な強化学習のおかげで、リポジトリ作業やツール使用などのエージェンティックタスクに優れています。

AIモデルとLLM

LLMで第19位

ツールを見る

コーディング、数学、推論における複雑なタスクのために設計された大規模言語モデルです。広範な強化学習のおかげで、リポジトリ作業やツール使用などのエージェンティックタスクに優れています。Mellum2.1 Thinkingは、コーディング、数学、推論における複雑なタスクのために設計された大規模言語モデルです。広範な強化学習のおかげで、リポジトリ作業やツール使用などのエージェンティックタスクに優れています。

AIモデルとLLM
LLMで第19位

MiniMax M3は、コーディングとエージェンティックタスクに優れた高度なAIモデルです。1Mのコンテキストウィンドウとネイティブなマルチモーダル理解を備え、MSAアーキテクチャによって支えられています。このモデルはオープンウェイト機能を提供し、開発者や研究者にとって多用途なツールとなっています。

AIモデルとLLM

LLMで第49位

ツールを見る

コーディングとエージェンティックタスクに優れた高度なAIモデルです。1Mのコンテキストウィンドウとネイティブなマルチモーダル理解を備え、MSAアーキテクチャによって支えられています。このモデルはオープンウェイト機能を提供し、開発者や研究者にとって多用途なツールとなっています。MiniMax M3は、コーディングとエージェンティックタスクに優れた高度なAIモデルです。1Mのコンテキストウィンドウとネイティブなマルチモーダル理解を備え、MSAアーキテクチャによって支えられています。このモデルはオープンウェイト機能を提供し、開発者や研究者にとって多用途なツールとなっています。

AIモデルとLLM
LLMで第49位

Agents-A1は、複数のドメインにわたるエージェント能力を拡張するために設計された35B Mixture-of-Expertsモデルです。長期的な探索、エンジニアリング、科学研究、指示の遵守に優れ、最前線のシステムに対して堅牢なパフォーマンスを提供します。

AIモデルとLLM

LLMで第34位

ツールを見る

複数のドメインにわたるエージェント能力を拡張するために設計された35B Mixture-of-Expertsモデルです。長期的な探索、エンジニアリング、科学研究、指示の遵守に優れ、最前線のシステムに対して堅牢なパフォーマンスを提供します。Agents-A1は、複数のドメインにわたるエージェント能力を拡張するために設計された35B Mixture-of-Expertsモデルです。長期的な探索、エンジニアリング、科学研究、指示の遵守に優れ、最前線のシステムに対して堅牢なパフォーマンスを提供します。

AIモデルとLLM
LLMで第34位

KAT-Coder-V2.5-Devは、高度なコーディングタスクのために設計された大規模言語モデルです。エージェント的コーディングにおいて最先端のパフォーマンスを提供し、強化学習を通じて異常な行動の最適化に焦点を当てています。

AIモデルとLLM
ツールを見る

高度なコーディングタスクのために設計された大規模言語モデルです。エージェント的コーディングにおいて最先端のパフォーマンスを提供し、強化学習を通じて異常な行動の最適化に焦点を当てています。KAT-Coder-V2.5-Devは、高度なコーディングタスクのために設計された大規模言語モデルです。エージェント的コーディングにおいて最先端のパフォーマンスを提供し、強化学習を通じて異常な行動の最適化に焦点を当てています。

AIモデルとLLM
LLM トップ50を見る

Solar Open 2は、Upstageによって開発された大規模言語モデルで、オフィスの生産性やコーディングなどのエージェント的なユースケースに特化しています。ハイブリッドアテンションミクスチャーオブエキスパートアーキテクチャを採用しており、効率的な推論と多言語サポートを提供します。

AIモデルとLLM

LLMで第18位

ツールを見る

Upstageによって開発された大規模言語モデルで、オフィスの生産性やコーディングなどのエージェント的なユースケースに特化しています。ハイブリッドアテンションミクスチャーオブエキスパートアーキテクチャを採用しており、効率的な推論と多言語サポートを提供します。Solar Open 2は、Upstageによって開発された大規模言語モデルで、オフィスの生産性やコーディングなどのエージェント的なユースケースに特化しています。ハイブリッドアテンションミクスチャーオブエキスパートアーキテクチャを採用しており、効率的な推論と多言語サポートを提供します。

AIモデルとLLM
LLMで第18位

DeepSeek-V4-Flash-Vision-Expは、視覚理解能力を強化するDeepSeek-V4ファミリーの実験的なマルチモーダルモデルです。DeepSeek-V4-Flashアーキテクチャに基づき、テキスト専用のパフォーマンスを維持しながら、マルチモーダルエージェントの能力を向上させます。

AIモデルとLLM
ツールを見る

視覚理解能力を強化するDeepSeek-V4ファミリーの実験的なマルチモーダルモデルです。DeepSeek-V4-Flashアーキテクチャに基づき、テキスト専用のパフォーマンスを維持しながら、マルチモーダルエージェントの能力を向上させます。DeepSeek-V4-Flash-Vision-Expは、視覚理解能力を強化するDeepSeek-V4ファミリーの実験的なマルチモーダルモデルです。DeepSeek-V4-Flashアーキテクチャに基づき、テキスト専用のパフォーマンスを維持しながら、マルチモーダルエージェントの能力を向上させます。

AIモデルとLLM
LLM トップ50を見る

DeepSeek-V3.2は、効率的な推論とエージェントタスクのために設計された高度なAIモデルです。DeepSeekスパースアテンション、スケーラブルな強化学習、そして大規模なエージェントタスク合成パイプラインを特徴としています。

AIモデルとLLM
ツールを見る

効率的な推論とエージェントタスクのために設計された高度なAIモデルです。DeepSeekスパースアテンション、スケーラブルな強化学習、そして大規模なエージェントタスク合成パイプラインを特徴としています。DeepSeek-V3.2は、効率的な推論とエージェントタスクのために設計された高度なAIモデルです。DeepSeekスパースアテンション、スケーラブルな強化学習、そして大規模なエージェントタスク合成パイプラインを特徴としています。

AIモデルとLLM
AI モデル トップ5を見る
1 / 8