説明
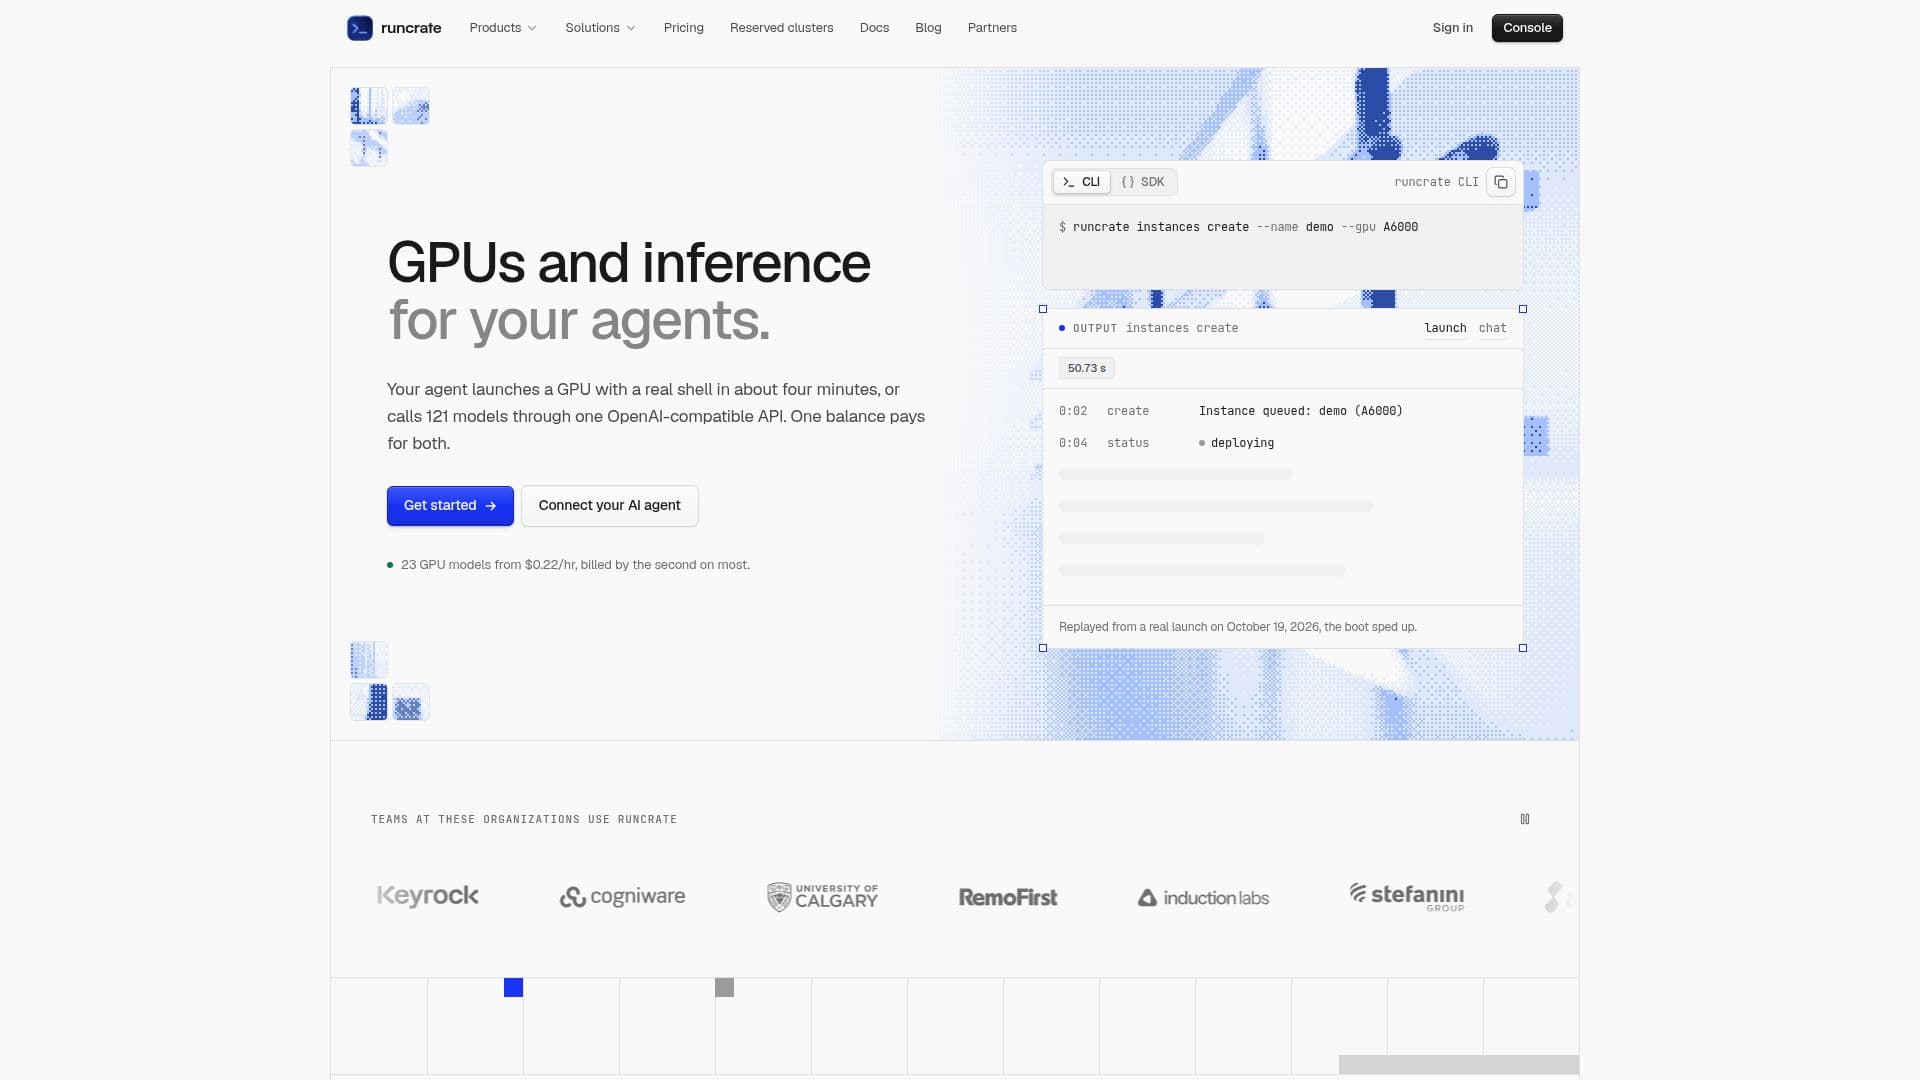
Runcrateは、Aeonmindによって開発されたAIおよび機械学習チーム向けの包括的なAIクラウドインフラストラクチャを提供します。H100、H200、A100、L40S、RTX 4090などの強力なGPUにオンデマンドでアクセスでき、ほとんどのモデルは秒単位で請求されます。GPUインスタンスは数分以内に起動でき、承認待ちやクォータ要求を排除します。
続きを読む
このプラットフォームは、OpenAI互換の推論APIも備えており、ユーザーはテキスト生成、視覚、画像処理、動画、音声、文字起こし、埋め込みなどのさまざまなタスクに対して121の異なるモデルを呼び出すことができます。この統一APIは、モデルの統合と使用を簡素化し、GPU使用とモデル推論の両方をカバーする単一の残高で管理します。
Runcrateは、幅広いAI開発活動をサポートしています。ユーザーは、LoRAを使用して自分のデータでLlama、Mistral、Qwenなどのオープンモデルをファインチューニングし、vLLMを使用して専用GPU上でオープンソースのLLMを提供し、Whisper APIを使用して音声および動画ファイルを大規模に文字起こしできます。また、プラットフォームはRTX 4090インスタンス上でComfyUIを実行し、ドキュメントを埋め込み、チャットモデルを使用して回答を得るRAGパイプラインの開発を促進します。
データの永続性のために、Runcrateはインスタンス間でコード、データ、およびチェックポイントを保持するストレージボリュームを提供し、GPUが終了しても作業が失われないようにします。請求は正確で、インスタンスが稼働しているときのみ開始され、通常は秒単位で請求され、ブート時間に対しては請求されません。このプラットフォームは、Claude Code、Codex、Cursorなどのツールと統合されており、エージェントが直接GPUインスタンスを起動および管理できるようにします。
Runcrateの価格モデルには、GPUインスタンスの秒単位の請求、推論API呼び出しのトークン単位の価格設定、ストレージボリュームの月額料金が含まれています。GPUと推論のためのプリペイドオプションが利用可能で、ユーザーは長期プロジェクトのためにマルチノードクラスターを予約できます。同社のビジョンは、インフラストラクチャのボトルネックを排除し、オープンモデルを促進することで、AI開発をより安価でアクセスしやすくすることです。
- カテゴリー機械学習プラットフォーム
- 料金モデル従量課金
- デプロイクラウド
- プラットフォームWeb
Runcrateの主要機能
オンデマンドGPUインスタンス(H100、H200、A100、L40S、RTX 4090)
ほとんどのGPUに対する秒単位の請求
121のモデルを備えたOpenAI互換の推論API
迅速なGPUインスタンスの展開(通常数分以内)
LoRA/QLoRAを使用したLLMのファインチューニングのサポート(Llama、Mistral、Qwen)
vLLMを使用して専用GPU上でオープンソースのLLMを提供
音声および動画の文字起こし用のWhisper API
インスタンス間での永続データ用のストレージボリューム
すべての製品(GPU、推論、ストレージ)に対する統一アカウントと残高
AIエージェントおよび開発者ツール(Claude Code、Codex、Cursor)との統合
プリペイドオプションおよび予約クラスターの利用可能
GPUのブート時間中は請求なし
ブラウザでのJupyterおよびVS Codeへのアクセス
ファインチューニングおよび提供のための準備済みイメージ
クレジット閾値管理のための自動再充電
Runcrateの使い方は?
接続: 一つのコマンドでRuncrateを好みのツール(Claude Code、Codex、Cursor、またはターミナル)に追加します。
サインイン: ブラウザを通じてアクセスを承認し、キーを貼り付ける必要はありません。
GPUを起動: エージェントに特定のGPUを希望のクレートで起動するように依頼します。例: 「FinetuneクレートでH100を起動してください。」
リソースを構成: GPUモデルを選択し、必要なリソースを構成します。
デプロイ: インスタンスを起動します。GPUインスタンスが稼働しているときに請求が開始されます。
管理: ターミナルまたは統合ツールから直接GPUインスタンスをデプロイ、管理、終了します。
利用: GPUを使用してモデルのトレーニング、提供、またはOpenAI互換のAPIを介してモデルを呼び出します。
データを保存: 永続ストレージボリュームを使用してインスタンス間で作業を保持します。
Runcrateの使用例
- モデルのトレーニング
- AI推論
- LLMのファインチューニング
- RAGパイプライン
- AIエージェントの操作
- 画像および動画生成
- 音声およびオーディオ処理
- コンピュータビジョンタスク
- データ処理
- 研究および実験