メインコンテンツへスキップ
ToolPotion
AI アドバイザー
送信(無料)

GMI Cloud

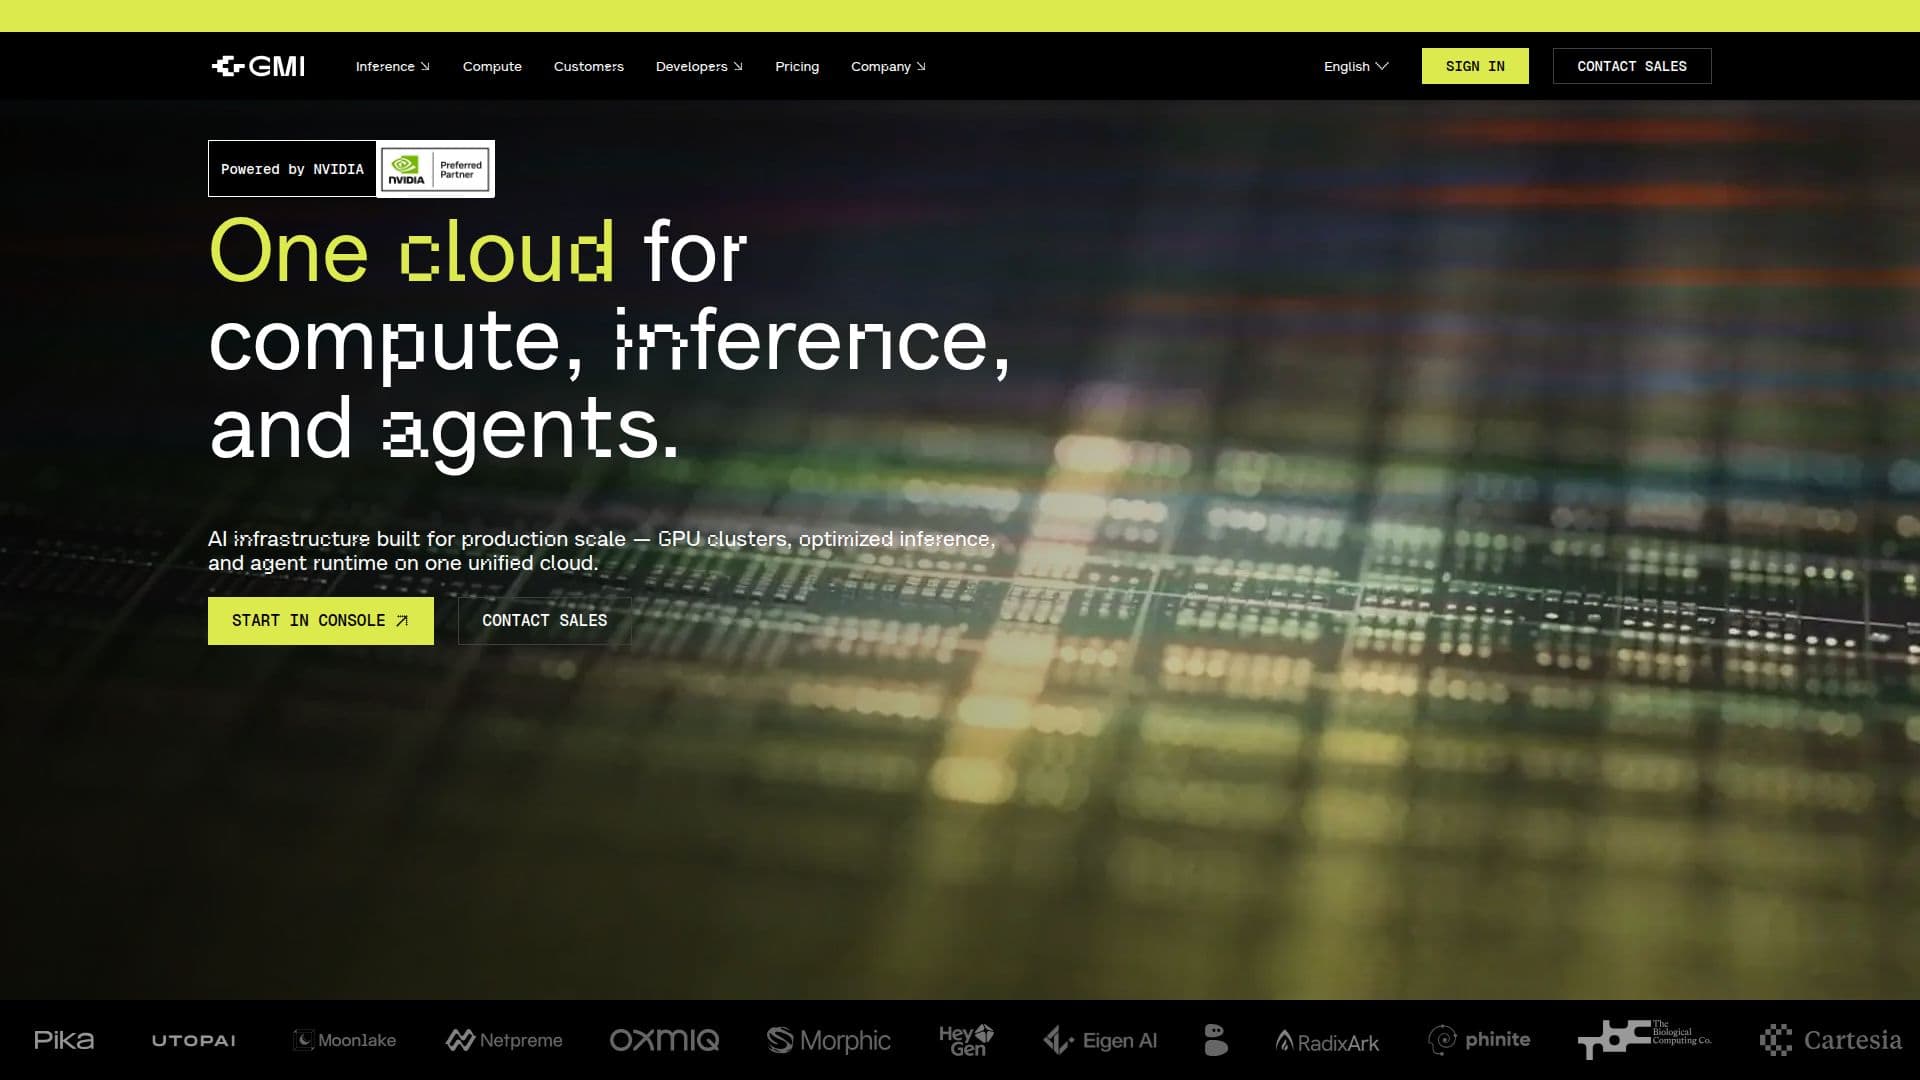
GMI CloudはAIワークロード向けの高性能GPUクラウドインフラストラクチャを提供します。サーバーレス推論、専用GPUクラスター、ベアメタルAIインフラストラクチャをサポートし、AIモデルのデプロイメントや機械学習タスクにスケーラブルなソリューションを提供します。

URLを訪問
共有
GMI Cloud のスクリーンショット

GMI Cloudは、高性能GPUクラウドインフラストラクチャを用いて生産AIワークロードをサポートするために設計された包括的なプラットフォームです。このプラットフォームはAIモデルのトレーニングと推論に特化しており、サーバーレス推論、専用GPUクラスター、ベアメタルAIインフラストラクチャを含むスケーラブルなソリューションを提供します。GMI Cloudは、大規模言語モデル、画像および動画生成、その他のマルチモーダルAIシステムの実行に最適化されています。NVIDIA H100、H200、Blackwell GPUの透明なGPU価格を提供し、AIモデルのコスト効率の良いデプロイメントを実現します。

続きを読む

このプラットフォームのサーバーレス推論機能により、チームはAIモデルを即座に実行でき、ワークロードが増加するにつれて専用GPUインフラストラクチャにシームレスにスケールアップできます。この柔軟性は、AIプロトタイプから生産デプロイメントに移行する開発者にとって重要であり、信頼性のあるスケーリング、監視、コスト管理をサポートします。GMI Cloudのインフラストラクチャは、効率的なGPU利用、バッチ処理戦略、自動スケーリングを通じてAI推論コストを削減するように設計されています。

GMI CloudのアーキテクチャはNVIDIAリファレンスプラットフォームに基づいており、パフォーマンス、信頼性、スケーラビリティを確保しています。LLMおよびマルチモーダルモデル向けの生産準備が整ったAPIを提供し、自動スケーリング、組み込みバッチ処理、レイテンシを考慮したスケジューリングなどの機能を備えています。このプラットフォームは、開発者がサーバーレスAPI、専用エンドポイント、またはGPUクラスターを通じてオープンソースまたはカスタムモデルをデプロイできるように、幅広いAIワークロードをサポートしています。

このプラットフォームは、主要なAIチームに信頼されており、コスト削減とパフォーマンス向上を実現しています。Mirelo AIやHiggsfieldのような企業は、それぞれ基盤モデルの開発やリアルタイム生成動画ワークロードにGMI Cloudを活用しています。GMI Cloudの柔軟な商業構造と詳細な使用報告は、スタートアップや企業にとって魅力的な選択肢となっています。

  • カテゴリーMLOps・モデルデプロイ
  • 料金モデル透明
  • デプロイクラウド
  • プラットフォームNVIDIA GPU

  • 高性能GPUクラウドインフラストラクチャ

  • サーバーレス推論機能

  • 専用GPUクラスター

  • ベアメタルAIインフラストラクチャ

  • 透明なGPU価格

  • NVIDIA H100、H200、Blackwell GPUのサポート

  • 自動スケーリングとコスト最適化

  • AIモデル向けの生産準備が整ったAPI

  1. 設定: AIモデルのデプロイメントを設定する

  2. 使用: サーバーレス推論または専用エンドポイントを使用してモデルをデプロイする

  3. 最適化: 自動スケーリングとバッチ処理戦略を活用する

  4. スケール: 必要に応じて専用GPUインフラストラクチャにシームレスに移行する

  • AIモデルのトレーニング
  • リアルタイム推論
  • マルチモーダルAIシステム
  • コスト最適化
  • スケーラブルなデプロイメント

GMI Cloud のレビュー

読み込み中...

GMI Cloud に似た人気のAIツール

Saladは、1日あたり60,000以上のアクティブGPUを持つ分散型GPUクラウドを提供し、時間あたりわずか0.02ドルから利用可能です。AI/ML本番モデル、推論、バッチ処理などに低コストで大規模なコンピューティングを提供し、ハイパースケーラーと比較して最大90%のコスト削減を実現します。

MLOps・モデルデプロイ
ツールを見る

1日あたり60,000以上のアクティブGPUを持つ分散型GPUクラウドを提供し、時間あたりわずか0.02ドルから利用可能です。AI/ML本番モデル、推論、バッチ処理などに低コストで大規模なコンピューティングを提供し、ハイパースケーラーと比較して最大90%のコスト削減を実現します。Saladは、1日あたり60,000以上のアクティブGPUを持つ分散型GPUクラウドを提供し、時間あたりわずか0.02ドルから利用可能です。AI/ML本番モデル、推論、バッチ処理などに低コストで大規模なコンピューティングを提供し、ハイパースケーラーと比較して最大90%のコスト削減を実現します。

MLOps・モデルデプロイ
AI アプリ トップ250を見る

GPUX

AI アプリ

GPUXはAIモデル向けのサーバーレスGPU推論を提供し、機械学習ワークロードの高速なデプロイと実行を可能にします。高速なコールドスタート、Stable Diffusion XLやWhisperなどの様々なAIモデルのサポート、プライベートモデルでの推論実行やリクエスト販売をユーザーに提供し、AIをよりアクセスしやすく効率的にします。

MLOps・モデルデプロイ
ツールを見る

AI アプリ

AIモデル向けのサーバーレスGPU推論を提供し、機械学習ワークロードの高速なデプロイと実行を可能にします。高速なコールドスタート、Stable Diffusion XLやWhisperなどの様々なAIモデルのサポート、プライベートモデルでの推論実行やリクエスト販売をユーザーに提供し、AIをよりアクセスしやすく効率的にします。GPUXはAIモデル向けのサーバーレスGPU推論を提供し、機械学習ワークロードの高速なデプロイと実行を可能にします。高速なコールドスタート、Stable Diffusion XLやWhisperなどの様々なAIモデルのサポート、プライベートモデルでの推論実行やリクエスト販売をユーザーに提供し、AIをよりアクセスしやすく効率的にします。

MLOps・モデルデプロイ
AI アプリ トップ250を見る

一般計算

AI アプリ

特別に設計されたASICインフラストラクチャ上でモデルを提供する高速AI推論プロバイダーで、OpenAI互換のAPIを通じて、コーディングエージェントやリアルタイム音声などのレイテンシに敏感なワークロードに対して低いファーストトークン時間と高いスループットを提供します。

MLOps・モデルデプロイ
ツールを見る

AI アプリ

特別に設計されたASICインフラストラクチャ上でモデルを提供する高速AI推論プロバイダーで、OpenAI互換のAPIを通じて、コーディングエージェントやリアルタイム音声などのレイテンシに敏感なワークロードに対して低いファーストトークン時間と高いスループットを提供します。

MLOps・モデルデプロイ
AI アプリ トップ250を見る

SiliconFlow

AI プラットフォーム

開発者が200以上の最適化されたLLMおよびマルチモーダルモデルをデプロイ、ファインチューニング、実行できるAIインフラストラクチャプラットフォームで、OpenAI互換のAPIを通じて従量課金制で提供されます。

MLOps・モデルデプロイ
ツールを見る

AI プラットフォーム

開発者が200以上の最適化されたLLMおよびマルチモーダルモデルをデプロイ、ファインチューニング、実行できるAIインフラストラクチャプラットフォームで、OpenAI互換のAPIを通じて従量課金制で提供されます。

注目MLOps・モデルデプロイ
AI プラットフォーム トップ150を見る

Thunder Compute

AI アプリ

Thunder Computeは、世界で最も安価なGPUを提供し、競争力のある時間料金でNVIDIA H100へのアクセスを可能にします。同社のクラウドプラットフォームは、高度なGPU仮想化を活用してコンピューティングリソースを豊富にし、データセンターの容量を大幅に改善し、従来のクラウドプロバイダーと比較してコストを削減することを目指しています。

MLOps・モデルデプロイ

MLOps・モデルデプロイで第58位

ツールを見る

AI アプリ

世界で最も安価なGPUを提供し、競争力のある時間料金でNVIDIA H100へのアクセスを可能にします。同社のクラウドプラットフォームは、高度なGPU仮想化を活用してコンピューティングリソースを豊富にし、データセンターの容量を大幅に改善し、従来のクラウドプロバイダーと比較してコストを削減することを目指しています。Thunder Computeは、世界で最も安価なGPUを提供し、競争力のある時間料金でNVIDIA H100へのアクセスを可能にします。同社のクラウドプラットフォームは、高度なGPU仮想化を活用してコンピューティングリソースを豊富にし、データセンターの容量を大幅に改善し、従来のクラウドプロバイダーと比較してコストを削減することを目指しています。

MLOps・モデルデプロイ
MLOps・モデルデプロイで第58位

deAPI

AI アプリ

deAPIは、画像生成、テキスト読み上げ、転写などをカバーするオープンソースの生成AIモデルのための統一APIです。リクエストは分散型GPUクラウドで実行され、ハードウェアを管理することなく低コストの推論を提供します。

MLOps・モデルデプロイ
ツールを見る

AI アプリ

画像生成、テキスト読み上げ、転写などをカバーするオープンソースの生成AIモデルのための統一APIです。リクエストは分散型GPUクラウドで実行され、ハードウェアを管理することなく低コストの推論を提供します。deAPIは、画像生成、テキスト読み上げ、転写などをカバーするオープンソースの生成AIモデルのための統一APIです。リクエストは分散型GPUクラウドで実行され、ハードウェアを管理することなく低コストの推論を提供します。

MLOps・モデルデプロイ
AI アプリ トップ250を見る

Synexa

AI アプリ

Synexaは、1行のコードでAIモデルを実行するためのサーバーレスAPIです。開発者は、画像、動画、音声、3D生成、画像修復、キャプション付け、モデルのファインチューニングのための100以上の本番用モデルにアクセスでき、A100およびH100 GPU上で自動スケーリングと従量課金制の価格で実行されます。

MLOps・モデルデプロイ

MLOps・モデルデプロイで第136位

ツールを見る

AI アプリ

1行のコードでAIモデルを実行するためのサーバーレスAPIです。開発者は、画像、動画、音声、3D生成、画像修復、キャプション付け、モデルのファインチューニングのための100以上の本番用モデルにアクセスでき、A100およびH100 GPU上で自動スケーリングと従量課金制の価格で実行されます。Synexaは、1行のコードでAIモデルを実行するためのサーバーレスAPIです。開発者は、画像、動画、音声、3D生成、画像修復、キャプション付け、モデルのファインチューニングのための100以上の本番用モデルにアクセスでき、A100およびH100 GPU上で自動スケーリングと従量課金制の価格で実行されます。

MLOps・モデルデプロイ
MLOps・モデルデプロイで第136位

GPUStack

AI GitHub リポジトリ

GPUStackは、高性能AIモデルの提供のために設計されたGPUクラスター管理ツールで、vLLMやSGLangを含み、オンデマンドでSSHアクセス可能なGPUインスタンスを提供します。AIアプリケーションのためのGPUリソースの効率的な管理を促進します。

MLOps・モデルデプロイ

AI DevOps・クラウドツールで第115位

ツールを見る

AI GitHub リポジトリ

高性能AIモデルの提供のために設計されたGPUクラスター管理ツールで、vLLMやSGLangを含み、オンデマンドでSSHアクセス可能なGPUインスタンスを提供します。AIアプリケーションのためのGPUリソースの効率的な管理を促進します。GPUStackは、高性能AIモデルの提供のために設計されたGPUクラスター管理ツールで、vLLMやSGLangを含み、オンデマンドでSSHアクセス可能なGPUインスタンスを提供します。AIアプリケーションのためのGPUリソースの効率的な管理を促進します。

MLOps・モデルデプロイ
AI DevOps・クラウドツールで第115位
1 / 8