説明
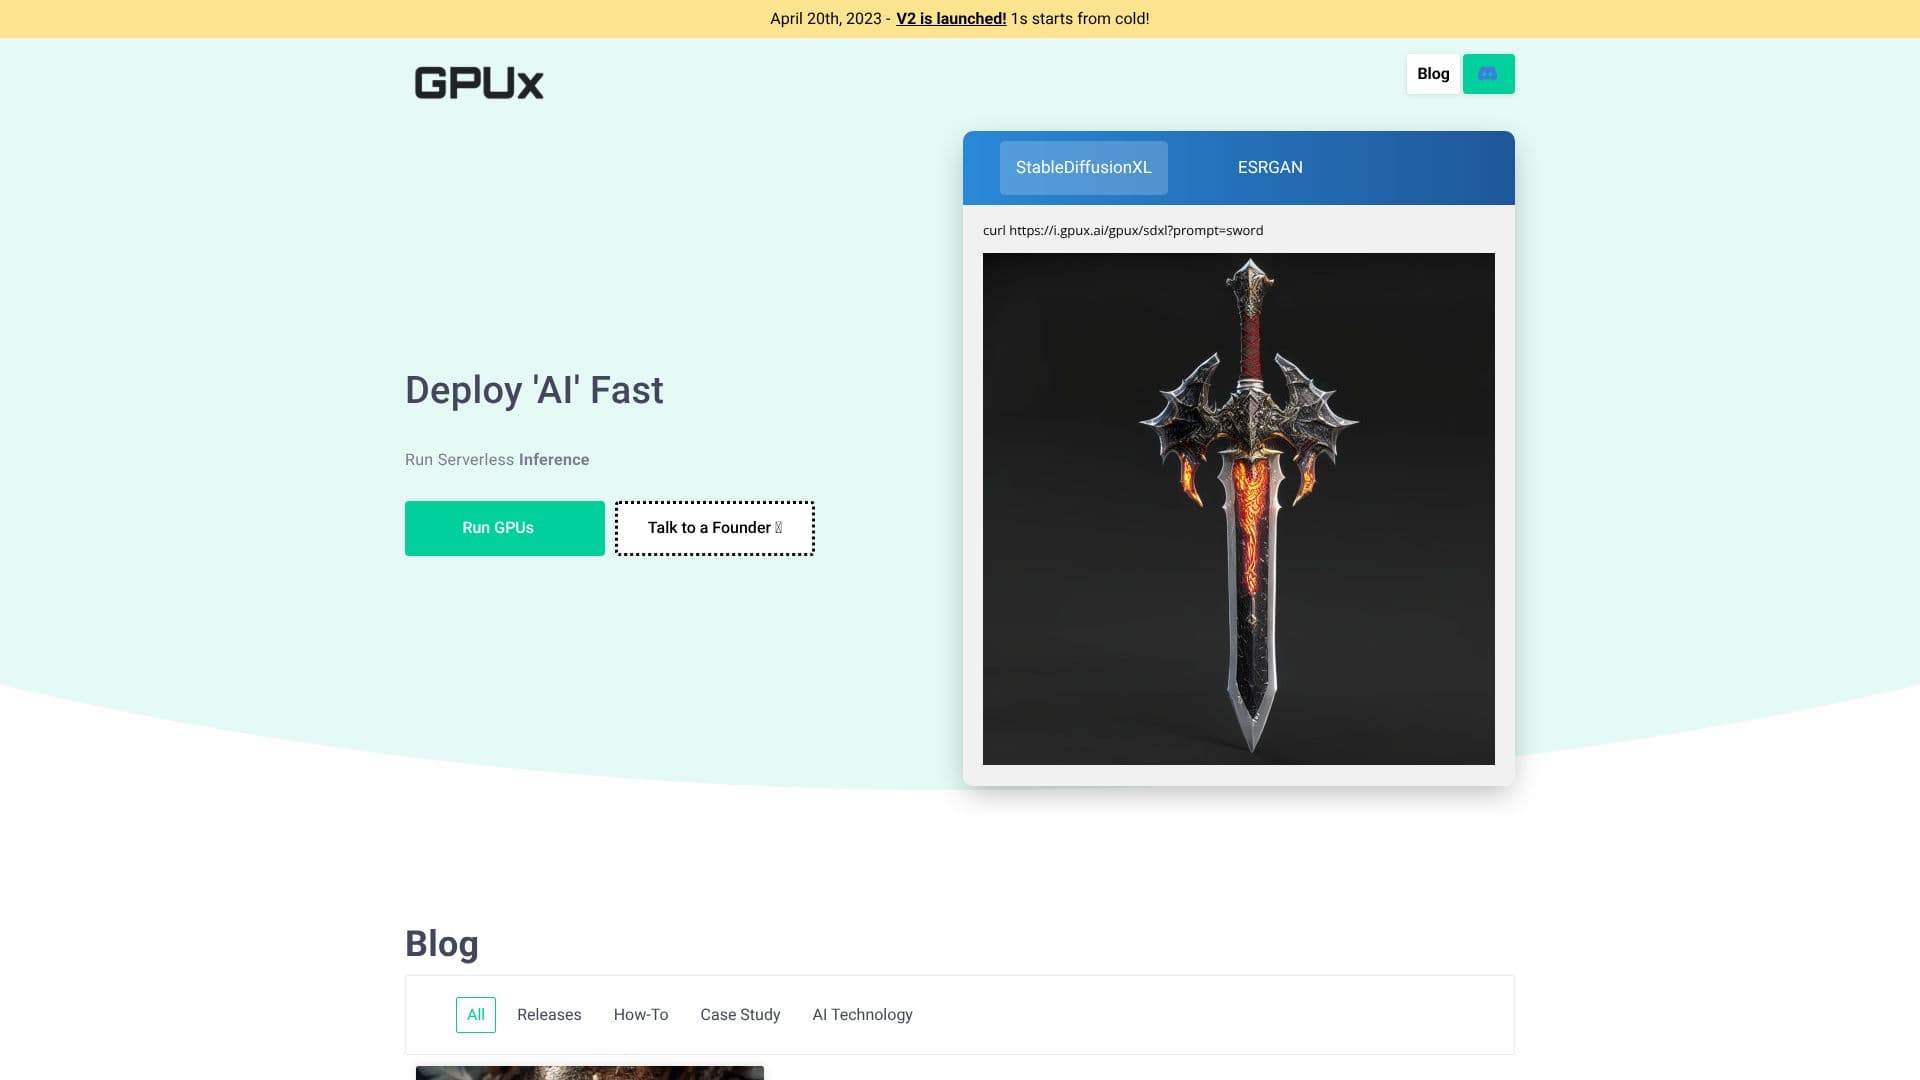
GPUXは、AIおよび機械学習モデルのデプロイと実行を加速するために設計されたサーバーレス推論プラットフォームです。V2は2023年4月20日にローンチされ、GPUXはインスタンスがわずか1秒から開始できる、迅速なコールドスタートの提供に注力しています。この機能は、即時の応答性を必要とするアプリケーションにとって極めて重要です。
続きを読む
このプラットフォームは、Stable Diffusion XL (SDXL)、ESRGAN、WHISPERを含む、さまざまな人気AIモデルをサポートしており、画像生成、アップスケーリング、音声テキスト変換などの多様なAIタスクに対応できます。GPUXを使用すると、ユーザーはインフラストラクチャ管理の複雑さを抽象化し、AIモデルをデプロイしてサーバーレス推論を実行できます。
推論の実行に加えて、GPUXはAIモデルの収益化のためのユニークな機能を提供します。ユーザーは、自身のプライベートモデルに対する推論リクエストを他の組織に販売でき、AI機能のためのマーケットプレイスを創出します。このピアツーピア(P2P)モデルは、モデルオーナーに収益をもたらす一方で、他のビジネスに専門的なAIへのアクセスを提供できます。
GPUXは、ナイキが現在女性用スパイクを特別に製造しているのと同様に、機械学習ワークロードに「適切なフィット感」の重要性を強調しています。これは、AIタスクの特定のニーズに合わせてインフラストラクチャとデプロイメントを調整することを意味します。プラットフォームは、推論中のデータ処理の柔軟性を向上させるReadWrite Volumesなどの機能をサポートしています。
GPUXのターゲットオーディエンスには、基盤となるハードウェアを管理することなく、効率的にAIモデルをデプロイおよびスケーリングしたいと考えている開発者、データサイエンティスト、および組織が含まれます。このプラットフォームは、AI推論のためのGPUコンピューティングへのアクセスを民主化し、より高速でコスト効率の高いものにすることを目指しています。GPUXのチームには、Annie(マーケティング)、Ivan(技術)、Henry(オペレーション)が含まれており、エンゲージメントのための連絡先情報とLinkedInプロフィールが提供されています。
GPUXは、AIテクノロジーに関する記事、ハウツーガイド、ケーススタディを含むブログなどのリソースも提供しています。最近のブログ投稿では、RTX 4090でStable Diffusion XLを50%高速化したなどのパフォーマンス改善が強調されており、最適化とユーザー教育へのコミットメントを示しています。プラットフォームは、使いやすさとパフォーマンスに重点を置いて構築されており、ユーザーが「AIを高速にデプロイ」できるようにします。
- カテゴリーMLOps・モデルデプロイ
- デプロイサーバーレス
- プラットフォームWeb
GPUXの主要機能
サーバーレスGPU推論
1秒のコールドスタート
Stable Diffusion XLのサポート
WHISPERのサポート
ESRGANのサポート
デプロイ済みモデルでの推論実行
プライベートモデルでの推論リクエスト販売
ReadWrite Volumesサポート
推論リクエストのためのP2Pモデル
AIモデルの高速デプロイ
スケーラブルな推論インフラストラクチャ
GPUXの使い方は?
モデルのデプロイ: トレーニング済みのAIモデルをGPUXプラットフォームにアップロードします。
推論の設定: モデルでの推論実行のためのパラメータを設定します。
推論の実行: サーバーレスGPUを活用して、オンデマンドで推論タスクを実行します。
パフォーマンスの最適化: モデルの速度と効率を向上させるための機能を利用します。
モデルの収益化(オプション): プライベートモデルの推論サービスを他のユーザーに提供します。
GPUXの使用例
- AIモデルのデプロイ
- サーバーレス推論
- 画像生成
- 音声テキスト変換
- モデルの収益化
- AIパフォーマンスの最適化
- GPUコンピューティングへのアクセス