説明
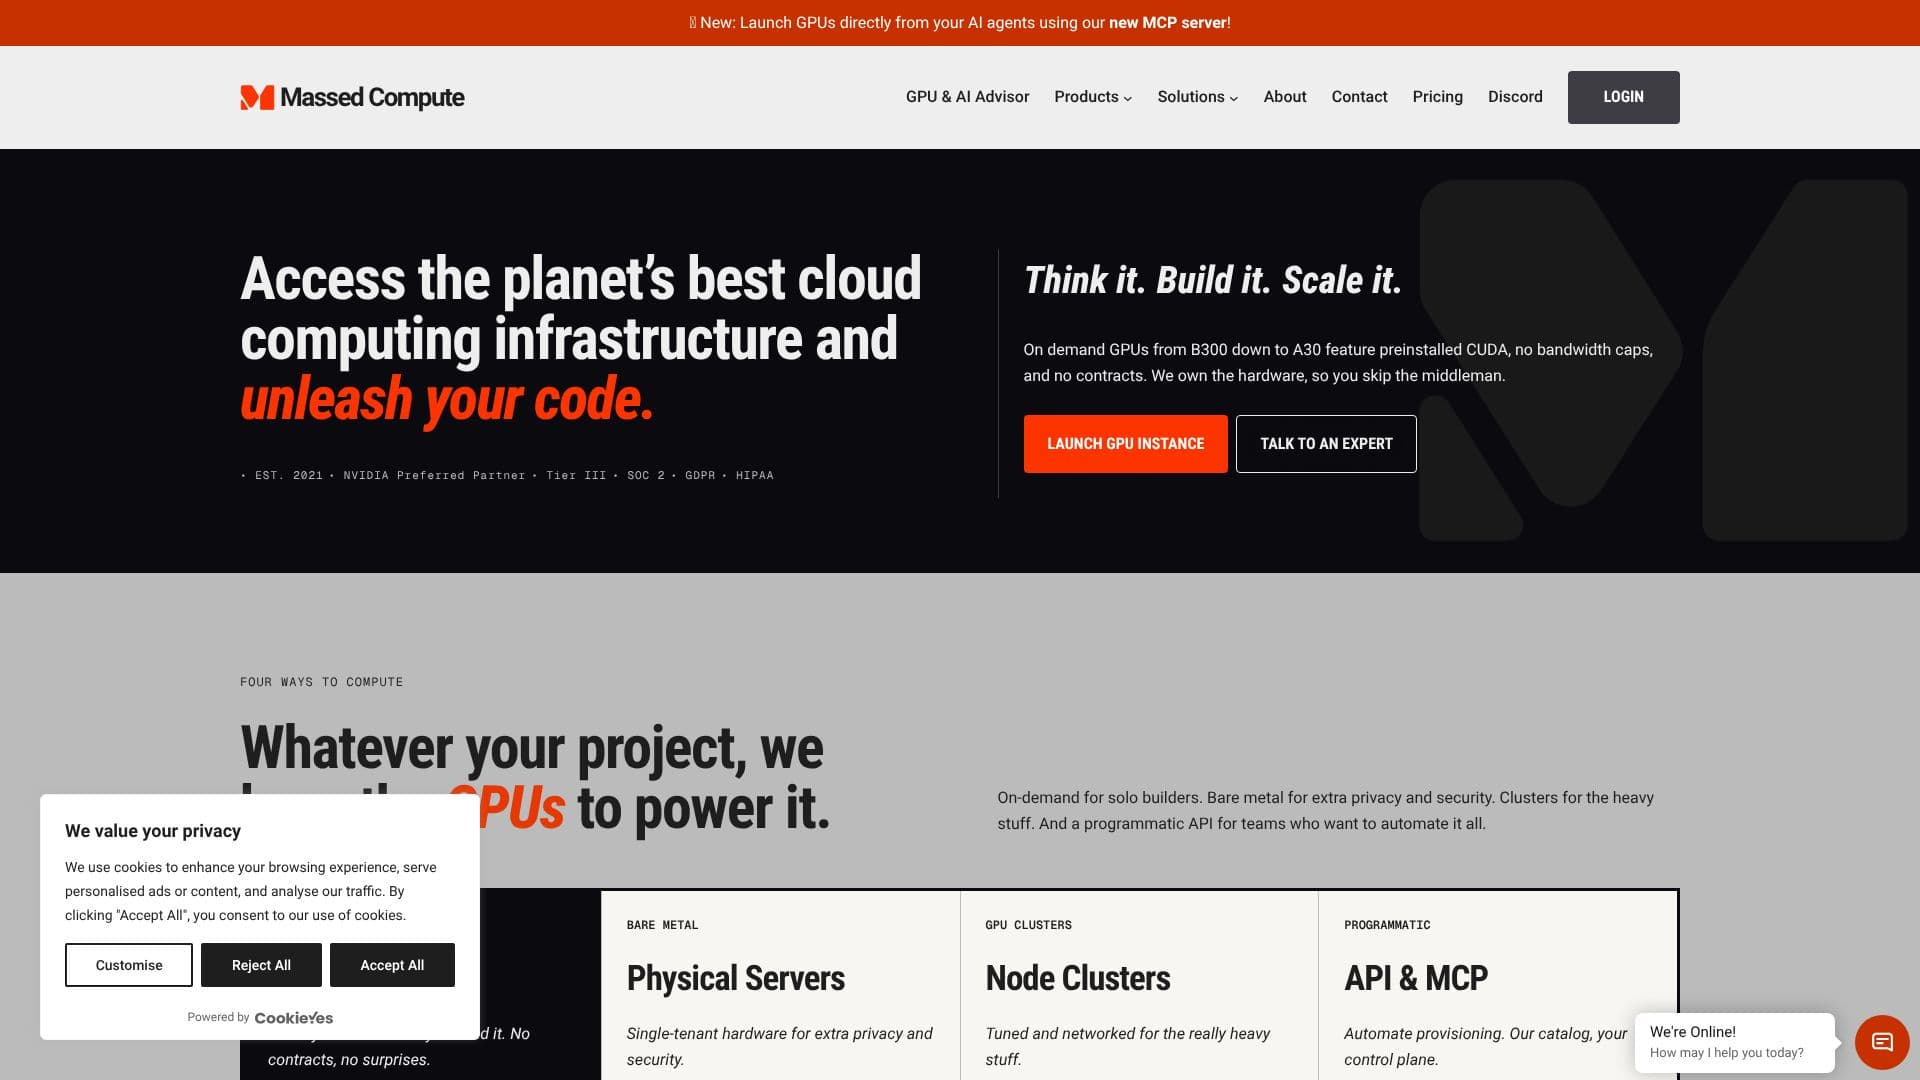
Massed Computeは、AI、機械学習、ビッグデータ処理、大規模レンダリングプロジェクトの高速化を目的とした、高性能NVIDIAクラウドGPUへのオンデマンドアクセスを提供します。2021年に設立された同社は、NVIDIAのPreferred Partnerとして、最新のエンタープライズグレードのハードウェアとベンダーテスト済みのドライバーへのアクセスを保証しています。インフラストラクチャはTier IIIデータセンターに配置され、SOC 2、GDPR、HIPAAなどの厳格なコンプライアンス基準に準拠しており、機密性の高いワークロードに適しています。
続きを読む
このサービスは、多様なプロジェクトニーズに対応するための柔軟なコンピューティングソリューションを提供します。オンデマンドGPUは時間単位のレンタルで利用可能で、CUDAがプリインストールされ、帯域幅の制限がなく、オプションでVDIセッションも利用できます。インスタンスは約90秒でデプロイ可能です。プライバシーとセキュリティの強化を必要とするユーザー向けに、ベアメタルサーバーはシングルテナントハードウェアを提供します。GPUクラスターは、高速ネットワーキングのためにInfiniBandを利用した集中的な計算用に設計されています。さらに、プログラムAPIにより、GPUプロビジョニングの自動化が可能になり、AIエージェント、ノートブック、CI/CDパイプラインとシームレスに統合できます。
Massed Computeのカタログには、最新のBlackwellおよびHopperアーキテクチャ(B300、B200、B100、H200、H100)からAmpereおよびAda Lovelace(A100、L40S、RTX 6000、A6000、A40、A30)まで、幅広いNVIDIA GPUが含まれています。すべてのインスタンスにはCUDAと最新のベンダー製ドライバーがプリインストールされており、手動でのセットアップやコンパイルの必要がありません。PyTorchトレーニング、vLLM推論、Stable Diffusion用のComfyUI、チャットモデル用のOllamaなどの一般的なAIタスク用の人気のある事前構成済みテンプレートが、JupyterLab DSNotebook環境とともに利用可能です。
このプラットフォームは使いやすさと迅速なデプロイを重視しており、ユーザーは長期的なコミットメントや複雑な契約なしにGPUインスタンスを迅速に起動できます。請求は透明性があり、時間単位の使用量に基づいており、時間あたり0.43ドルから始まります。このオンデマンドモデルは、物理ハードウェアの管理のオーバーヘッドなしに、スケーラブルでコスト効率の高いGPUリソースを求める研究者、開発者、企業に最適です。プログラムAPIは、チームがインフラストラクチャ管理を自動化し、プロジェクトの需要に基づいてリソースを動的にスケーリングすることをさらに可能にします。
- カテゴリー機械学習プラットフォーム
- 料金モデル毎時
- デプロイクラウド
- プラットフォームWeb
Massed Computeの主要機能
オンデマンドNVIDIAクラウドGPU
B300からA30までのGPUモデル
CUDAおよび最新ドライバーのプリインストール
帯域幅制限なし
契約なしの時間課金
約90秒でのインスタンスセットアップ
プライバシー強化のためのベアメタルサーバー
InfiniBandネットワーキングを備えたGPUクラスター
自動化のためのプログラムAPI
プロビジョニング用のREST APIエンドポイント
Python、Node.js、Go SDKのサポート
NVIDIA Preferred Partnerステータス
Tier IIIデータセンター
SOC 2、GDPR、HIPAA準拠
VDIが含まれる
Massed Computeの使い方は?
設定: 希望するNVIDIA GPUモデルとインスタンスタイプを選択します。
デプロイ: WebインターフェースまたはAPI経由でGPUインスタンスを起動します。
利用: プリインストールされたCUDAとドライバーでインスタンスにアクセスします。
自動化: プログラムAPIをAIワークフローに統合します。
スケーリング: プロジェクトの需要に基づいて必要に応じてリソースを調整します。
Massed Computeの使用例
- AIモデルトレーニング
- 大規模データ処理
- ML推論
- 3Dレンダリング
- AIエージェント統合
- 研究開発