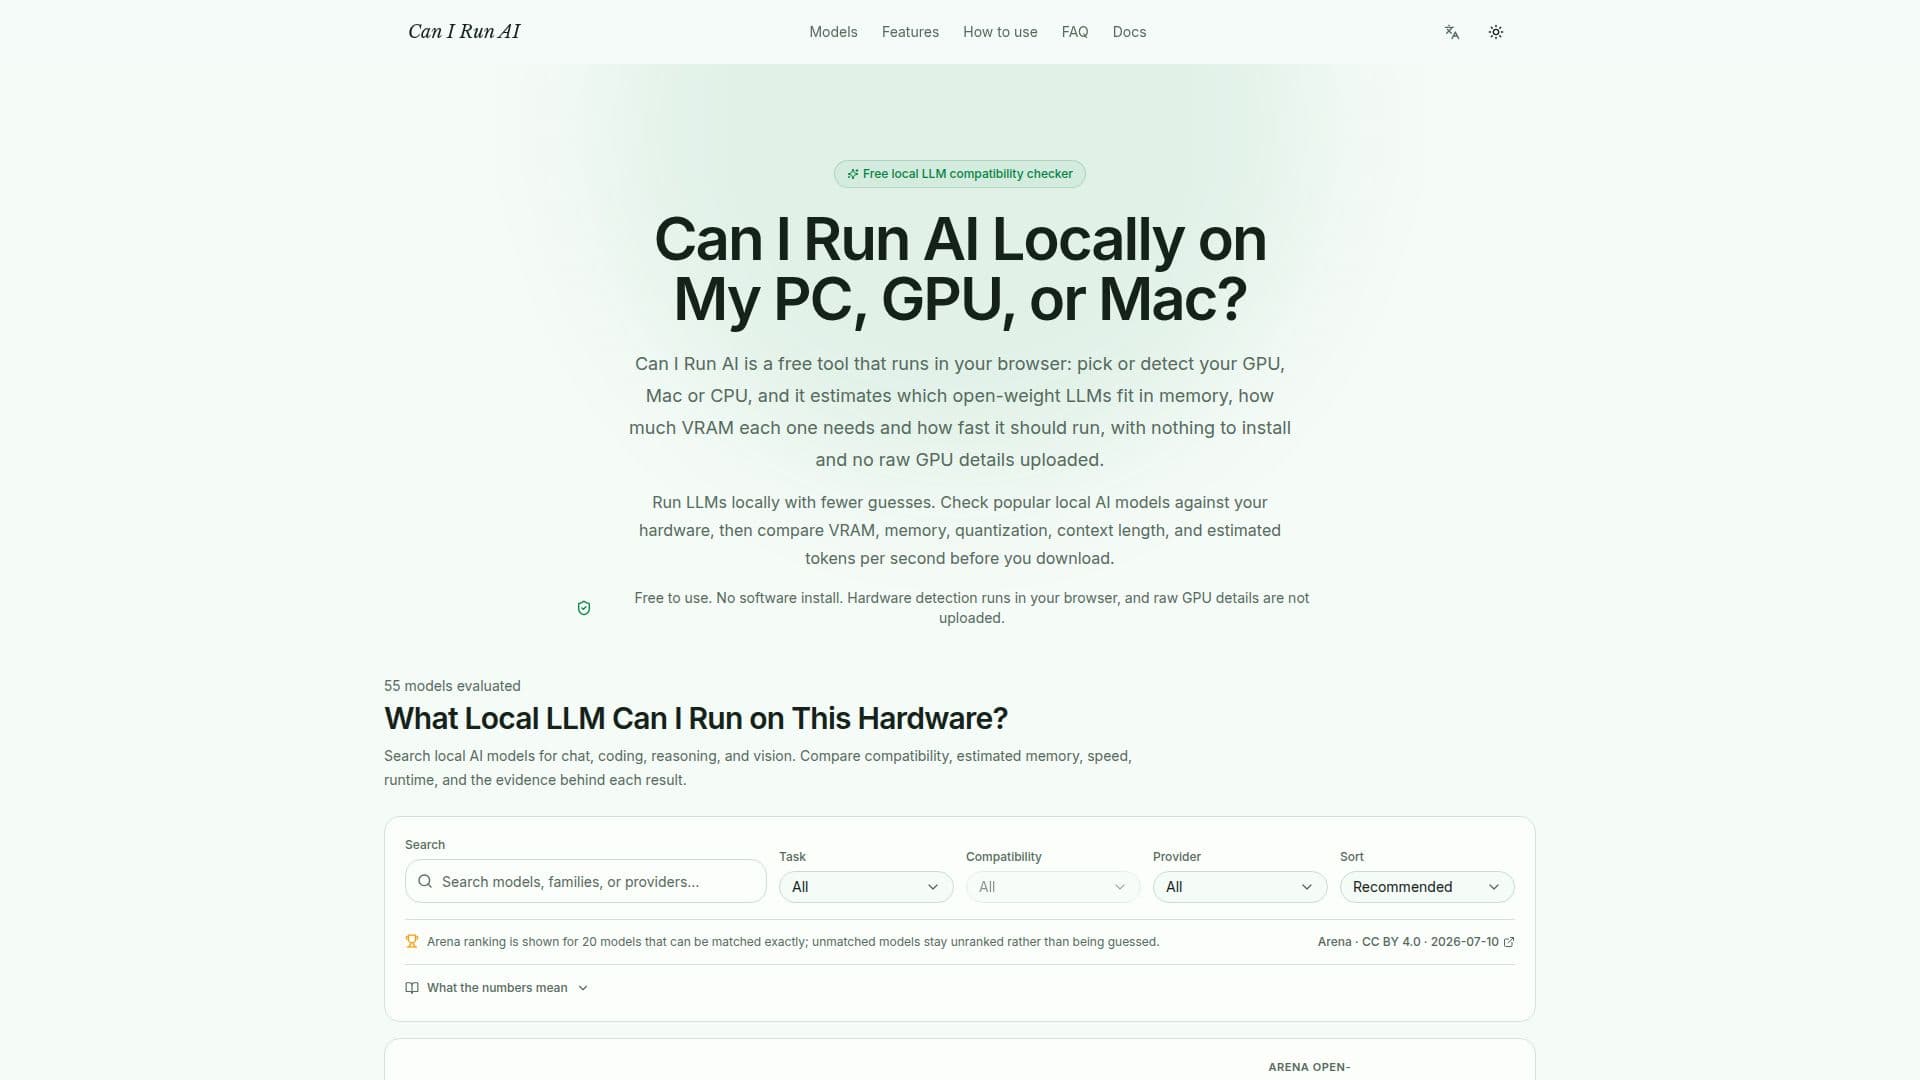
説明
AIをローカルで実行できますか?は、ユーザーが自分のハードウェアがサポートできるローカルの大規模言語モデル(LLM)を特定するために設計された無料のオンラインツールです。このブラウザベースの互換性チェッカーを使用することで、ユーザーは自分のGPU、Mac、またはCPUを選択または検出し、どのオープンウェイトモデルがメモリに収まるかの推定を受け取ることができます。このツールは、各モデルが特定の量子化およびコンテキスト長で必要とするVRAMまたは統合メモリの量、ならびにトークン毎秒の推定速度に関する洞察を提供します。
続きを読む
このツールは、ソフトウェアのインストールやアカウント作成なしでローカルでAIモデルを実行したい人々に特に便利です。ブラウザ内で完全に動作し、GPUの詳細がプライベートに保たれ、アップロードされることはありません。ユーザーは、VRAM、メモリ、量子化、コンテキスト長などの要件を自分のハードウェアの能力と比較し、どのモデルをダウンロードして実行するかについて情報に基づいた決定を下すことができます。
AIをローカルで実行できますか?は、Llama、Qwen、Gemma、GPT-OSSなどの人気モデルを含む12の出版社からの55のオープンウェイトテキスト生成モデルのカタログをカバーしています。このツールは、各モデルの適合判定とメモリ推定を提供し、期待される速度範囲や、利用可能な場合はコピー可能な実行コマンドを提供します。カタログは定期的に更新され、新しいモデルが追加され、既存のエントリが公式モデルカードに対して再チェックされます。
このツールは、Q4、Q5、Q8、BF16、FP8、NVFP4などの量子化オプションの詳細な説明も提供し、ユーザーがメモリのトレードオフやハードウェア特有の精度サポートを理解するのを助けます。計画ツールとして設計されており、正確な測定値ではなく推定値を提供し、ユーザーが重要なタスクに依存する前にタイトなフィットをテストすることを奨励します。
- カテゴリー機械学習プラットフォーム
- 料金モデル無料
- デプロイブラウザベース
- プラットフォームウェブ
AIをローカルで実行できますか?の主要機能
ブラウザベースの互換性チェッカー
VRAMおよびメモリ要件の推定
GPU、Mac、CPUの検出をサポート
量子化およびコンテキスト長のオプションを提供
トークン毎秒の推定速度を提供
インストールやアカウントは不要
55のオープンウェイトモデルのカタログ
コピー可能な実行コマンド
AIをローカルで実行できますか?の使い方は?
ハードウェアを選択または検出: GPU、Mac、またはCPUを選択します。
量子化とコンテキストを設定: モデルのためにこれらの設定を調整します。
適合とメモリ推定を確認: どのモデルがハードウェアに適合するかを確認します。
実行コマンドをコピー: 提供されたコマンドを使用してローカルでモデルを実行します。
AIをローカルで実行できますか?の使用例
- モデル互換性チェック
- VRAMおよびメモリ推定
- 量子化分析
- 速度推定
- ローカルAIモデル実行