الوصف
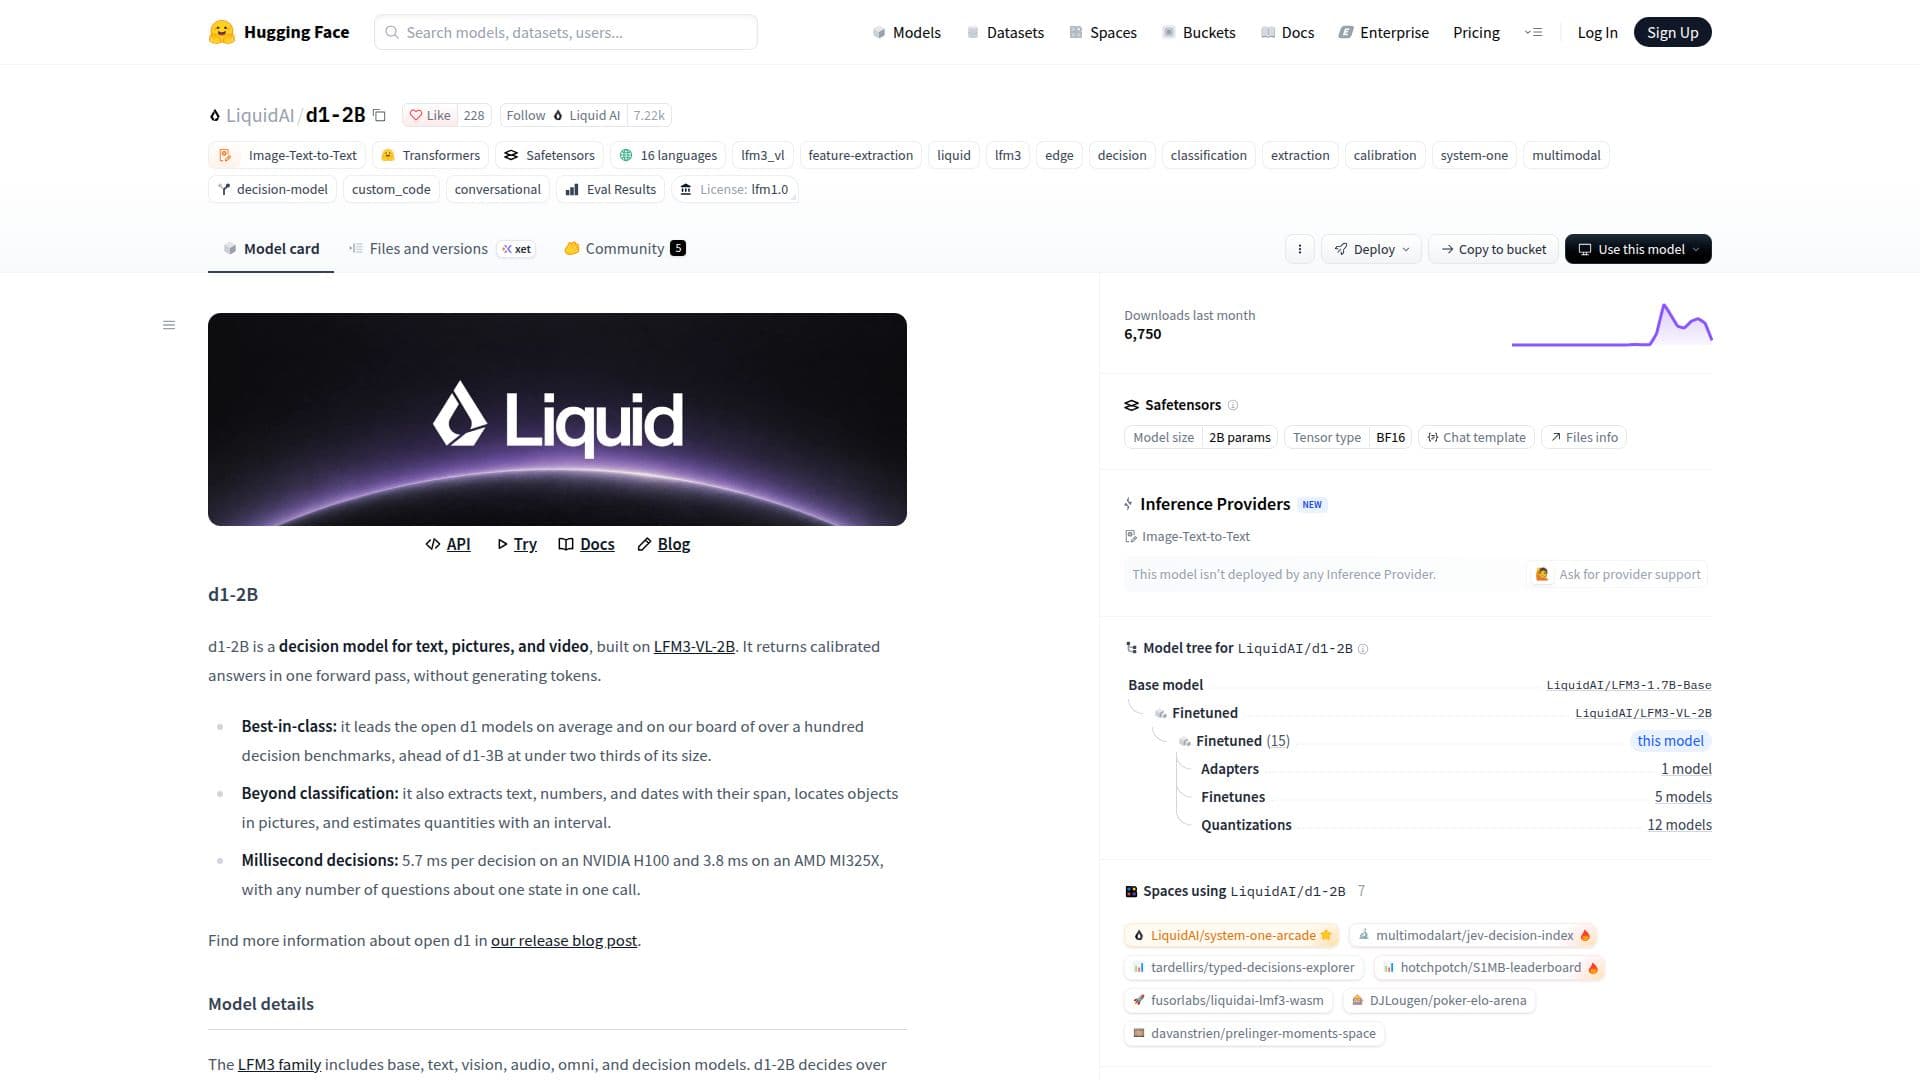
d1-2B هو نموذج قرار عالي الكفاءة تم تطويره بواسطة LiquidAI، متاح على Hugging Face. مبني على بنية LFM3-VL-2B، تم تصميم هذا النموذج لمعالجة واتخاذ قرارات بناءً على مدخلات متعددة الوسائط، بما في ذلك النصوص والصور والفيديو. إحدى الخصائص الرئيسية لـ d1-2B هي قدرته على تقديم إجابات مضبوطة في تمريرة واحدة للأمام، مما يلغي الحاجة إلى توليد الرموز، مما يساهم في سرعته وكفاءته.
قراءة المزيد
يظهر النموذج أداءً من الطراز الأول بين نماذج d1 المفتوحة، حيث يتصدر في المتوسط عبر أكثر من مئة معيار قرار. على الرغم من كونه أصغر من d1-3B، إلا أنه غالباً ما يتفوق عليه، مما يظهر تصميمه المحسن. بالإضافة إلى المهام التقليدية للتصنيف، يقدم d1-2B قدرات متقدمة مثل استخراج نصوص محددة، وأرقام، وتواريخ مع نطاقاتها، وتحديد مواقع الكائنات بدقة داخل الصور، وتقدير الكميات مع فترات محددة.
الأداء هو ميزة كبيرة، حيث يحقق d1-2B أوقات قرار تبلغ 5.7 مللي ثانية على NVIDIA H100 و3.8 مللي ثانية على AMD MI325X. يتم الحفاظ على هذه المعالجة السريعة حتى مع وجود أسئلة متعددة حول حالة واحدة في مكالمة واحدة. تتضمن عائلة LFM3، التي تشمل d1-2B، نماذج أساسية، نصوص، رؤية، صوت، شاملة، وقرارات. بينما يتعامل d1-2B مع النصوص والصور والفيديو، فإن شقيقه d1-Omni-2B يوسع القدرات لتشمل الصوت.
مع 1.92 مليار معلمة وبنية تحتية LFM3 تتكون من 24 طبقة (13 تلافيف قصيرة محكمة، 5 انتباه نافذ منزلق، 6 انتباه عالمي)، يدعم d1-2B طول سياق يبلغ 128K رمزاً ومفردات تتكون من 128,000 رمز. يقبل المدخلات كحالة (نص أو JSON)، صور، أو فيديو، مع أي عدد من الأسئلة المسماة، وينتج إجابات مكتوبة مع احتمالات دون توليد رموز. يدعم مجموعة واسعة من اللغات، بما في ذلك الإنجليزية، العربية، الصينية، الفرنسية، الألمانية، الإيطالية، اليابانية، الكورية، البرتغالية، الإسبانية، الفيتنامية، التايلاندية، الإندونيسية، الهندية، الروسية، والبولندية.
d1-2B متعدد الاستخدامات، مناسب لمراحل مختلفة من خطوط الأنابيب التي تتطلب قرارات، مثل التوجيه والتصنيف، وإدارة المحتوى، وتصنيف النوايا والمواضيع، واستخراج البيانات من الوثائق، والتقييم وإعادة الترتيب، والتفتيش البصري. يُلاحظ بشكل صريح أنه ليس نموذج دردشة. بينما يكون فعالاً للأسئلة التي تتطلب معرفة كثيفة، قد تنخفض موثوقيته بعد 64K رمزاً من الحالة. التقديرات موثوقة للعد والنقاط ولكن أقل موثوقية للكميات الحرة. يعمل النموذج في Transformers مع كوده الخاص، دون الحاجة إلى معلمات أخذ العينات.
- الفئةنماذج الذكاء الاصطناعي ونماذج اللغة الكبيرة
- نموذج التسعيرمفتوح المصدر
- النشرسحابي
- المنصاتالويب
أبرز ملامح d1-2B
نموذج قرار متعدد الوسائط (نصوص، صور، فيديو)
2 مليار معلمة
تمرير واحد للأمام للحصول على إجابات مضبوطة
لا توليد رموز
أداء معايير قرار من الطراز الأول
استخراج نصوص، أرقام، وتواريخ
تحديد مواقع الكائنات في الصور
تقدير الكميات مع فترات
سرعة قرار بالمللي ثانية (مثل 3.8 مللي ثانية على AMD MI325X)
بنية تحتية LFM3
طول سياق 128K رمز
مفردات 128,000 رمز
دعم متعدد اللغات (أكثر من 15 لغة)
مصمم للتوجيه، التصنيف، الإدارة، والاستخراج
يعمل في Transformers مع كود نموذج مخصص
البدء مع d1-2B
الوصول إلى صفحة النموذج: انتقل إلى صفحة نموذج LiquidAI/d1-2B على Hugging Face.
استكشاف الملفات: راجع تفاصيل النموذج، البنية، والمواصفات المقدمة.
تكوين الاستدلال: استخدم مكتبة Transformers لإعداد النموذج للاستدلال.
تحضير المدخلات: قدم حالة (نص أو JSON)، صور، أو فيديو، مع أسئلة مسماة.
تنفيذ المكالمات: استخدم `system_one` للطلبات الفردية أو `system_one_batch` للطلبات المجمعة.
تفسير المخرجات: استقبل إجابات مكتوبة مع احتمالات، دون توليد رموز.
حالات استخدام d1-2B
- التوجيه والتصنيف
- الإدارة والحواجز
- تصنيف النوايا
- تصنيف الموضوعات
- الاستخراج من الوثائق
- التقييم وإعادة الترتيب
- التفتيش البصري
- اتخاذ القرار متعدد الوسائط