

لتتحقق من مخرجات الذكاء الاصطناعي دون أن تغرق فيها، كفّ عن محاولة التحقق من كل جملة. استخرج الادعاءات، ورتّبها بحسب ما سيتضرر إن كانت خاطئة، وراجع الادعاءات التي يقوم عليها نصك في مصدرها الأصلي، فلا المرجع المرتّب يثبت شيئًا، ولا قول النموذج نفسه «نعم، أنا متأكد».
وتكلفة إهمال هذه الخطوة في ازدياد مستمر. فقد سجلت قاعدة بيانات عامة لقرارات المحاكم المتعلقة بمواد مختلقة بالذكاء الاصطناعي 2,125 قرارًا وقت كتابة هذا المقال، منها 1,193 قرارًا في هذا العام وحده (قاعدة بيانات AI Hallucination Cases). وفي وقت سابق من هذا العام سحبت KPMG تقريرًا منشورًا بسبب هلوسات يبدو أن الذكاء الاصطناعي تسبب فيها، بعد أن وصفت مؤسسات ذُكرت في التقرير ما ورد فيه عن استخدامها للذكاء الاصطناعي بأنه «غير صحيح أو مضلل» (TechCrunch).
لم تختفِ الهلوسات، بل صار اكتشافها أصعب، لأن النص المحيط بها سلس والمراجع المزيفة تشبه الحقيقية. ستجد أدناه أنواع الادعاءات الأكثر عرضة للخطأ، وسبب قصور المراجعة الذاتية، وسير عمل مرتبًا حسب المخاطر مع prompts جاهزة للنسخ، ونظرة صريحة إلى أدوات الاستناد إلى المصادر مثل Gemini Notebook (المعروف سابقًا باسم NotebookLM) وPerplexity وConsensus.
المراجع المزيفة صارت ظاهرة في قاعات المحاكم
المحامون كانوا أول من تعلّم هذا الدرس، وعلى الملأ. تسجّل قاعدة بيانات Damien Charlotin القرارات التي رأت فيها محكمة أو هيئة قضائية، صراحةً أو ضمنًا، أن أحد الأطراف اعتمد على مواد مختلقة، وغالبًا ما تكون سوابق قضائية لا وجود لها. وهي لا تحاول إحصاء كل مرجع مزيف قُدّم يومًا، بل فقط ما تناولته محكمة أو هيئة كتابةً. ومع هذا المعيار الضيق، يبقى المنحنى حادًا.
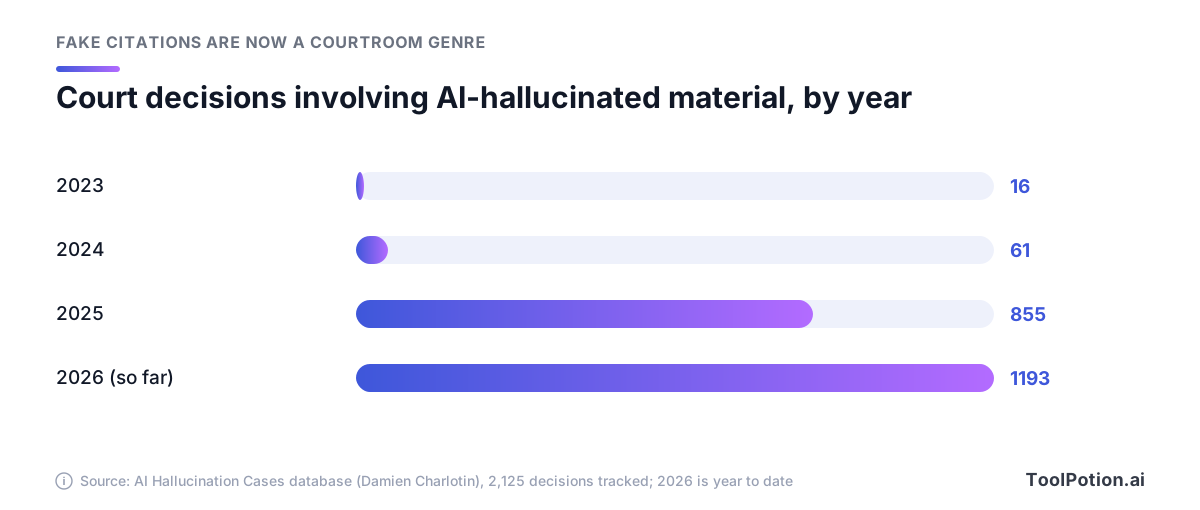
عمود 2026 لا يغطي سوى جزء من السنة، ومع ذلك تجاوز عمود 2025. يمثّل الأشخاص الذين يترافعون عن أنفسهم 1,227 من القرارات المتتبَّعة، ويمثّل المحامون 840 قرارًا، وتضم القائمة 33 قرارًا جاءت فيها المادة المختلقة من قاضٍ. وتتصدر الولايات المتحدة بـ 1,459 قرارًا، تليها كندا بـ 223 وأستراليا بـ 112.
والقضية التي بدأت كل شيء ما زالت أفضل درس. ففي قضية Mata v. Avianca عام 2023، سأل محامٍ في قضية اتحادية في نيويورك ChatGPT عمّا إذا كانت إحدى القضايا التي قدمها له حقيقية، فأجاب بنعم. وحين ألحّ عليه، قال إن القضية «موجودة فعلًا ويمكن العثور عليها في قواعد بيانات البحث القانوني مثل Westlaw وLexisNexis» (CNN). لم تكن القضية موجودة، وغرّمت المحكمة المحامين وشركتهم 5,000 دولار. وذكر المحامي في إفادة مشفوعة بالقسم أنه «لم يكن يعلم أن محتواه قد يكون غير صحيح».
وكبرت الفواتير منذ ذلك الحين. ففي قضية Couvrette v. Wisnovsky، وجدت محكمة اتحادية في أوريغون خمسة عشر مرجعًا مختلقًا وسبعة اقتباسات محرّفة في مذكرات المدّعين. فشطبت المذكرات، ورفضت الدعاوى رفضًا نهائيًا، وفرضت عقوبات وتكاليف بلغت 110,204 دولارات، وهي أكبر قيمة إجمالية لقضية أمريكية في القاعدة. وإن كنت تستخدم الذكاء الاصطناعي في العمل القانوني، فدليلنا عن الذكاء الاصطناعي في العمل القانوني يشرح الإعدادات الأكثر أمانًا.
والمحاكم ليست سوى الساحة الأكثر ظهورًا. فقد وافقت Deloitte على رد جزء من مبلغ 440,000 دولار دفعته الحكومة الأسترالية مقابل مراجعة استشهدت بتقارير لا وجود لها منسوبة إلى أساتذة جامعات، وتضمنت إشارة مختلقة إلى قرار قضائي حقيقي. وكشفت الشركة لاحقًا أنها استخدمت سلسلة أدوات مبنية على GPT-4o من Azure OpenAI (The Guardian). وسحبت EY هذا العام تقريرًا عن برامج الولاء بدا أنه يتضمن هوامش مزيفة، بحسب تقرير TechCrunch نفسه الذي تناول KPMG. وفي 2025 نشرت صحيفة Chicago Sun-Times قائمة قراءات صيفية مشتركة النشر كان 10 من كتبها الخمسة عشر مختلقة، بحسب NPR.
أين تخطئ مخرجات الذكاء الاصطناعي
نادرًا ما تخطئ النماذج في الإملاء اليوم، ويشرح باحثو OpenAI سبب انتقال الأخطاء إلى مكان آخر. فالإملاء يتبع أنماطًا يتعلمها النموذج الكبير، أما «الوقائع العشوائية قليلة التكرار، مثل تاريخ ميلاد حيوان أليف، فلا يمكن التنبؤ بها من الأنماط وحدها، ولذلك تؤدي إلى الهلوسة» (OpenAI). وحين سألوا روبوت محادثة واسع الاستخدام عن عنوان أطروحة الدكتوراه لأحد مؤلفي الورقة نفسها، أعطى ثلاث إجابات مختلفة. ولم تكن أي منها صحيحة.
وهذا يعطيك خريطة. فالأخطاء تتجمع في عدد قليل من أنواع الادعاءات، وأخطرها ما يأتي متنكرًا في هيئة دليل.
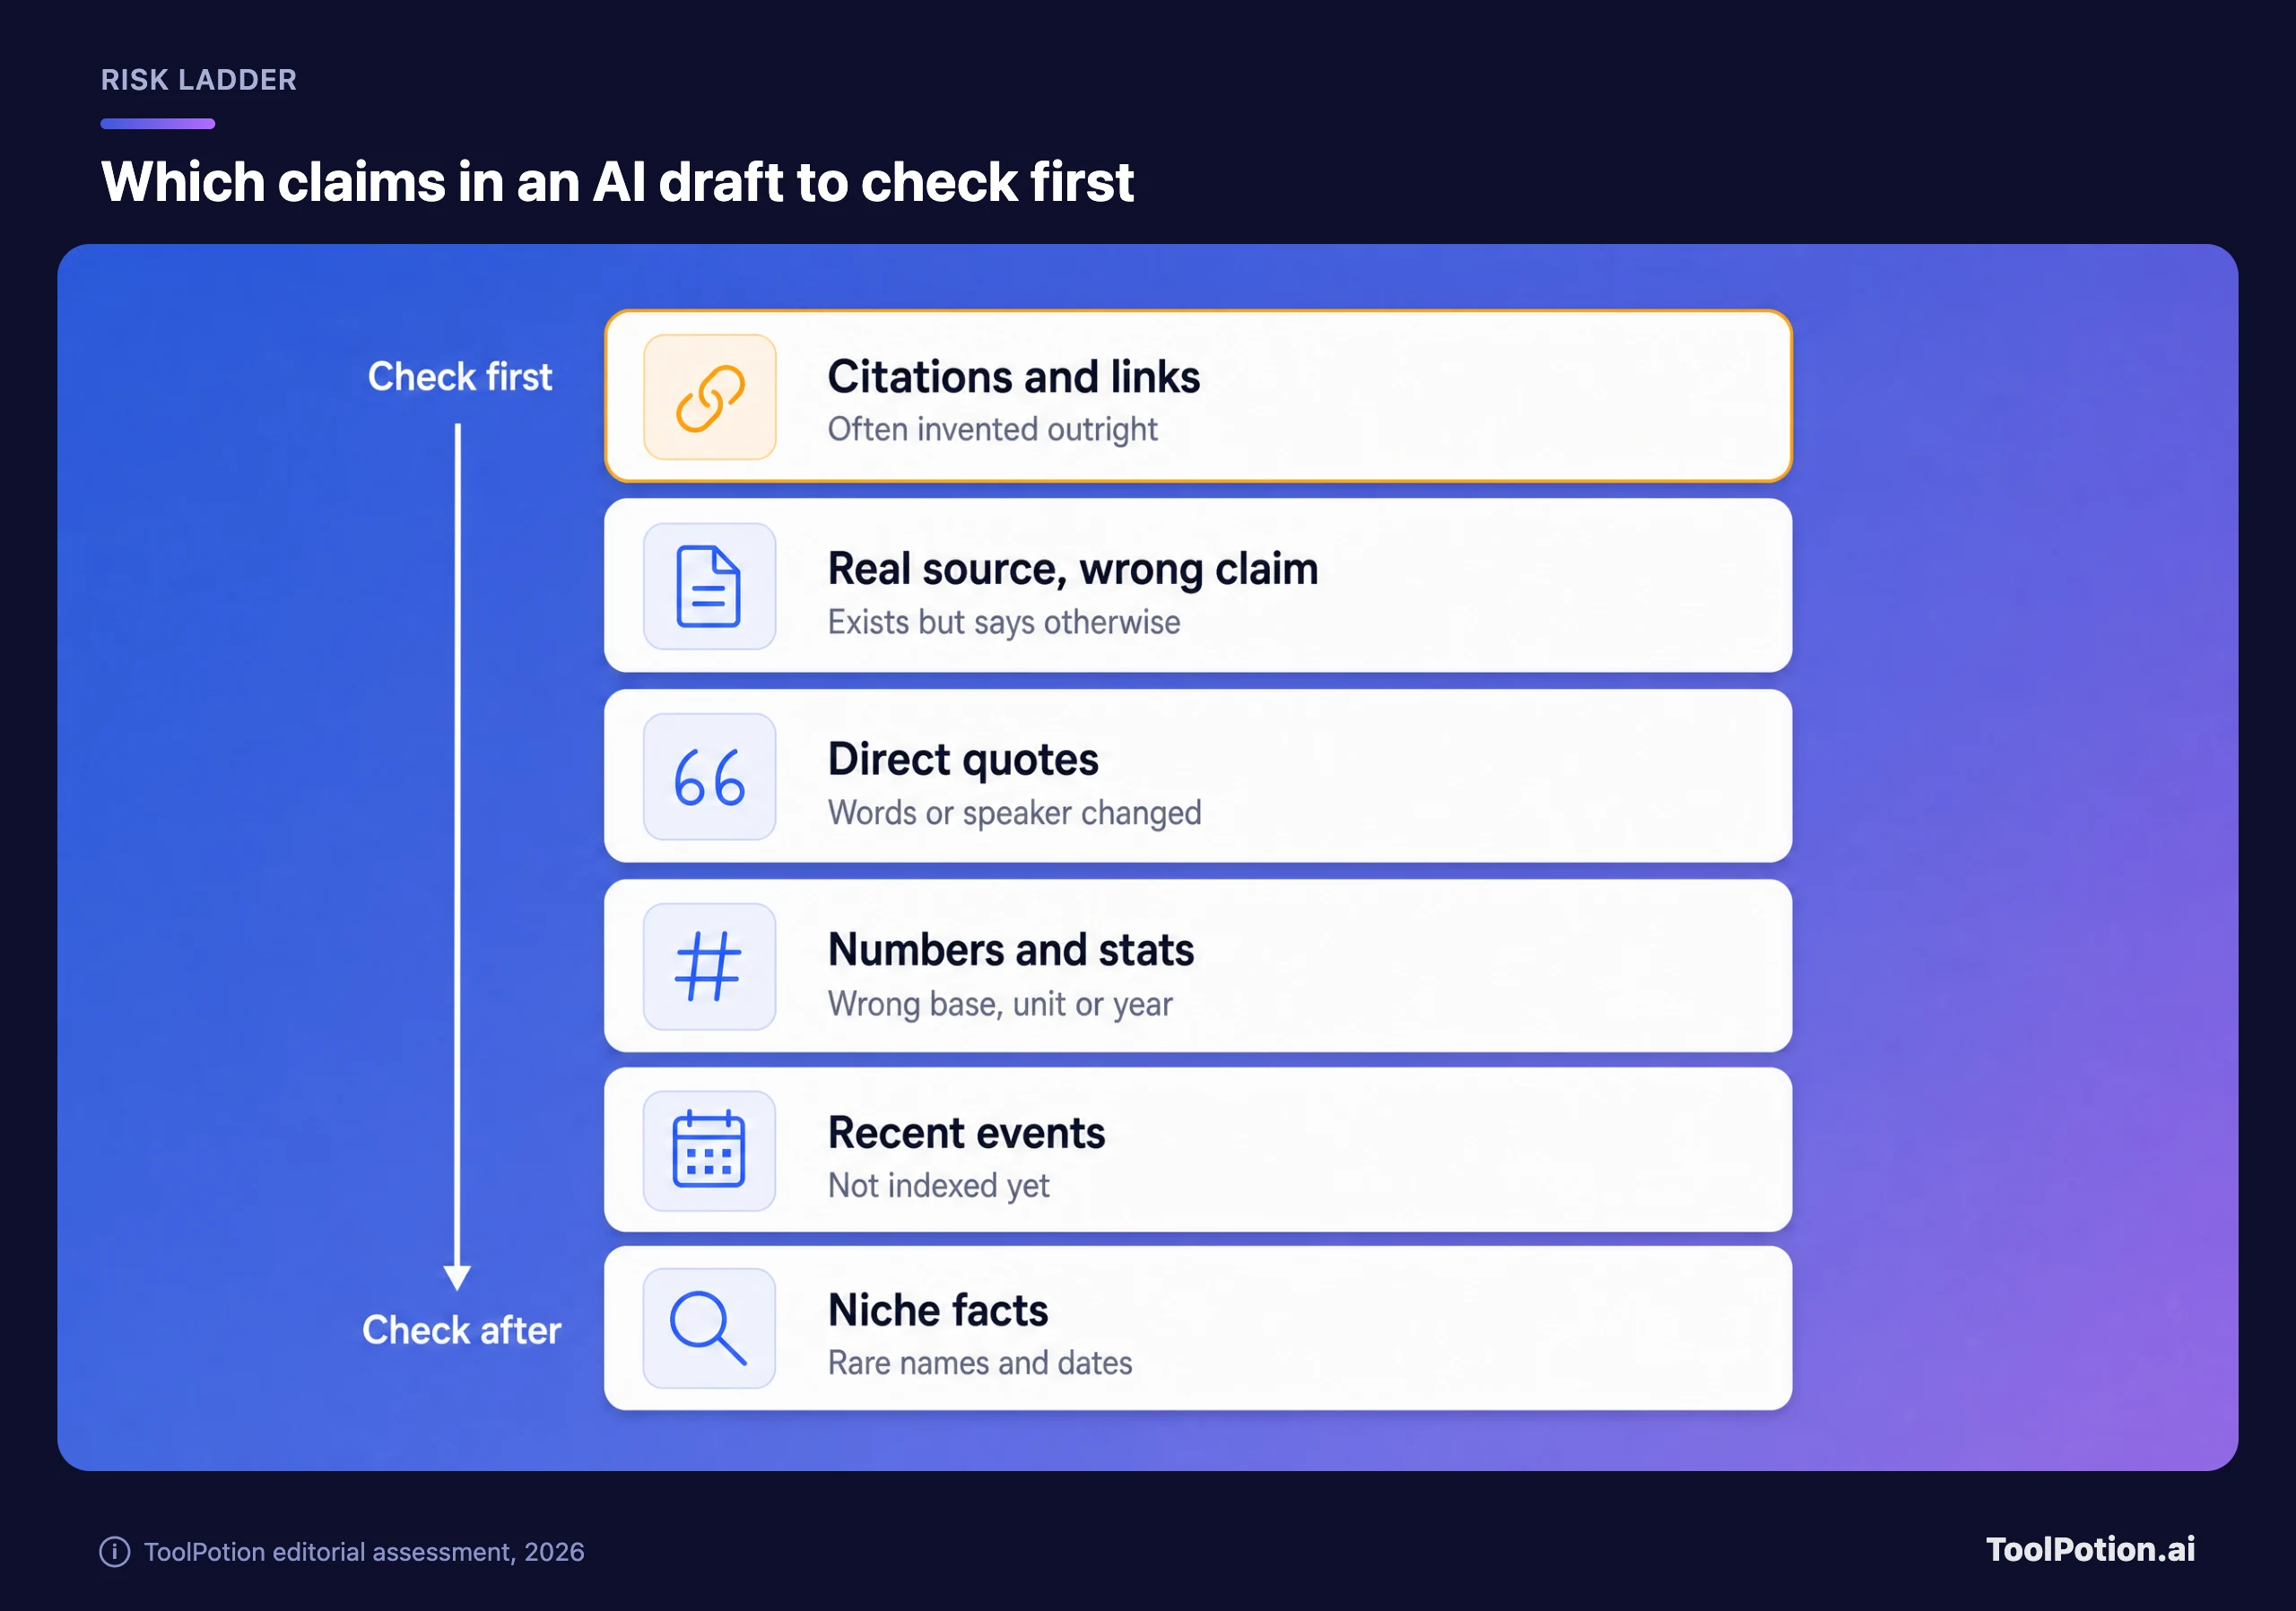
تتصدر المراجع القائمة لأنها تفشل بطريقتين. بعضها مختلق بالكامل: ففي 2025 أجرى مركز Tow Center في جامعة كولومبيا 1,600 استعلام عبر ثمان أدوات بحث بالذكاء الاصطناعي، وطلب من كل أداة تحديد مصدر مقتطف إخباري، فأخطأت الأدوات مجتمعةً في أكثر من 60%، وأحالت Grok 3 ما مجموعه 154 من استشهاداته الـ 200 إلى صفحات خطأ (Tow Center). وبعضها حقيقي لكنه يُستشهد به لشيء لا يقوله. وتحصي قاعدة Charlotin 894 قرارًا تتعلق بمواد حُرّف مضمونها، مقابل 1,752 تتعلق بالاختلاق. والرابط الذي يعمل لا يكشف هذا النوع الثاني.
تأتي الاقتباسات بعد ذلك. تسرد القاعدة 572 قرارًا تتعلق باقتباسات زائفة، ويذكر مركز مساعدة OpenAI نفسه «اقتباسات ودراسات ومراجع أو إشارات إلى مصادر غير موجودة» ضمن أنماط الفشل المعروفة في ChatGPT (OpenAI Help). أما الأرقام فتفشل بهدوء أكبر: رقم حقيقي من سنة خاطئة، أو نسبة مئوية عُرضت على أنها نقاط مئوية، أو سعر إقليمي قُدّم على أنه عالمي.
والحداثة فخ قائم بذاته. تقول وثائق المطورين في Perplexity إن الهلوسة أكثر احتمالًا حين تكون المعلومات خلف تسجيل دخول أو جدار اشتراك، أو حين تعيد عمليات البحث «نتائج ذات صلة لكنها غير مطابقة»، أو «حين لا تكون المعلومات الحديثة جدًا قد فُهرست بعد» (وثائق Perplexity). ووجدت دراسة قادتها BBC عام 2025 وشملت أكثر من 3,000 إجابة إخبارية من ChatGPT وMicrosoft Copilot وGoogle Gemini وPerplexity مشكلات دقة كبيرة، منها معلومات قديمة، في 20% منها.
ثم هناك النبرة. ففي اختبار Tow Center نفسه، أخطأ ChatGPT في تحديد 134 مقالًا، لكنه أشار إلى عدم اليقين 15 مرة فقط في 200 إجابة، وكانت الإصدارات المدفوعة من بعض الأدوات تجيب عن أسئلة أكثر بشكل صحيح، لكنها تعطي أيضًا إجابات خاطئة أكثر بثقة. وتقولها صفحة مساعدة OpenAI صراحة: «قد يعبّر النموذج عن ثقة عالية حتى في الإجابات الخاطئة». ففي مخرجات الذكاء الاصطناعي، لا تخبرك النبرة الواثقة بشيء تقريبًا عن الدقة.
لماذا لا يكفي أن تطلب من النموذج التدقيق مرة أخرى
الاختصار البديهي هو أن تعيد لصق المسودة وتسأل النموذج عمّا إذا كانت دقيقة. وقد أظهرت قضية Mata v. Avianca كيف ينتهي ذلك، والأبحاث تؤكده. فقد وجدت ورقة قُدمت في ICLR 2024 أن النماذج «تواجه صعوبة في تصحيح إجاباتها دون تغذية راجعة خارجية، وأحيانًا يتراجع أداؤها بعد التصحيح الذاتي» (Huang وآخرون).
والسبب في التدريب. فباحثو OpenAI يرون أن «إجراءات التدريب والتقييم المعتادة تكافئ التخمين على حساب الاعتراف بعدم اليقين»، كما يكافئ اختبار الاختيار من متعدد التخمين الأعمى أكثر من ترك الإجابة فارغة. ويقرّون كذلك بأن الدقة «لن تبلغ 100% أبدًا» لأن بعض الأسئلة الواقعية لا يمكن الإجابة عنها. والنموذج الذي يراجع مسودته يعتمد على المعرفة نفسها التي أنتجت الخطأ، فيميل إلى تكراره.
ومع ذلك للمراجعة الذاتية فائدة. فقد أظهرت ورقة عام 2023 عن Chain-of-Verification أن النسخة المنظّمة منها تفيد: يكتب النموذج إجابة، ثم يصوغ أسئلة تحقق، ويجيب عنها بمعزل عن المسودة، ثم يراجع. وقد خفّض ذلك الهلوسات في عدة مهام. اعتبرها وسيلة لاكتشاف المشتبه بهم، لا لتبرئتهم.
الاستناد إلى مصدر لا يعني الصحة
إعطاء النموذج مصدرًا يعمل منه يخفض معدل الخطأ، لكنه لا يصفّره. فلوحة المتصدرين العامة لدى Vectara تطلب من النماذج تلخيص أكثر من 7,700 مقال باستخدام الوقائع الواردة في كل مقال فقط، ثم تقيّم الملخصات بنموذج الكشف الخاص بـ Vectara. وحتى في هذا الإعداد السهل، يضيف كل نموذج في القائمة محتوى غير مدعوم إلى نسبة من ملخصاته (Vectara).
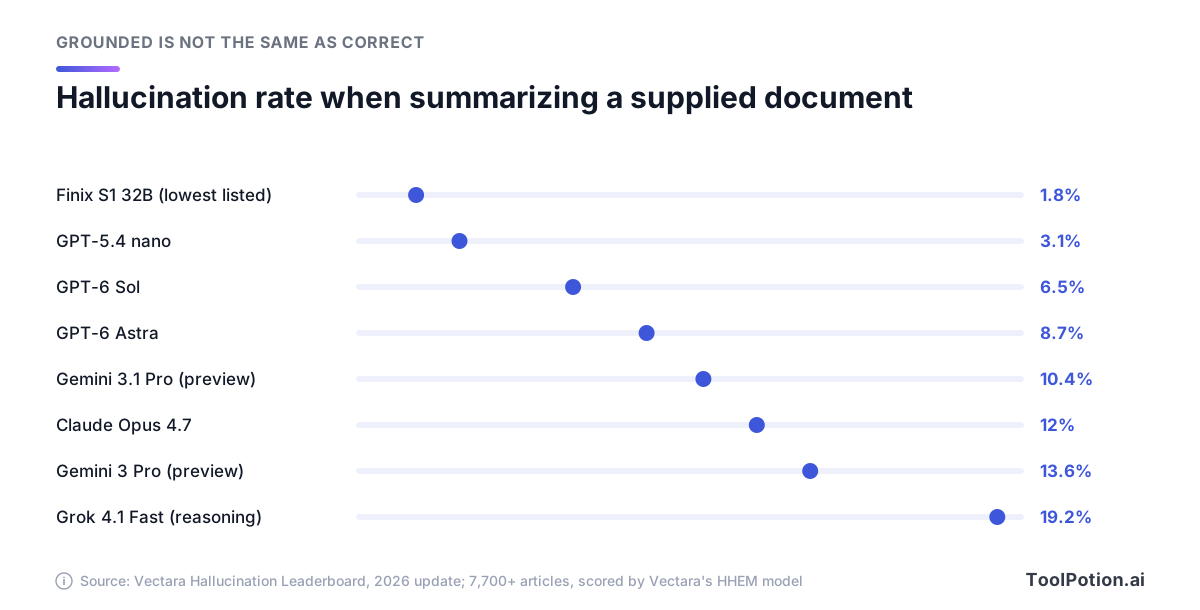
في آخر تحديث، أضاف GPT-6 Sol مادة غير مدعومة إلى 6.5% من الملخصات، وأضاف Claude Opus 4.7 ذلك إلى 12%. فنموذج يقيّم نموذجًا آخر ليس مثاليًا، وتقول Vectara بوضوح إن الاختبار لا يلتقط كل أنواع الهلوسة، كما أن الجدول لا يضم بعدُ كل الإصدارات الحالية. ومع ذلك فالاتجاه واضح. فقد وجدت دراسة عام 2024 عن أدوات البحث القانوني التي تسترجع سوابق قضائية حقيقية، ومنها Lexis+ AI وAI-Assisted Research من Westlaw، أنها ما زالت تهلوس بنسبة تتراوح بين 17% و33%. الاستناد إلى مصدر يحصر المشكلة في سؤال واحد: هل يقول المصدر هذا فعلًا؟ ومع ذلك عليك أنت أن تطرحه.
سير عمل للتحقق مرتب حسب المخاطر
الحل هو الفرز. فمعظم المسودة نسيج رابط، مثل الإطار والانتقالات والآراء التي كنت ستدافع عنها على أي حال. أما الذي يحمل النص فعددٌ قليل من الادعاءات، وهناك يقع الضرر إن حدث خطأ. افرز أولًا، ثم اصرف وقت التحقق حيث يؤتي ثماره.
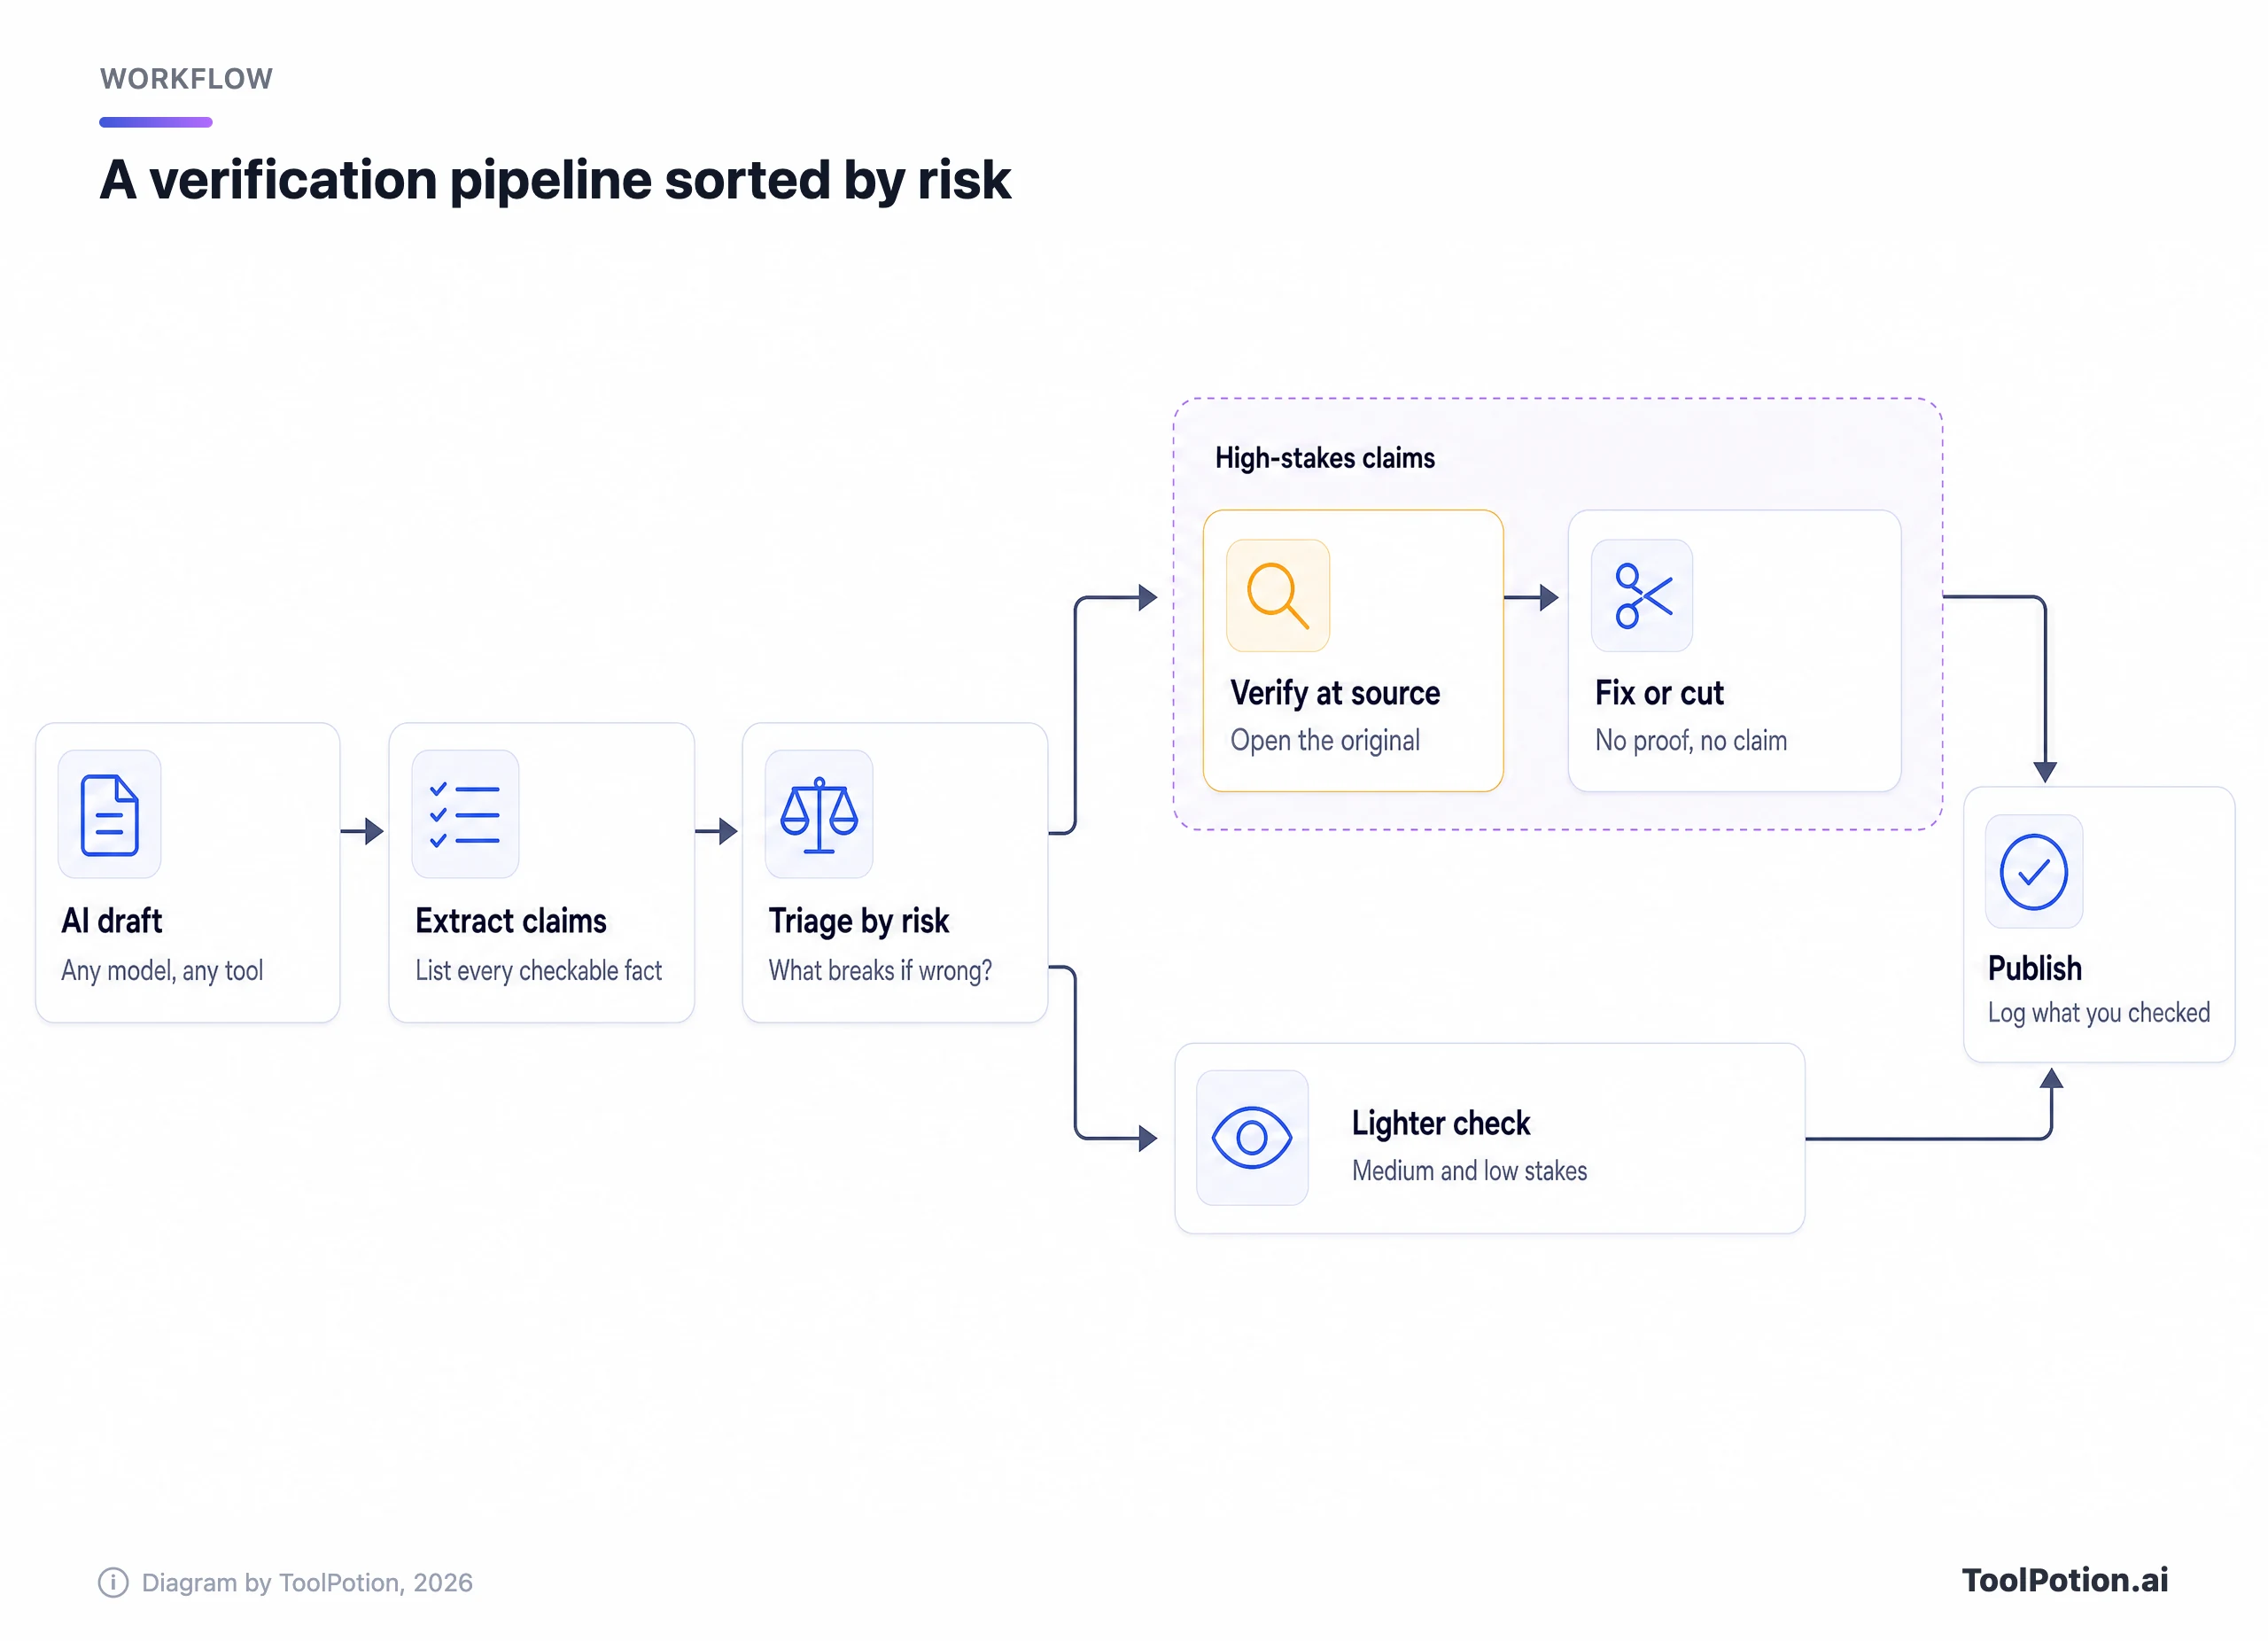
- استخرج الادعاءات. اطلب من نموذج أن يسرد كل عبارة قابلة للتحقق في المسودة: الأسماء والأرقام والتواريخ والاقتباسات والمراجع وادعاءات السببية. ستجد ادعاءات لم تنتبه إلى أنك تطرحها.
- افرز بحسب المخاطر. اسأل عمّا سيحدث إن كان كل ادعاء خاطئًا. كل ما هو قانوني أو طبي أو مالي عالي المخاطر، وكذلك كل مرجع، وكل اقتباس مباشر، وأي إحصاء في عنوان أو ملخص، وأي ادعاء عن شخص أو شركة مسمّاة. أما السياق الداعم الذي قد يكرره القارئ فمتوسط. والإطار الذي تستطيع الدفاع عنه من الذاكرة منخفض.
- تحقق من الفئة العالية في المصدر الأولي: رأي المحكمة، أو الإيداع، أو مجموعة البيانات، أو صفحة الشركة نفسها، أو الورقة البحثية ذاتها. فالخبر عن دراسة ليس هو الدراسة.
- افحص الفئة المتوسطة بعينات عبر القراءة الجانبية، وهي موضحة أدناه، واترك الفئة المنخفضة لقراءة محرر.
- صحّح أو خفّف أو احذف. إن لم تستطع تأكيد ادعاء في الوقت الذي يستحقه، فاحذفه أو انسبه بوضوح («بحسب المورّد»). لا تُبقِ ادعاءً لمجرد أنه يبدو صحيحًا.
- احتفظ بسجل. سطر واحد لكل ادعاء من الفئة العالية، يتضمن الادعاء والمصدر وموضع الدعم فيه، يستغرق دقائق ويجيب عن السؤال الذي سيطرحه عاجلًا أم آجلًا محرر أو عميل أو قاضٍ.
اجعل الجهد متناسبًا مع المدى الذي ستصل إليه المخرجات. العصف الذهني يكفيه قراءة متأنية. أما ما يُسلَّم للعميل فيتطلب فتح كل ادعاء من الفئة العالية في مصدره. وإن بدت فاتورة التحقق كبيرة جدًا، فالأرجح أن المسودة تحمل ادعاءات أكثر من اللازم، والحذف غالبًا أسرع من التحقق.
لست متأكدًا من الفئة التي تنتمي إليها مخرجاتك؟ أجب عن ثلاثة أسئلة على الأكثر أدناه.
لاحظ ما تسأل عنه الشجرة: إلى أين تذهب المخرجات وماذا تحتوي، لا أي نموذج كتبها. النموذج الأقوى يغيّر الاحتمالات، لكنه لا يغيّر من يتحمل مسؤولية الخطأ.
كيف تتحقق من المراجع والاقتباسات والأرقام
لكل نوع من الادعاءات اختبار سريع خاص به. لا شيء منها يحتاج برنامجًا خاصًا، بل الانضباط في مغادرة روبوت المحادثة وفتح المصدر الأصلي.
المراجع
تحقق من الوجود أولًا. ابحث عن العنوان أو DOI أو رقم القضية أو الرابط في قاعدة بيانات أو محرك بحث تتحكم فيه أنت، لا في روبوت المحادثة الذي أنتجه. ثم تحقق من الدعم: افتح المصدر وابحث عن الفقرة التي تسند الجملة. فإن لم تجدها في بضع دقائق، فالمرجع مرفوض. وانتبه إلى النسخة أيضًا. فقد وجد Tow Center أن أدوات البحث بالذكاء الاصطناعي كثيرًا ما أحالت إلى نسخ معاد نشرها بدل الناشر الأصلي، وقد تختلف النسخة التمهيدية عن الورقة المنشورة.
الاقتباسات
ابحث عن عبارة مميزة من خمس أو ست كلمات بين علامتي تنصيص. فإن لم تظهر في أي مكان، أو ظهرت فقط في صفحات تبدو مكتوبة آليًا، فاعتبر الاقتباس مختلقًا. وإن كان حقيقيًا، فاقرأ الفقرة المحيطة به وتأكد من القائل والتاريخ والمعنى. فالاقتباس الحقيقي المنزوع من سياقه يضلل كما يضلل المزيف.
الأرقام
أعد حساب كل ما يمكنك حسابه. تأكد من الوحدة (نسبة مئوية أم نقاط مئوية، شهري أم سنوي، أي عملة)، ومن السنة والمقام. وإن قالت المسودة إن رقمًا تضاعف، فابحث عن الرقمين معًا. أما الإحصاء بلا مصدر مسمّى فلا يدخل النص، مهما بدا معقولًا.
الأحداث الحديثة والادعاءات المتداولة
تحقق من تاريخ كل مصدر وفضّل ما نُشر بعد الحدث. وإن كان الادعاء متداولًا على الإنترنت، فإن Fact Check Explorer من Google يبحث في عمليات التحقق المنشورة ويعرض أي جهة قيّمت الادعاء وكيف. ويمكنك أيضًا رفع صورة لمعرفة ما إذا سبق التحقق منها.
قبل أن تضغط «نشر»، مرّر المسودة على قائمة التدقيق هذه. والبنود الأربعة الأولى لها وزن مضاعف.
يتبع الترجيح بيانات المحاكم: فالمراجع المختلقة والمصادر المحرّفة والاقتباسات الزائفة تملأ معظم تلك القاعدة. وإن بقيت هذه الخانات الأربع فارغة، فلا شيء آخر في القائمة يجعل المسودة آمنة للإرسال.
القراءة الجانبية للادعاءات التي لا أثر ورقيًا لها
بعض الادعاءات تصل بلا مرجع تفتحه. وفي هذه الحالة استعر عادة مدققي الحقائق المحترفين. فبعد مراقبة مجموعة Civic Online Reasoning في ستانفورد لعمل المدققين، خلصت إلى أن «أفضل طريقة للتعرف على موقع ما هي القراءة الجانبية»: أي أن تغادر الصفحة وترى ما تقوله المصادر الأخرى عنها، بدل دراسة الصفحة نفسها.
وقد حوّل Mike Caulfield هذه العادة إلى روتين من أربع خطوات يسمى SIFT (Caulfield). وهو يناسب إجابات الذكاء الاصطناعي جيدًا مع تعديل واحد: المصدر الذي تحقق فيه هو روبوت المحادثة مضافًا إليه الرابط الذي اختاره.
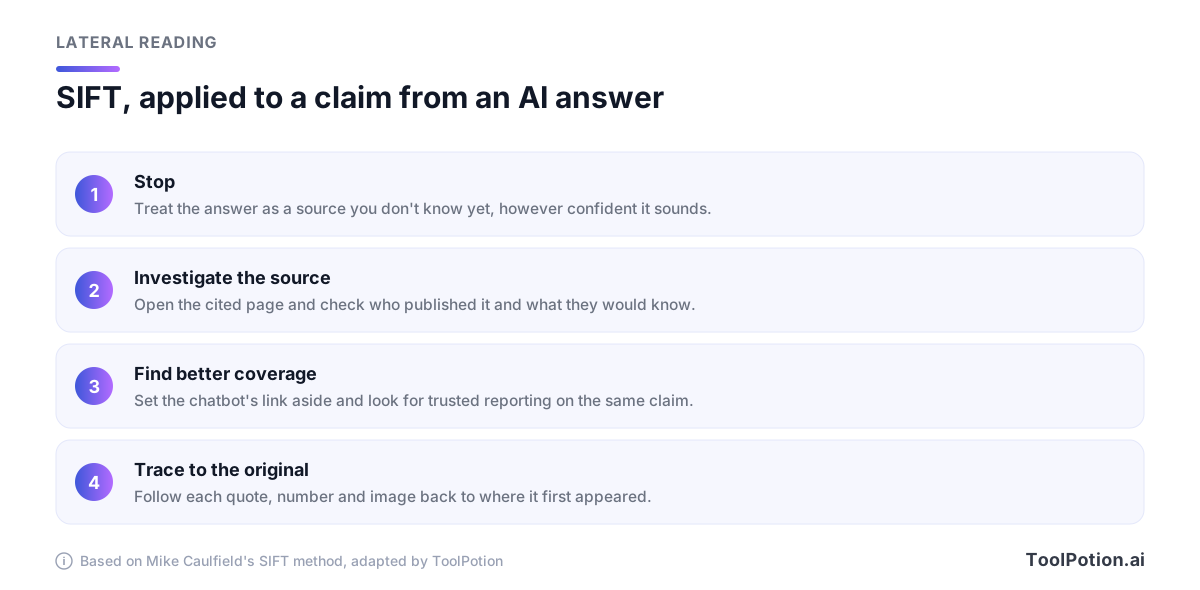
الخطوة الثالثة هي الأكثر نفعًا مع روبوتات المحادثة. فحين يكون الادعاء أهم من المقال الذي حمله، ينصح Caulfield بأن «تتجاهل المصدر الذي وصلك، وتبحث عن تقارير أو تحليلات موثوقة حول الادعاء». فابحث عن الادعاء من جديد بكلماتك أنت. وإن لم تجد تغطية مستقلة لشيء يُفترض أن يحظى بتغطية واسعة، فقد حصلت على جوابك.
والقراءة الجانبية تحسم أيضًا أمر المصادر التي يجدها النموذج بنفسه. فالرابط الحقيقي في موقع لم تسمع به من قبل مصدر ضعيف، مهما أحسن الذكاء الاصطناعي تنسيق المرجع.
prompts تجعل التحقق من المخرجات أسهل
لا يمكنك إزالة الهلوسات بالـ prompt، لكن يمكنك تشكيل المخرجات بحيث يسهل اصطياد الأخطاء. وأفضل دليل هو وثائق الشركات المطورة نفسها. تقول Anthropic إن تقنياتها الموصى بها «تقلل الهلوسات بدرجة كبيرة» لكنها «لا تزيلها بالكامل» (وثائق Anthropic). ولعادات كتابة prompts أوسع، راجع دليلنا العملي لهندسة الـ prompts.
اسمح له بأن يقول إنه لا يعرف
تطلب Anthropic وPerplexity كلتاهما من المطورين أن يسمحوا للنموذج صراحةً بالاعتراف بعدم اليقين أو بالإبلاغ بأنه لم يجد شيئًا. وتوضح أبحاث OpenAI سبب أهمية ذلك. ففي مقارنتها على اختبار SimpleQA، أخطأ نموذج امتنع عن الإجابة عن 52% من الأسئلة في 26% منها، بينما أخطأ نموذج امتنع عن 1% فقط في 75%، وبدقة متقاربة جدًا. استخدم هذا كتعليمات دائمة:
Answer using only facts you can attribute to a specific source.
For each factual claim, name the source and give a short direct quote from it.
If you are not sure of something, write "Unknown" instead of guessing.
Mark anything that is your own inference or opinion with [Inference].
اطلب الاقتباسات قبل الاستنتاجات
توصي وثائق Anthropic باستخراج اقتباسات حرفية من المستندات الطويلة قبل تنفيذ المهمة، ثم مطالبة النموذج بعد ذلك بإيجاد اقتباس داعم لكل ادعاء وسحب أي ادعاء لا يستطيع إسناده. وعمليًا يبدو ذلك هكذا:
Step 1: From the document below, extract the exact quotes relevant to [your question]. Number them. If none are relevant, write "No relevant quotes found."
Step 2: Answer using only the numbered quotes, citing them like [2].
Step 3: Review each sentence of your answer. If a sentence has no supporting quote, delete it and mark the spot with [].
اجعله ينبّه إلى الحالات المتقاربة، ولا تفرض الإيجاز
يضيف دليل Perplexity قاعدة تستحق الاستعارة: «إذا وجدت نتائج ذات صلة لكنها غير مطابقة (مثل سنة مختلفة، أو شركة أم، أو شركة تابعة)، فاذكر عدم التطابق صراحةً قبل الإجابة». وهذا يلتقط الواقعة الصحيحة عن الجهة الخاطئة، وهي من أصعب الأخطاء اكتشافًا بالعين. وتطلب قواعده النموذجية من النموذج أيضًا أن ينسب المصادر بالنطاق و«ألا يكتب الروابط كاملة».
والطول مهم كذلك. فقد وجدت Giskard، وهي شركة فرنسية لاختبار الذكاء الاصطناعي مقرها باريس، أن طلب إجابات موجزة من GPT-4o وMistral Large وClaude 3.7 Sonnet جعلها أقل دقة، لأن «النماذج حين تُجبَر على الاختصار تفضّل الإيجاز دائمًا على الدقة». ووجدت الدراسة نفسها أن النماذج أقل ميلًا إلى الاعتراض على ادعاء مثير للجدل يطرحه المستخدم بثقة. فصُغ أسئلتك بحياد: «هل صحيح أن X؟» بدل افتراض الادعاء كما في «اشرح لماذا X».
استخرج الادعاءات، ثم شغّله مرتين
يغذي هذا الـ prompt الخطوة الأولى من سير العمل. شغّله على أي مسودة، بما فيها ما كتبته بنفسك.
List every factual claim in the text below as a numbered table with three columns: the claim, its type (citation, quote, number, date, name or other), and the kind of source that would prove it.
Do not judge whether the claims are true. Do not add claims that are not in the text.
وتقترح Anthropic كذلك الفحص بأفضل N محاولة: شغّل الـ prompt نفسه عدة مرات وقارن، فالإجابات غير المتسقة تدل على هلوسات محتملة. وهو العَرَض نفسه الذي رصدته OpenAI في عناوين الأطروحة الثلاثة. الاختلاف بين التشغيلات يدلك على مواضع النظر، أما الاتفاق فلا يثبت شيئًا.
الأدوات المستندة إلى المصادر تفيد إلى حد معين
هناك فئة مختلفة من الأدوات تضيّق ما يستطيع النموذج الاستمداد منه. وهذا يحوّل «هل هذا صحيح؟» إلى «هل يقول المصدر هذا؟»، وهو فحص أسرع. لكنه لا يلغي الفحص.
غيّرت Google اسم NotebookLM إلى Gemini Notebook في وقت سابق من هذا العام وأبقته أداة بحث مستقلة، وتقول Google إن أكثر من 30 مليون شخص يستخدمها (Google). في المحادثة تجيب الأداة من المصادر التي تضيفها و«تستخدم اقتباسات ونصوصًا وصورًا مباشرة من مصادرك كاستشهادات». مرّر المؤشر فوق الاستشهاد لترى النص المقتبس، أو انقر للانتقال إليه في سياقه (مساعدة Gemini Notebook). وهذا يجعل التحقق من الدعم سريعًا. لكن اعرف الثغرات أيضًا: تقول صفحات المساعدة لدى Google إن صفحات الويب المدفوعة غير مدعومة، وإن الحواشي والتعليقات في ملفات Google لا تُستورد. أما ميزات المحادثة الوكيلية الأحدث، التي تستطيع البحث في الويب وتشغيل الشيفرة، فهي موسومة بأنها تجريبية، مع تنبيه «احرص على التحقق مرة أخرى».
وتُرفق محركات الإجابة مثل Perplexity روابط بكل إجابة، وهذه خطوة متقدمة حقًا على روبوت محادثة بلا مصادر. لكن الروابط ما زالت تحتاج إلى فتحها. فقد أخطأت Perplexity في 37% من الاستعلامات في اختبار Tow Center لعام 2025 (وقد تغيرت الأدوات منذ ذلك الحين)، وتنبّه مساعدة Gemini لدى Google نفسها إلى أن «ليست كل الإجابات تتضمن روابط أو مصادر ذات صلة».
وللادعاءات البحثية، تبني أدوات البحث الأكاديمي إجاباتها على الأوراق العلمية لا على الويب المفتوح. يبحث Consensus في الأدبيات المحكّمة ويقول إنه إن «لم يجد أدلة وثيقة الصلة كافية، فسيخبرك بذلك» بدل ملء الفراغات. وتقول Elicit إنها تدعم كل ادعاء يولّده الذكاء الاصطناعي باستشهادات على مستوى الجملة. وتبيّن Scite ما إذا كانت أبحاث لاحقة قد أيدت نتائج ورقة ما أو ناقضتها، فتلتقط فشلًا تفوّته الأدوات الأخرى: دراسة حقيقية جرى الطعن فيها لاحقًا.
وإن بنيت خط معالجة خاصًا بك، فإن Citations API من Anthropic تعيد المقطع الدقيق وراء كل ادعاء، وتقول وثائق Anthropic إن هذه الاستشهادات «مضمونة الاحتواء على مؤشرات صالحة إلى المستندات المقدَّمة». وهذا يستبعد المصادر المختلقة، لكنه لا يؤكد أن المقطع يدعم الجملة التي أُلحق بها. وتأتي أدوات فحص المراجع في آخر الخط. تقدم GPTZero كاشف هلوسات يفحص قوائم المراجع، وقد رصد فريقها تقرير KPMG، ووجد في وقت سابق من هذا العام 100 استشهاد مختلق في 51 ورقة قُبلت في NeurIPS، وهو مؤتمر رائد في الذكاء الاصطناعي، بحسب TechCrunch.
| نوع الأداة | تستند في إجاباتها إلى | ما ينبغي أن تفحصه بنفسك |
|---|---|---|
| أدوات الدفاتر (Gemini Notebook) | المصادر التي ترفعها | أن كل مقطع مستشهد به يدعم الادعاء، وأن مصادرك صحيحة |
| محركات الإجابة (Perplexity وChatGPT مع البحث) | نتائج الويب الحية | افتح كل رابط، وتحقق من تاريخه، وابحث عن الناشر الأصلي |
| البحث البحثي (Consensus وElicit وScite) | الأوراق الأكاديمية | النتائج الفعلية للورقة وحدودها وأي أعمال لاحقة تناقضها |
| واجهات الاستشهاد (Claude Citations) | المستندات التي تقدمها | دعم الادعاء، بما يتجاوز مجرد مؤشر صالح |
| أدوات فحص المراجع (GPTZero) | السجلات الببليوغرافية | هل يقول مرجع حقيقي ما تدّعيه المسودة |
للمقارنة بين الخيارات، تصفّح لوحة مساعدي البحث بالذكاء الاصطناعي ولوحة محركات البحث بالذكاء الاصطناعي ولوحة البحث في الأدبيات الأكاديمية. وتتعمق مقالاتنا الشاملة عن مساعدي البحث بالذكاء الاصطناعي ومحركات البحث بالذكاء الاصطناعي في الميزات والأسعار.
الأسئلة الشائعة
هل يمكنني استخدام نموذج ذكاء اصطناعي للتحقق من نموذج آخر؟
كخطوة أولى، نعم. فالنموذج الثاني، خصوصًا إن كان يملك بحثًا، سيشير إلى بعض الأخطاء التي فاتت الأول، والاختلافات بينهما تدلك على مواضع النظر. لكنه لا يستطيع تأكيد شيء، فقد يشتركان في الثغرات نفسها. تعامل مع ما ينبهان إليه كقائمة مهام، واحسم كل بند في مصدره. وإن كنت تختار مساعدًا ثانيًا، فدليلنا عن بدائل ChatGPT يقارن بين الخيارات الرئيسة.
هل تتحقق كاشفات الذكاء الاصطناعي من الوقائع؟
لا. أدوات مثل كاشف Originality.ai تقدّر ما إذا كان النص مكتوبًا آليًا. وهذا لا يقول شيئًا عن صحة الادعاء، فالمسودة المكتوبة بشريًا قد تكون خاطئة بالقدر نفسه. التحقق من الوقائع يحتاج إلى المصدر الأصلي.
كم ينبغي أن يستغرق التحقق من مسودة ذكاء اصطناعي؟
يتوقف ذلك على عدد الادعاءات عالية المخاطر في المسودة، لا على طولها. أحصها بعد الفرز. فشرح من 2,000 كلمة فيه أربعة إحصاءات واقتباسان عمل قصير، أما مذكرة من صفحة واحدة مليئة بالمراجع فليست كذلك.
هل يمكنني الاستشهاد بـ ChatGPT أو بروبوت محادثة آخر كمصدر؟
ليس للوقائع. نصيحة OpenAI نفسها هي «استخدم ChatGPT كمسودة أولى، لا كمصدر نهائي». استشهد بالمستند الأصلي الذي تحققت منه. وإن كانت مخرجات الذكاء الاصطناعي هي موضوع الكلام نفسه، كما في اختبار لنموذج ما، فاذكر أي نموذج استخدمت ومتى.
هل تغني وكلاء البحث المعمّق عن التحقق؟
لا. فوكلاء مثل deep research من OpenAI يجمعون تقارير بحثية موثقة من مصادر ويب كثيرة، وهذا يعطيك استشهادات أكثر لفتحها، لا ادعاءات أقل لفحصها. ومشكلة المصدر المحرّف تنطبق على كل جملة مستشهد بها، ولذلك تزداد أهمية خطوة الفرز كلما طالت التقارير.