

مخرجاتك متواضعة لأن مدخلاتك منتفخة أو قديمة أو مرتبة بشكل سيئ. ليس لأن صياغة الطلب كانت خاطئة. وثائق Anthropic نفسها تقول ذلك صراحةً: "السياق الأكثر ليس أفضل تلقائياً. مع نمو عدد الرموز، تتدهور الدقة والاستدعاء، وهي ظاهرة تُعرف باسم تعفن السياق" (Claude Platform docs). هندسة السياق هي الحل، وتُعرّفها Anthropic بأنها تنسيق "المجموعة المثلى من الرموز (المعلومات) أثناء استدلال نموذج اللغة" (Anthropic Engineering).
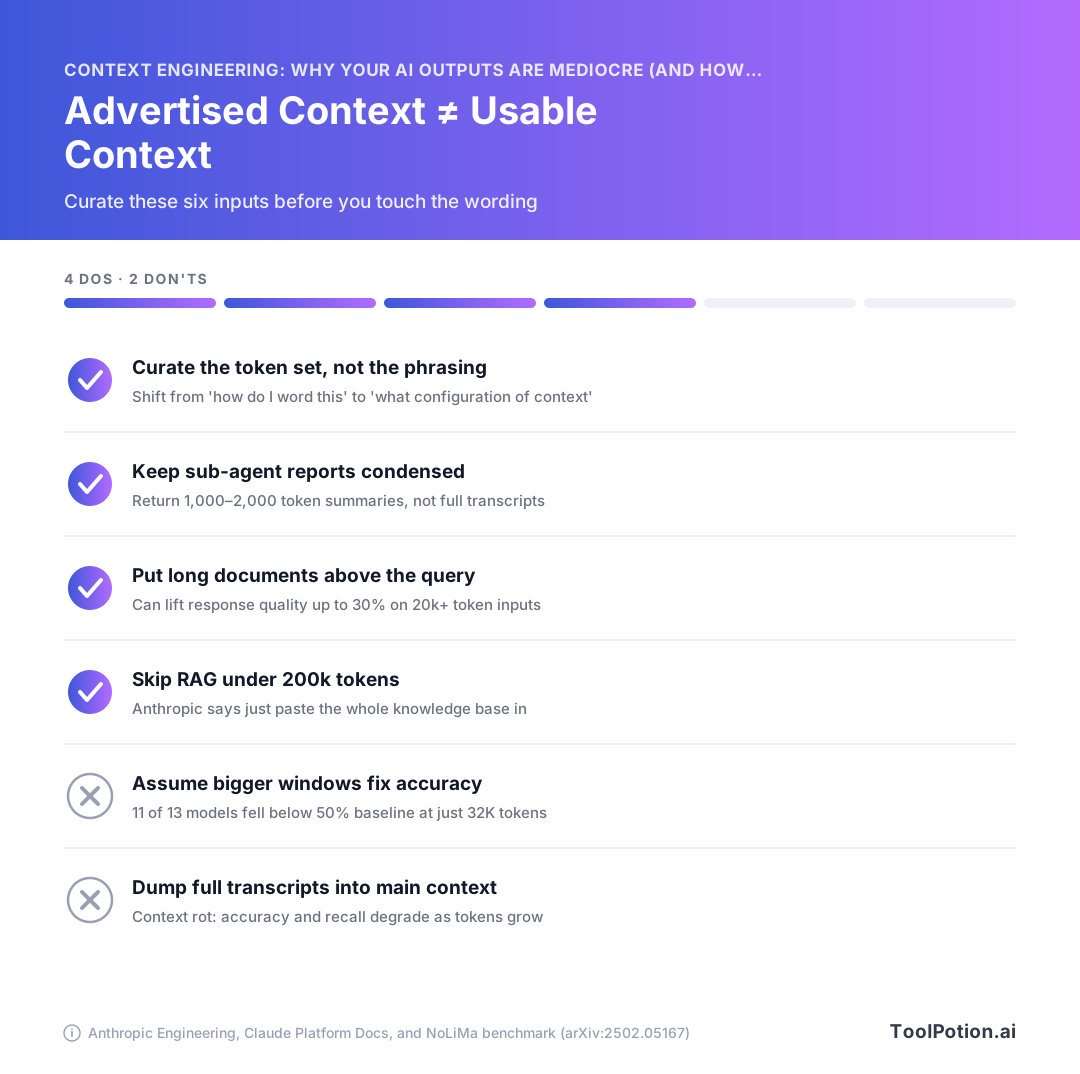
الأرقام لا ترحم العادات الجشعة. في اختبار NoLiMa، سقط 11 من أصل 13 نموذجاً — كلها تُعلن دعم سياق 128K أو أكثر — دون نصف درجتها في السياق القصير عند 32K رمز (arXiv:2502.05167).
هذا دليل عملي لمن يستخدمون ChatGPT وClaude وGemini وCopilot بدلاً من بناء أُطر عمل الوكلاء: أيُّ إعداد تُغيّر، في أي منتج، وما قيمة ذلك.
هندسة السياق هي ما حلَّت محل السحر اللغوي
إذا كانت مخرجاتك متواضعة، فإن صياغة طلبك نادراً ما تكون المشكلة. هندسة السياق هي الممارسة التي عالجت هذا: تُعرّفها Anthropic بأنها "مجموعة الاستراتيجيات لتنسيق وصون المجموعة المثلى من الرموز (المعلومات) أثناء استدلال نموذج اللغة، بما في ذلك كل المعلومات الأخرى التي قد تصل خارج نطاق الطلبات"، وتصفها بأنها التطور الطبيعي لهندسة الطلبات (Anthropic Engineering). تحول السؤال من "كيف أصيغ هذا؟" إلى "أي تكوين من السياق هو الأكثر احتمالاً لتوليد السلوك المطلوب من النموذج؟"
من «كيف أصيغ هذا؟» إلى «ما الذي يجب أن يكون في النافذة؟»
الصياغة لا تزال مهمة على الهامش. لقد توقفت فقط عن كونها موضع النفوذ الحقيقي. سؤال مصاغ بدقة تامة في مقابل نافذة منتفخة وشبه ذات صلة يخسر أمام سؤال مباشر في مقابل نافذة نظيفة، وبقية هذا المقال يُقدّم الدليل على هذا الادعاء.
معظم أدوات هندسة الطلبات الـ212 التي نتتبعها تُحسّن الجملة التي تكتبها. لا يكاد أيٌّ منها يلمس الأشياء الخمسة الأخرى التي تتشارك النافذة معها.
المدخلات الخمسة التي تتحكم فيها فعلاً
كل طلب يُجمّع نافذة من أجزاء يمكنك رؤيتها وتغييرها:
- تعليمات النظام، سواء أكانت حقل تعليمات GPT مخصص، أو وصف مشروع Claude، أو ملف CLAUDE.md في مستودعك.
- الذاكرة: ما حفظه المنتج عنك عبر الجلسات، عادةً دون عرض النص الكامل عليك.
- المستندات المرفقة وجودة تحليلها، وهي المتغير الأكثر استهانةً به في المنظومة بأكملها.
- القطع المسترجَعة، إذا كانت الأداة تقوم بالاسترجاع، إضافةً إلى ما قرر المسترجع أنه ذو صلة.
- الأدوار السابقة في المحادثة، بما في ذلك كل طريق مسدود تركته قبل عشرين رسالة.
- تعريفات الأدوات، التي تستهلك رموزاً سواء استُدعيت أداة أم لا.
هذه ستة، وأنت تتحكم في جميعها من واجهة المنتج. لا حاجة لإطار عمل أو مفتاح API.
هذا إذن دليل عملي من جانب المدخلات، مكتوب لمن يستخدمون ChatGPT وClaude وGemini وCopilot بدلاً من بناء أنظمة وكلاء فوقها. أيُّ إعداد تُغيّر، في أي منتج، وما الذي تقوله أرقام 2026 عن قيمته.
نافذة سياق الذكاء الاصطناعي: الحجم المُعلَن مقابل الحجم القابل للاستخدام
الرقم الموجود على صفحة المواصفات هو حد تخزين، وليس ضمان أداء. النموذج الذي يقبل مليون رمز سيقبلها بسعادة ثم يُجيب بشكل أسوأ مما كان سيُجيب لو اقتصر على 3,000. تعامل مع النافذة المُعلَنة كسقف غرفة، لا كحجم المكتب الذي يمكنك العمل عليه.
ما الذي يُحسَب فعلاً ضمن النافذة
أكثر مما تظن. كل جزء من طلب API يشغل نفس الميزانية: طلب النظام، وكل رسالة في الخيط بما في ذلك نتائج الأدوات والصور وملفات PDF، وتعريفات الأدوات ذاتها، ومخرجات النموذج بما في ذلك التفكير الموسَّع (Claude Platform docs). البادئات المخزنة مؤقتاً تشغل النافذة أيضاً. التخزين المؤقت للطلبات يُغيّر ما تدفعه مقابل تلك الرموز، لا ما إذا كانت تُحسَب أم لا.
لذا قد تحمل محادثة تبدو قصيرة 40,000 رمز من ملف PDF مرفق ومخططات أدوات وتفكير سابق لا تراه. هذا ما تتجاهله صفحات الموسوعة.
حاجز الـ32K الذي لا يُذكر في أي مواصفات
استبعد اختبار NoLiMa التداخل الحرفي للكلمات بين السؤال والإجابة المدفونة في أكوام البيانات، ثم اختبر 13 نموذجاً يدّعي جميعها دعم سياق 128K أو أكثر. دون 1K رمز كان أداؤها جيداً. عند 32K، انخفض 11 من أصل 13 دون نصف خط الأساس في سياقها القصير، وانخفض Llama 3.1 70B من 94.3% إلى 42.7% (NoLiMa, arXiv:2502.05167). هذا الورقة البحثية صدرت في فبراير 2025، فهي تسبق كل نموذج في الجدول أدناه. النمط العام للنتيجة صمد في الأعمال الأحدث، لكن النسب المئوية المحددة أدلة في طور التقادم، وليست بطاقة نتائج حالية.
ما هي النوافذ الفعلية اليوم (أرقام 2026)
| النموذج | نافذة السياق | الحد الأقصى للمخرجات | صور/صفحات PDF لكل طلب |
|---|---|---|---|
| Claude Fable 5.1, Opus 5, Sonnet 5 (و Mythos 5.1, Opus 4.8/4.7/4.6, Sonnet 4.6) | 1M رمز، افتراضي، تسعير قياسي | 128k | 600 |
| Claude Sonnet 4.5 والإصدارات الأقدم | 200k | — | 100 |
| OpenAI GPT-5.4 | 1,050,000 رمز | 128,000 | — |
تُطلق Anthropic نافذة الـ1M دون رأس بيتا ودون رسوم إضافية (Claude Platform docs). نافذة OpenAI أكبر اسمياً وتُسعَّر بشكل مختلف: تجاوز 272K رمز مدخل في GPT-5.4 يُفرز الجلسة بأكملها بـ2x مدخل و1.5x مخرج (OpenAI API docs). الانتفاخ هناك بنود فاتورة، ليس مجرد ضريبة جودة.
إذا كنت تقارن السعات عبر الموردين، تحقق من صفحة مواصفات النموذج نفسه بدلاً من القوائم المقارِنة: النوافذ تغيرت مرتين في 2026 وحده، والجداول القديمة منتشرة في كل مكان. دليلنا لـ324 نموذج ذكاء اصطناعي هو نقطة بداية للعثور على الصفحة الصحيحة.
تعفن السياق: لماذا إضافة المزيد تُفاقم المخرجات عادةً
للتدهور آلية، وهي ليست غامضة. المحول يجب أن ينمذج n² من العلاقات الزوجية عبر n رمز، لذا كل رمز تُضيفه يجعل كل رمز آخر يتنافس أكثر على انتباه النموذج. يُسمي فريق هندسة Anthropic هذا ميزانية انتباه محدودة، مشابهة للذاكرة العاملة البشرية، ويقول إن الانتباه يُمدَّد حتى يضعف مع نمو السياق. وصفتهم مباشرة: العثور على "أصغر مجموعة ممكنة من الرموز عالية الإشارة التي تعظّم احتمالية النتيجة المرجوة."
مشكلة ميزانية الانتباه
وثائق منتجات Anthropic نفسها تُقرّ بالنقطة بدلاً من التحايل عليها. "السياق الأكثر ليس أفضل تلقائياً"، تقول وثائق المنصة. "مع نمو عدد الرموز، تتدهور الدقة والاستدعاء، وهي ظاهرة تُعرف باسم تعفن السياق." هذا هو المورد الذي يبيعك نافذة بمليون رمز يُخبرك بعدم ملئها.
نفس السؤال، نفس الإجابة، 375 ضعف الضجيج
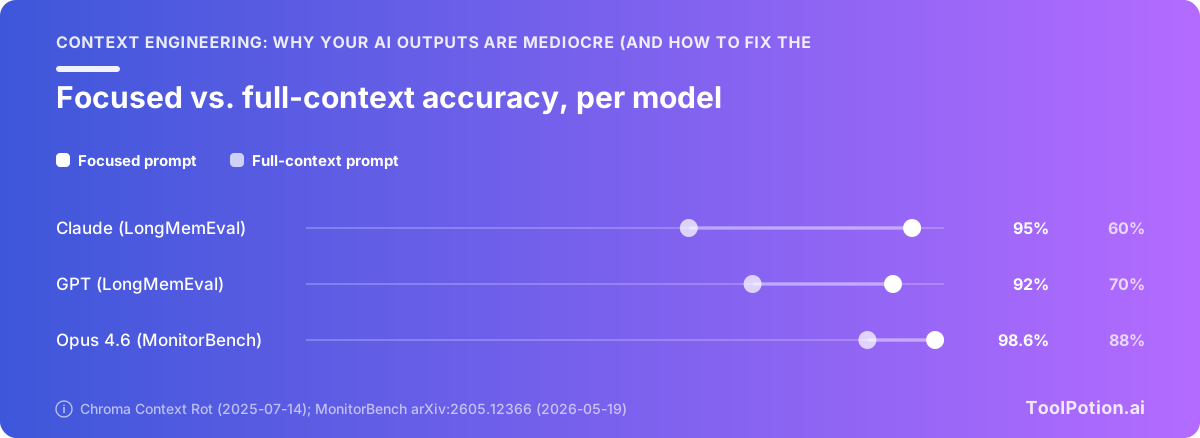
اختبرت Chroma 18 نموذجاً، بما في ذلك GPT-4.1 وClaude 4 وGemini 2.5 وQwen3، ووجدت انخفاض الموثوقية مع المدخلات الأطول حتى في المهام التافهة كالاسترجاع وتكرار الكلمات (Chroma). جولة LongMemEval هي التي يجب تذكرها. أدّت كل عائلة نماذج بشكل أفضل بكثير على طلبات مُركّزة من حوالي 300 رمز تحتوي فقط على الأدوار ذات الصلة مقارنةً بالطلبات الكاملة من حوالي 113k رمز تحمل تاريخ المحادثة بأكمله، مع ظهور أوسع فجوة في نماذج Claude. نفس السؤال. نفس الإجابة موجودة في السياق في كلتا الحالتين. المتغير الوحيد كان كمية المادة غير ذات الصلة المحيطة بها.
وجدت Chroma أيضاً أن النماذج حققت نتائج أفضل في أكوام البيانات المُبعثَرة مقارنةً بالمستندات المتسقة منطقياً، عبر جميع الـ18. النص المحيط المتسق يمنح النموذج أماكن أكثر تبدو معقولة للوقوف عندها. صدر هذا التقرير في 2025-07-14، مما يعني أنه مضى عليه أكثر من عام وهو يسبق جيل النماذج الحالي.
التأثير لم يتلاشَ مع الوقت. في MonitorBench، أدى إلحاق 800k رمز من الإجراءات الحميدة وغير ذات الصلة إلى انخفاض استدعاء Opus 4.6 من 98.6% إلى 88% (arXiv:2605.12366). لم يتغير شيء في المهمة. فقط الحشوة.
أين يعضّك هذا في الاستخدام الاعتيادي
لقد رأيت هذا بالفعل دون تسميته. المحادثة التي أحكمت موجزك في الرسالة 12 وتُنتج حشواً عاماً في الرسالة 90، لأن الموجز مدفون الآن تحت 78 رسالة من المسودات نصف المهجورة. دفتر NotebookLM الذي أضفت إليه 40 مصدراً للشمولية فبدأت تحصل على إجابات أكثر غموضاً مما حصلت عليه عند ثمانية. جلسة البرمجة التي ينسى فيها النموذج قيداً ذكرته منذ ساعة ويُعيد الكتابة بثقة متجاهلاً إياه.
لا شيء من هذا يعني أن النموذج يتكاسل. أنت تُنفق ميزانية الانتباه على رموز لا تستحق مكانها.
إعداد المستندات: الخطوة التي يتخطاها الجميع تقريباً
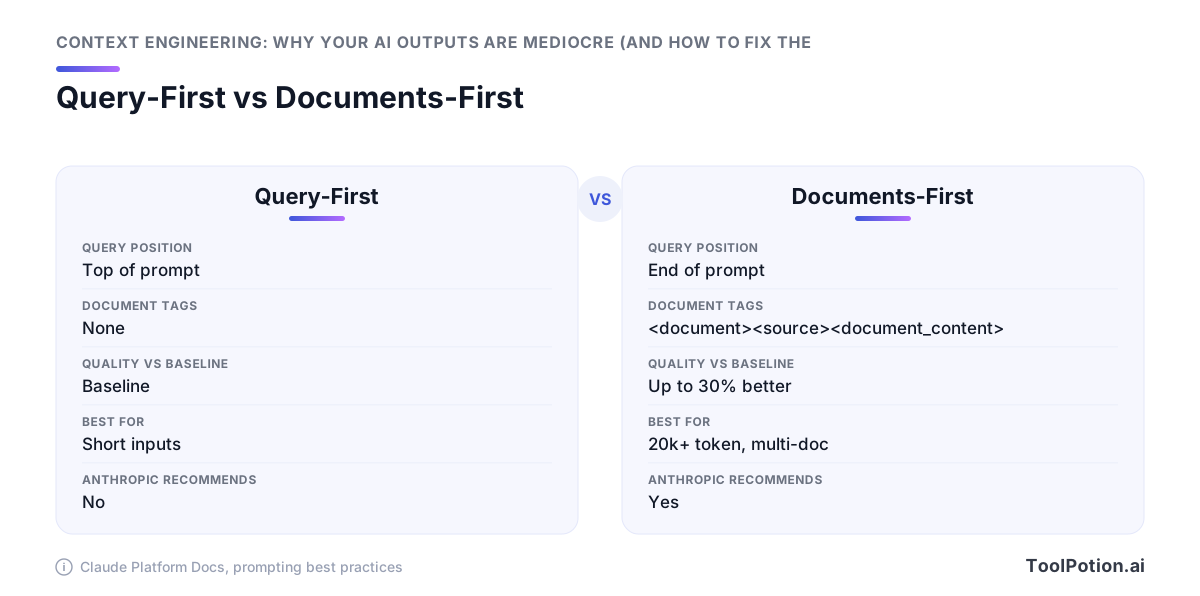
مكان وضع المستند في الطلب يُغيّر الإجابة التي تحصل عليها. للمدخلات التي تتجاوز 20,000 رمز، تُخبرك وثائق طلبات Anthropic بوضع البيانات المطوّلة في الأعلى، فوق استفسارك وتعليماتك وأمثلتك: "الاستفسارات في النهاية يمكن أن تُحسّن جودة الاستجابة بنسبة تصل إلى 30 بالمئة في الاختبارات، خاصةً مع المدخلات المعقدة متعددة المستندات" (Claude Platform docs). معظم الناس يفعلون العكس. يكتبون السؤال ثم يلصقون التقرير أسفله.
ضع المحتوى الطويل في الأعلى
تُقدّم لك الوثائق نفسها هيكلاً يستحق النسخ حرفياً: لفّ كل مستند في وسوم <document> مع وسوم فرعية <source> و<document_content>، حتى يستطيع النموذج تحديد أين ينتهي ملف وأين يبدأ التالي (Claude Platform docs). ثم اطلب منه اقتباس المقاطع ذات الصلة قبل الإجابة. هذا السطر الواحد يُجبر النموذج على تحديد موقع الأدلة في النص بدلاً من إعادة بنائها مما يتذكره بشكل جزئي، ويمنحك شيئاً يمكن التحقق منه حين تبدو الإجابة خاطئة.
<document>
  <source>Q3-board-deck.pdf</source>
  <document_content>...full text here...</document_content>
</document>
<document>
  <source>renewal-contract-2026.pdf</source>
  <document_content>...full text here...</document_content>
</document>

Before answering, quote the passages you relied on.
Question: which renewal terms conflict with the Q3 revenue plan?
صنّف مصادرك حتى يتمكن النموذج من الاستشهاد بها
تحفظ واحد قبل أن تُعيّر هذا كمعيار: الموردون لا يتفقون. Anthropic تضع البيانات الطويلة أولاً؛ توجيهات Google تشير إلى العكس، وتُخبرك بإغلاق تعليماتك. لذا قالب طلب مأخوذ من دليل Gemini ولُصق في Claude قد يُؤدي بشكل أدنى دون أن يبدو مكسوراً. شغّل نفس مجموعة المستندات بكلا الترتيبين على النموذج الذي تدفع مقابله فعلاً، عشرة أسئلة لكل منهما، واحتفظ بالترتيب الفائز. عشرون دقيقة من العمل في مقابل ادعاء بتأثير 30%.
اختيار المحلل اللغوي يُحدد ما يراه النموذج أصلاً
لا شيء من هذا يُنقذ استخراجاً مُشوَّهاً. جدول فاتورة ممسوح ضوئياً يخرج كسطر واحد متواصل، ورقة بعمودين مُتشابكة صفاً بصف، حاشية سفلية مدرجة في منتصف جملة: النموذج يقرأ تلك الفوضى بأمانة ويُجيب منها. خطوة الاستخراج لديك تُحدد السقف للدقة، وكل شيء لاحق مُقيَّد بها. تعامل مع المحلل اللغوي كقرار جودة واختبر اثنين أو ثلاثة على أصعب ملف حقيقي لديك قبل الالتزام. دليلنا يُدرج 217 أداة ذكاء اصطناعي لمستندات وملفات PDF، والفجوة بين الجيد والرديء منها تظهر في مخرجاتك، لا في صفحات تسويقها.
جودة الاسترجاع: قطع أقل وأفضل تتفوق على القطع الأكثر
قبل بناء طبقة استرجاع، تحقق مما إذا كنت تحتاجها فعلاً. توجيهات Anthropic نفسها تقول إنه إذا كانت قاعدة معرفتك أصغر من 200,000 رمز (حوالي 500 صفحة)، يمكنك تضمين القاعدة بأكملها في الطلب دون استرجاع على الإطلاق (Anthropic Engineering). معظم الويكيات الداخلية وكتيبات المنتج ومجموعات السياسات تقع تحت هذا الحد.
هل تحتاج إلى الاسترجاع أصلاً؟
إذا كان المحتوى يناسب، تجاوز قاعدة بيانات المتجهات. ستتجنب قرارات التقطيع وانجراف التضمين وفئة كاملة من الإخفاقات الصامتة حيث لا تصل الفقرة الصحيحة أبداً إلى الطلب. ادمج ذلك مع التخزين المؤقت للطلبات حتى لا تدفع السعر الكامل لنفس الـ200k رمز في كل مرة.
فوق هذا الحجم، يصبح الاسترجاع غير اختياري وتصبح الجودة مجموعة من الإصلاحات الصغيرة المتراكمة.
الإصلاحات الثلاثة المتراكمة
قاست Anthropic كلاً منها على حدة. إلحاق سياق خاص بالقطعة بكل قطعة قبل التضمين خفّض إخفاقات الاسترجاع الأعلى-20 من 5.7% إلى 3.7%، أي انخفاض بنسبة 35% تقريباً. إضافة بحث هجين BM25 سياقي خفّض الإخفاقات إلى 2.9%، أي خفض 49%. إضافة مرحلة إعادة ترتيب فوقها أوصلتها إلى 1.9%، أي خفض إجمالي 67% (Anthropic Engineering). كل خطوة غير لامعة وحدها والثلاثة معاً تُثلّث تقريباً تحسين الأولى.
تشذيب تعريفات الأدوات يُحسَب أيضاً
مخططات الأدوات هي سياق. إذا أعطيت نموذجاً أربعين تعريف أداة ويحتاج اثنتين، فقد دفعت مقابل ثمانية وثلاثين مشتِّتاً. عمل RAG-MCP استرجع فقط المخططات ذات الصلة بدلاً من إدراجها جميعاً وخفّض رموز الطلب بأكثر من النصف بينما ارتفعت دقة اختيار الأداة من 13.62% إلى 43.13% (arXiv:2505.03275). هذا نفس الانضباط المُطبَّق على اختيار القطع، لكن بمستوى أعلى.
نمط الوكيل الفرعي لدى Anthropic يمتد به أكثر: وكلاء متخصصون يقومون بالحفر ويعودون بملخصات مكثّفة من حوالي 1,000 إلى 2,000 رمز إلى وكيل منسّق، حتى لا يرى السياق الرئيسي سجلات البحث الخام أبداً (Anthropic Engineering). إذا كنت تختار المكونات بدلاً من كتابتها، دليلنا يُدرج 550 وكيل ذكاء اصطناعي ومجموعة من أُطر الاسترجاع والوكلاء التي تُطبّق هذه الأنماط جاهزة.
ميزات الذاكرة: أيُّ إعداد تُغيّر في كل أداة
كل منتج ذكاء اصطناعي استهلاكي الآن يُدرج أشياء في سياقك لم تكتبها أنت. حقائق محفوظة، محادثات سابقة، نشاط التطبيق، ملفات المشروع المحمّلة. لا يمكنك ممارسة هندسة السياق في تطبيق دردشة حتى تعرف ما الذي يجلس بالفعل في النافذة قبل أول كلمة لك.
ذاكرة خاطئة تُكلّف أكثر من لا ذاكرة. إنها نص يبدو عالي الإشارة يتعامل معه النموذج كحقيقة، ويجلس قرب تعليماتك حيث الانتباه أقوى. مسميات وظيفية قديمة، اسم عميل سابق، تفضيل ضبطته مرة لمهمة استثنائية: كل واحد يُحيز كل إجابة تليه بهدوء.
ChatGPT: مفتاحان مستقلان
ذاكرة ChatGPT آليتان، لا واحدة. الذكريات المحفوظة حقائق منفصلة مُخزَّنة يمكنك قراءتها وحذفها فردياً، بينما مرجع تاريخ الدردشة يسحب من محادثاتك السابقة عبر مسار استرجاع منفصل (Embrace The Red). إيقاف أحدهما يُبقي الآخر يعمل. إذا كانت مخرجاتك لا تزال تحمل رائحة مشروع الشهر الماضي بعد مسح الذكريات المحفوظة، فمفتاح التاريخ هو ما فاتك.
Claude: معرفة المشروع وكتابة الذاكرة في منتصف المحادثة
منذ توحيد Cowork في 25 أغسطس 2026، يكتب Claude الذكريات في منتصف المحادثة بدلاً من حدود الجلسات فقط، لذا ما تقوله في الدردشة ينتقل إلى الجلسات اللاحقة (TechCrunch). هذا يعني أن ملاحظة عارضة يمكن أن تصبح سياقاً دائماً.
معرفة المشروع هي الرافعة الأفضل، لأنها مجموعة بيانات اخترتها أنت. أبقِها تحت قاعدة Anthropic الإرشادية البالغة 200,000 رمز (حوالي 500 صفحة) ويمكنها الانتقال بالكامل دون طبقة استرجاع تخمّن أيُّ القطع مهمة (Anthropic). قلّمها كقائمة قراءة، لا كأرشيف.
Gemini: ثلاثة أنظمة متداخلة حيث «الإيقاف» ليس «الحذف»
Gemini يُطبّق طبقات من السياق الشخصي والمعلومات المحفوظة التي كتبتها بنفسك والنشاط من تطبيقات Google المتصلة. تعطيل مصدر يوقف الكتابات الجديدة. لا يُزيل ما هو مُخزَّن بالفعل، لذا يعني التدقيق زيارة كل عنصر تحكم على حدة والحذف، لا مجرد إيقاف الأشياء.
NotebookLM: البديل المحدود المصادر
يضع NotebookLM سقفاً لعدد المصادر التي يمكن أن يحتويها الدفتر، والسقف يعمل لصالحك. يُجبر على التنسيق الذي يُتيح له الآخرون الثلاثة تخطيه، وهو نفس الانضباط الذي تصفه Anthropic: العثور على أصغر مجموعة من الرموز عالية الإشارة التي تُحقق النتيجة التي تريدها (Anthropic). حين يحتاج سؤال ما ثمانية مستندات وليس ثمانين، ابدأ من هناك.
اختر أداة واحدة كمساعدك الحامل للذاكرة وأبقِ الباقي نظيفاً. عبر 13,174 تطبيق ذكاء اصطناعي في دليلنا، الأدوات التي تجعل الذاكرة قابلة للتدقيق عنصراً بعنصر تستحق أكثر من تلك التي تعد بتذكر كل شيء.
تعليمات مستوى المشروع هي سياق قابل لإعادة الاستخدام
أرخص سياق ستكتبه هو السياق الذي تكتبه مرة واحدة. كل أداة ذكاء اصطناعي جادة الآن لديها مكان للتعليمات الثابتة التي تُدرَج في كل جلسة: AGENTS.md وCLAUDE.md في المستودع، ومشاريع Claude، والتعليمات المخصصة لـChatGPT، وملفات تعليمات Copilot. معظم الناس يتركون تلك الأماكن فارغة ثم يُعيدون كتابة نفس الفقرات الثلاث من الخلفية في كل دردشة جديدة.
لماذا ملف التعليمات الثابتة يتفوق على إعادة الشرح
قاست دراسة عبر 10 مستودعات و124 طلب سحب ما يفعله ملف AGENTS.md على مستوى المستودع بسلوك الوكيل، والنتيجة ليست فقط عن الدقة. انخفض وقت التشغيل الوسيط 28.64%، من 98.57 ثانية إلى 70.34 ثانية، وانخفضت رموز المخرجات 16.58% بمعدلات إكمال مماثلة (arXiv:2601.20404). توقف الوكيل عن الاستكشاف لاكتشاف أشياء كنت تعرفها بالفعل.
هذه هي الحجة في جملة واحدة. السياق الثابت الجيد يجعل النموذج أسرع وأقل تكلفة، ليس فقط أكثر دقة، لأن معظم ما يحرق الوكيل رموزاً عليه هو إعادة اكتشاف اتفاقياتك. إذا كنت تختار من بين 260 مساعد برمجة بالذكاء الاصطناعي في دليلنا، فما إذا كانت الأداة تقرأ ملف تعليمات المشروع هو مرشح أفضل من معظم مقارنات الميزات.
ما الذي ينتمي فعلاً إلى ذلك الملف
أبقِه قصيراً بما يكفي لتقرأه أنت بنفسك. خمسة أشياء تستحق مكانها:
- الاتفاقيات التي لا يُعلن عنها الكود، كمشغّل الاختبار الحقيقي وأيهما خامل.
- مصطلحاتك. إذا كان «الحساب» و«المستأجر» يعنيان شيئين مختلفين هنا، قل ذلك مرة واحدة.
- شكل المخرجات الذي تريده، بالتنسيق الذي تريده (فرق، جدول، خمسة نقاط).
- قائمة قصيرة بالممنوعات. لا تلمس الملفات المُولَّدة، لا تُضف تبعيات بدون سؤال.
- أين يقع مصدر الحقيقة، حتى يستعلم النموذج منه بدلاً من التخمين.
اترك خارجه أي شيء يمكن للأداة قراءته بنفسها. أشجار الدليل، وقوائم الملفات، وتوقيعات الوظائف المُعادة صياغتها، وملخص README. تلك رموز تُنفق في تكرار شيء يستطيع الوكيل جلبه في طلب واحد، وتتنافس على الانتباه مع التعليمات التي تهم. أعِد كتابة الملف حين يبدأ في التجاهل، وهذا عادةً يعني أنه أصبح طويلاً جداً.
الانتفاخ السياقي له ثمن
السياق المتهاون يُكلّف مالاً في الفاتورة، ليس فقط جودةً في المخرجات. آليتان في التسعير تُجسّدان ذلك، وكلتاهما تُكافئان نفس الانضباط: بادئة صغيرة ومستقرة ومرتبة.
القفزة السعرية عند 272K في GPT-5.4
GPT-5.4 من OpenAI يقبل نافذة سياق بـ1,050,000 رمز وحتى 128,000 رمز مخرجات، لكن الطلبات التي تتجاوز 272K رمز مدخل تُسعَّر بـ"2x مدخل و1.5x مخرج للجلسة بأكملها" (OpenAI API docs). اقرأ ذلك بعناية. عبور الخط مرة واحدة لا يُكلّفك قليلاً إضافياً على ما يتجاوزه. بل يُعيد تسعير الجلسة بأكملها، المخرجات مشمولة، لذا لصق واحد متهور لـ300K رمز يُضاعف فاتورة المدخلات في كل دور يلي.
أنت تدفع ضعفاً مقابل الرموز الأكثر احتمالاً لتدهور إجابتك.
التخزين المؤقت يُكافئ البادئة الثابتة
تُسعّر واجهة Claude API قراءات التخزين المؤقت بـ0.1x من المدخلات الأساسية، خصم 90%، بينما تُكلّف الكتابات 1.25x على مدة صلاحية 5 دقائق أو 2x على مدة صلاحية ساعة (Claude Platform docs). مثالهم العملي: 100k رمز مُعاد استخدامه عشر مرات يُكلّف 1.075 دولار مقابل 5.00 دولار بدون تخزين مؤقت، توفير 78.5%.
هذا الخصم لا يتحقق إلا إذا تطابقت البادئة بايتاً ببايت. التخزين المؤقت يعتمد على بادئة مطابقة تماماً، لذا إذا أعدت ترتيب مستنداتك، أو أدرجت طابع زمني في طلب النظام، أو خلطت تعريفات الأدوات بين الأدوار، ستدفع سعر الكتابة مرة أخرى بدلاً من سعر القراءة. العادة التي تُبقي ذاكرة التخزين المؤقت دافئة هي نفسها التي تُبقي الاستدعاء عالياً: ضع المادة الثابتة أولاً بترتيب ثابت، واجعل الاستفسار فقط هو ما يتغير في النهاية.
تدقيق السياق يمكنك إجراؤه هذا الأسبوع
لا شيء هنا يحتاج مفتاح API أو تذكرة هندسية. كل بند هو إعداد تمتلكه بالفعل.
ست نقاط تحقق قبل جلستك الطويلة التالية
- افتح محادثة جديدة بدلاً من تمديد محادثة الأمس. الطلبات المُركّزة لـChroma (~300 رمز من الأدوار ذات الصلة) تتفوق على تواريخ 113k رمز الكاملة عبر كل عائلات النماذج التي اختبرتها، مع أوسع فجوة لنماذج Claude (Chroma).
- اقرأ ذكرياتك المحفوظة واحذف القديمة منها. الحقائق المحفوظة تُدرَج سواء ساعدت أم لا.
- أرفق ثلاثة مستندات جيدة بدلاً من اثني عشر متوسطاً، ولفّ كلاً منها في وسوم
<document>مع وسم فرعي<source>حتى يميّز بينها النموذج (Claude docs). - ضع المحتوى الطويل فوق سؤالك. في المدخلات التي تتجاوز 20k رمز، هذا الترتيب يستحق ما يصل إلى 30% استجابات أفضل في اختبارات Anthropic (Claude docs).
- اكتب التعليمات الثابتة مرة واحدة. ملف AGENTS.md على مستوى المستودع خفّض وقت التشغيل الوسيط 28.64% ورموز المخرجات 16.58% عبر 124 طلب سحب (arXiv).
- أبقِ تلك البادئة مطابقة من دور إلى آخر. البادئات الثابتة تضرب التخزين المؤقت بـ0.1x من سعر المدخلات (Claude docs).
العادة الواحدة التي تُصلح معظم المخرجات السيئة
قبل إعادة صياغة الطلب، انظر إلى ما هو بالفعل في النافذة وأزِل شيئاً منه. وثائق Anthropic نفسها تقول ذلك: "السياق الأكثر ليس أفضل تلقائياً" (Claude docs). غيّر ما تُغذّي به النموذج قبل أن تُغيّر طريقة سؤالك.
أسئلة متكررة
ما هي هندسة السياق وكيف تختلف عن هندسة الطلبات؟
تُعرّف Anthropic هندسة السياق بأنها "مجموعة الاستراتيجيات لتنسيق وصون المجموعة المثلى من الرموز (المعلومات) أثناء استدلال نموذج اللغة، بما في ذلك كل المعلومات الأخرى التي قد تصل خارج نطاق الطلبات" (Anthropic Engineering). هندسة الطلبات تسأل كيف تصيغ طلباً. هندسة السياق تسأل أيُّ تكوين من السياق هو الأكثر احتمالاً لإنتاج السلوك الذي تريده، وتشمل كل ما يشغل النافذة: طلب النظام، وكل رسالة بما في ذلك نتائج الأدوات والصور وملفات PDF، وتعريفات الأدوات ذاتها، ومخرجات النموذج بما في ذلك التفكير الموسَّع (Claude Platform docs). Anthropic تُقدّمها كتطور طبيعي لهندسة الطلبات لا كبديل عنها.
هل تعني نافذة السياق الأكبر دائماً مخرجات ذكاء اصطناعي أفضل؟
لا. السياق المُعلَن والسياق القابل للاستخدام رقمان مختلفان: اختبر اختبار NoLiMa 13 نموذجاً يدّعي جميعها دعم 128K أو أكثر، وعند 32K رمز سقط 11 من أصل 13 دون نصف خط الأساس في سياقها القصير، مع انخفاض Llama 3.1 70B من 94.3% إلى 42.7% (arXiv:2502.05167، فبراير 2025). وثائق منصة Anthropic نفسها تقول بوضوح: "السياق الأكثر ليس أفضل تلقائياً. مع نمو عدد الرموز، تتدهور الدقة والاستدعاء" (Claude Platform docs). ملء النافذة يُكلّف أيضاً مالاً بخطوات لا بخط مستقيم، إذ تُفوتر OpenAI طلبات GPT-5.4 التي تتجاوز 272K رمز مدخل بـ2x مدخل و1.5x مخرج للجلسة بأكملها (OpenAI API docs).
ما هو تعفن السياق وكيف أتجنبه؟
تعفن السياق هو تدهور الدقة والاستدعاء مع نمو عدد الرموز في الطلب، وتُسمّيه Anthropic في وثائقها الخاصة (Claude Platform docs). اختبرت دراسة Chroma لتعفن السياق 18 نموذجاً بما في ذلك GPT-4.1 وClaude 4 وGemini 2.5 وQwen3، ووجدت انخفاض الموثوقية مع المدخلات الأطول حتى في مهام الاسترجاع وتكرار الكلمات التافهة؛ في اختبار LongMemEval، حققت كل عائلة نماذج نتائج أفضل على طلب مُركّز بـ~300 رمز مقارنةً بالسؤال ذاته المدفون في ~113k رمز من تاريخ المحادثة، مع أوسع فجوة لنماذج Claude (Chroma، يوليو 2025). تجنبه بلصق المقاطع التي تهم فقط، وبدء محادثات جديدة للمواضيع الجديدة بدلاً من تمديد القديمة، وجعل الوكلاء المتخصصين يُعيدون ملخصات مكثّفة من 1,000 إلى 2,000 رمز إلى وكيل منسّق بدلاً من السجلات الكاملة (Anthropic Engineering).
هل يجب تعطيل ذاكرة ChatGPT أو Claude أو Gemini؟
يعتمد على المهمة، لأن الذاكرة تُدرج رموزاً لم تختَرها في نافذة حيث كل شيء يُحسَب على الإجمالي (Claude Platform docs). للصياغة الاعتيادية حيث يوفّر علم النموذج بدورك وأسلوبك ومكدّسك إعادة كتابتها، اتركها مشغّلة. للتحليل عالي الدقة لمستند محدد، ابدأ محادثة نظيفة مع تعطيل الذاكرة، إذ وجدت Chroma أن كل عائلة نماذج أجابت بشكل أفضل من طلب مُركّز بـ~300 رمز مقارنةً بالإجابة ذاتها محاطة بـ~113k رمز من التاريخ غير ذي الصلة (Chroma). تعامل مع الذاكرة كطلب نظام ثابت تدفع مقابله في كل دور، وقلّمها كما تُقلّم طلب النظام.
هل أحتاج RAG، أم يمكنني لصق مستنداتي في الطلب مباشرةً؟
توجيهات Anthropic تقول إن الاسترجاع غير ضروري في الغالب على النطاق الصغير: "إذا كانت قاعدة معرفتك أصغر من 200,000 رمز (حوالي 500 صفحة من المواد)، يمكنك تضمين قاعدة المعرفة بأكملها في الطلب" (Anthropic Engineering، سبتمبر 2024). فوق ذلك، يتراكم انضباط الاسترجاع في اختبار Anthropic: إلحاق السياق الخاص بالقطعة قبل التضمين خفّض إخفاقات الاسترجاع الأعلى-20 من 5.7% إلى 3.7%، وإضافة بحث هجين BM25 سياقي أوصلها إلى 2.9%، ومرحلة إعادة الترتيب أوصلتها إلى 1.9%، أي خفض 67% إجمالاً. إذا كان المحتوى يناسب، فاللصق هو الإعداد الافتراضي الأفضل، والتخزين المؤقت للطلبات يجعل إعادة الاستخدام رخيصة بقراءات مُخزَّنة بسعر 0.1x من المدخلات الأساسية (Claude Platform docs).
أين أضع المستندات الطويلة في الطلب — قبل سؤالي أم بعده؟
بالنسبة لـClaude، ضع البيانات المطوّلة في الأعلى، فوق استفسارك وتعليماتك وأمثلتك. وثائق طلبات Anthropic تُعطي هذا كقاعدة ملموسة للمدخلات التي تبلغ 20k رمز أو أكثر وتقول "الاستفسارات في النهاية يمكن أن تُحسّن جودة الاستجابة بنسبة تصل إلى 30 بالمئة في الاختبارات، خاصةً مع المدخلات المعقدة متعددة المستندات" (Claude Platform docs). تُوصي الوثائق ذاتها بلف كل مستند في وسوم <document> مع وسوم فرعية <source> و<document_content>، وطلب اقتباس المقاطع ذات الصلة قبل الإجابة من النموذج. الموردون لا يتفقون على الترتيب، لذا قد يُؤدي قالب مأخوذ من كتاب طبخات أحد الموردين بشكل أدنى على نموذج مورد آخر، والأمر يستحق تشغيل كلا الترتيبين مرة واحدة على مهمتك الخاصة.