

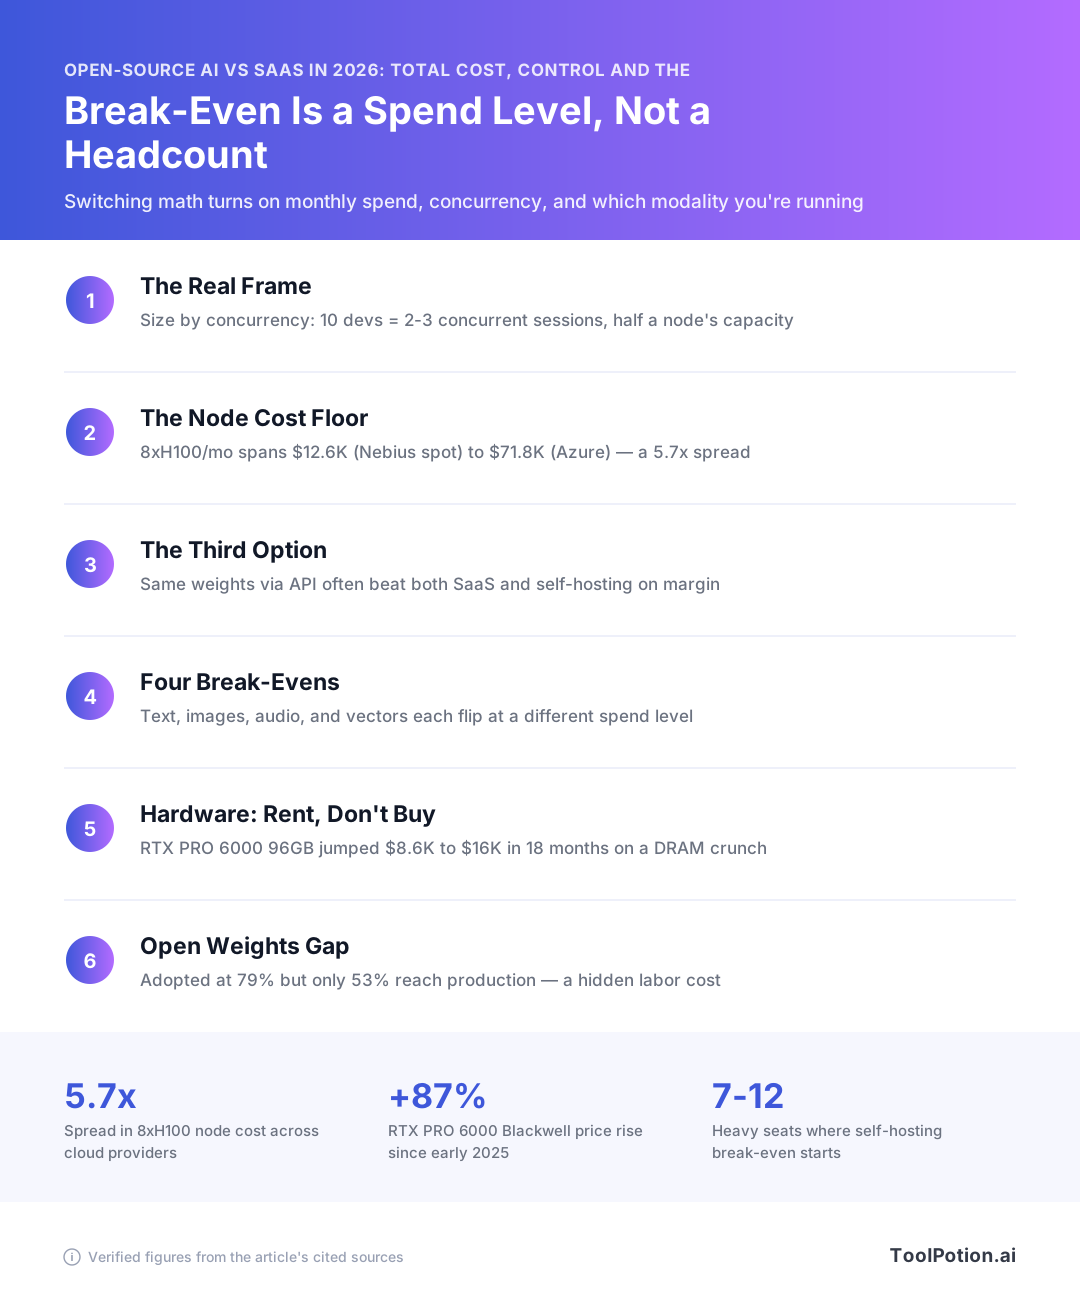
يتوقف قرار الذكاء الاصطناعي مفتوح المصدر مقابل SaaS على رقمين: إنفاقك الشهري وملف التزامن لديك. عدد الموظفين مؤشر ضعيف لكليهما. يبلغ متوسط مهندسي DoiT الخاصين $2,200 لكل مطور شهرياً على Claude Code المعتمد على الاستخدام، مما يضع عقدة بقيمة $15K–$25K في المعادلة عند نحو 7 إلى 12 مقعداً كثيف الاستخدام. لكن 10–20% فقط من الفريق يكون لديه طلب قيد التنفيذ في وقت واحد، فعشرة مطورين يعادلون جلستين أو ثلاث متزامنة ونصف عقدة جالس خاملاً.
وقبل أن تسعّر أجهزة GPU أصلاً، تحقق من الخيار الثالث الذي لا يُقارن به أحد: تخدم DeepInfra نموذج Llama-3.3-70B بـ$0.10 إدخالاً / $0.32 إخراجاً لكل مليون رمز. الأوزان ذاتها، وهوامش تعدد المستأجرين التي لا تستطيع مضاهاتها. الحسابات أدناه تُجرى أربع مرات: للنص والصور والنسخ والطبقة المتجهية.
نقطة التعادل هي مستوى إنفاق وملف تزامن
رقمان يحددان ما إذا كان يجب عليك الاستضافة الذاتية، وحجم الفريق ليس أياً منهما. الأول هو ما تنفقه شهرياً على الذكاء الاصطناعي الآن. والثاني هو عدد الطلبات المتزامنة في اللحظة ذاتها. كل شيء آخر، بما في ذلك اختيار النموذج، يأتي بعد ذلك.
الرقمان اللذان يحسمان الأمر قبل أي اختيار للنموذج
تكلف عقدة GPU واحدة بالمبلغ ذاته سواء شغّلتها بكامل طاقتها أو تركتها خاملة في الثالثة صباحاً. هذا هو اللاتماثل الذي تقوم عليه المقارنة بأكملها: SaaS تفوترك لكل رمز، أما العقدة فتفوترك لكل ساعة. إذن السؤال هو ما إذا كانت فاتورتك الشهرية قد تجاوزت التكلفة الثابتة لجهاز يمكنك إبقاؤه مشغولاً.
يبلغ متوسط فريق هندسة DoiT نحو $2,200 لكل مطور شهرياً على أسعار Claude Code Enterprise المعتمدة على الاستخدام، مما يضع نقطة تعادل الاستضافة الذاتية عند $15K–$25K/شهر عند نحو 7 إلى 12 مقعداً كثيف الاستخدام. هذا عتبة أخفض بكثير من عبارة "تحتاج لمئات المهندسين" التي تكررها معظم أدلة TCO. إنها عتبة إنفاق لا عتبة أشخاص. اثنا عشر مطوراً يستخدمون المساعد بالكاد لن يوصلوك إليها، بينما سبعة يشغّلون وكلاء طوال اليوم سيفعلون.
التزامن هو الرقم الثاني، وهو الذي تُخطئ فيه الفرق. حجة DoiT هي أنه في أي لحظة 10–20% فقط من فريق المطورين لديه طلب قيد التنفيذ، لذا عشرة مطورين يمثلون جلستين أو ثلاث متزامنة، أي نصف طاقة عقدة في أحسن الأحوال. أنت تدفع مقابل ثمانية H100 وتستخدم ثلاثة أو أربعة. حدّد الحجم بناءً على ذروة الطلبات المتزامنة ومعدل نقل الرموز المستهدف، ثم تحقق مما إذا كان ذلك يناسب عقدة واحدة قبل أن تسعّر أي شيء.
لماذا 'لدينا 50 مهندساً' هو المحفز الخاطئ
عدد الموظفين لا يرتبط بالإنفاق إلا عندما يكون الاستخدام الفردي متماثلاً، وهذا لا يحدث أبداً. فريق من 50 شخصاً يشغّل فيه 8 أشخاص وكلاء الترميز باستمرار و42 يستخدمون الدردشة أحياناً لديه متطلبات عقدة مماثلة لفريق من 8 مستخدمين كثيفين، وفاتورة متقاربة. عدّ المقاعد الكثيفة الاستخدام.
أجرِ هذين الحسابين قبل أن تقارن النماذج ذات الأوزان المفتوحة المُدرجة في دليلنا بأي شيء. اختر النموذج بعد أن تعرف ما إذا كانت العقدة يمكن أن تبقى مشغولة، لأن نموذجاً أقل بـ6 نقاط من الحدود الأمامية يمثل صفقة جيدة على جهاز مُشبَع وخطأً مكلفاً على جهاز يعمل بربع حمولته.
الذكاء الاصطناعي مفتوح المصدر مقابل SaaS: تكلفة الاستضافة الذاتية في 2026
ابدأ بجدول الأسعار، لأنه الرقم الوحيد الذي يمكنك البحث عنه. كل شيء آخر في ميزانية الاستضافة الذاتية هو تقدير تدافع عنه في جدول بيانات.
جداول أسعار تأجير GPU: فارق ~7x على السيليكون القادر على الاستدلال
تُدرج RunPod في أسعارها العامة H100 SXM 80GB بـ$3.29/ساعة على السحابة الآمنة و$2.69/ساعة على سحابة المجتمع، وH200 141GB بـ$4.59/$3.59، وA100 PCIe 80GB بـ$1.39/$1.19، وL40S 48GB بـ$0.99/$0.79، وB200 180GB بـ$6.79/$5.98 (RunPod). هذا فارق 7x تقريباً بين أرخص وأغلى بطاقة يمكنها خدمة الاستدلال. إذا كان حجم عملك نموذجاً بـ7B أو 8B مع سياق متواضع، فإن سطر L40S هو ما يجب أن تسعّر بناءً عليه، ومعظم منشورات TCO لا تذكره أبداً.
تفرض Lambda $4.29/ساعة لـH100 SXM واحد عند الطلب، تنخفض إلى $3.99/ساعة للـGPU على عقدة 8x، مع H100 PCIe بـ$3.29/ساعة وB200 SXM6 بـ$6.69–$6.99/ساعة (Lambda). عقدة 8xH100 بهذا المعدل تبلغ نحو $31.92/ساعة، أي حوالي $23,300 لشهر 730 ساعة بنسبة تشغيل 100%. لا أحد يعمل بنسبة 100%، وهذا هو مغزى الرقم التالي.
خصم الالتزام هو أكبر رافعة فردية تتحكم فيها. تفرض Together AI $3.99/GPU-ساعة عند الطلب لـHGX H100 و$3.19–$3.69/GPU-ساعة بشروط احتياطية من 7 إلى 180+ يوماً (Together AI). قل 20% خصماً، متاح فقط إذا كنت واثقاً بما يكفي من حمولتك للتوقيع على المدة.
ضاعف المزوّد: من $12,600 إلى $71,800 لنفس شهر 8xH100
قيّمت DoiT عقدة 8xH100 متطابقة لشهر 730 ساعة عبر مزودين مختلفين: حوالي $12,600 على Nebius spot، و$22,500 على Nebius عند الطلب، و$40,200 على AWS، و$64,100 على GCP و$71,800 على Azure (DoiT). نفس السيليكون، فارق 5.7x. اختيارك للمزوّد يحرّك حسابات التحول أكثر من اختيارك للنموذج، لذا إذا كنت تجري هذا التقييم على أسعار المزودين الكبار لأن رصيدك الملتزم هناك، فأنت تقارن أسوأ نسخة من الاستضافة الذاتية بـSaaS.
| المزوّد / البطاقة | المعدل بالساعة | ملاحظات |
|---|---|---|
| RunPod L40S 48GB | $0.99 / $0.79 | السحابة الآمنة مقابل سحابة المجتمع |
| RunPod H100 SXM 80GB | $3.29 / $2.69 | السحابة الآمنة مقابل سحابة المجتمع |
| Lambda H100 SXM (عقدة 8x) | $3.99 لكل GPU | ~$23,300 / شهر 730 ساعة |
| Together AI HGX H100 | $3.99 عند الطلب، $3.19–$3.69 احتياطي | مدد 7–180+ يوم |
البنود التي لا يُسعّرها أحد: ساعات الخمول والتكرار وعمالة الصيانة
تُفوتر العقدة المستأجرة بالساعة الجدارية. فاتورة الـAPI تتتبع الرموز، أما فاتورة الـGPU فتتتبع ساعات قد لا تستخدمها أبداً. إذا كانت حركة مرورك خلال ساعات العمل وأيام الأسبوع، فأنت تدفع مقابل 168 ساعة تقريباً من الطاقة المفيدة من أصل 730، وتتحمل الباقي، لذا اضرب تكلفة الرمز الفعلية لديك في أربعة قبل مقارنتها بفاتورة API. أضف عقدة ثانية أو مفتاح API احتياطياً إذا كانت الخدمة تواجه العملاء، لأن العقدة الواحدة لا تمتلك آلية تعافٍ. أضف المهندس الذي يرقّع vLLM ويدير إصدارات النماذج ويراقب ضغط KV cache ويُستدعى في الثانية صباحاً. المزودون في دليل منصات التعلم الآلي لدينا سيديرون بعضاً من ذلك بمقابل هامش، وهو عادةً أرخص من نصف الرأسمال البشري الذي ستنفقه.
إذن الرقم الشهري المعقول هو: ساعات العقدة بمعدل مزوّدك الحقيقي، مقسومةً على وقت تشغيلك الحقيقي، مضافاً إليه التكرار، مضافاً إليه وقت الهندسة المُحمَّل. أجرِ الحسابات الأربعة قبل أن تقارن أي شيء.
الخيار الثالث الذي يُفسد معظم حالات الاستضافة الذاتية
تضع تقريباً كل مقالة تقارن المصدر المفتوح بـSaaS فاتورة GPU مقابل فاتورة API حدودية وتُعلن الفائز. هذه المقارنة تتجاهل الخيار الذي يجب أن تختاره معظم الفرق: شخص آخر يشغّل الأوزان المفتوحة عنك بتعدد مستأجرين ويفوترك لكل رمز.
تخدم DeepInfra نموذج Llama-3.3-70B-Instruct-Turbo بـ$0.10 إدخالاً / $0.32 إخراجاً لكل مليون رمز، وMeta-Llama-3.1-8B بـ$0.02/$0.04 (DeepInfra). نفس نقاط التفتيش التي ستنزّلها. نفس شروط الترخيص. الفارق هو أن أجهزة H100 لديهم تعمل بالقرب من الطاقة القصوى عبر آلاف العملاء، وأجهزتك تعمل بأي حركة مرور تكون لديك في الثالثة صباحاً يوم الأحد.
أوزان مفتوحة متطابقة، منحنى إشغال شخص آخر
أجرِ الحسابات مقابل مستوى DeepInfra المخصص وسيصبح الفارق محرجاً. H100 80GB المخصص يكلف $2.20/ساعة هناك (DeepInfra)، أي $1,606 لشهر 730 ساعة. بـ$0.32 لكل مليون رمز إخراج، نفس $1,606 يشتري نحو خمسة مليارات رمز إخراج على نقطة النهاية بلا خادم. موزعاً على 43,800 دقيقة في ذلك الشهر، يجب أن يحافظ H100 الواحد لديك على نحو 115,000 رمز إخراج في الدقيقة، كل دقيقة، فقط لمجاراة الـAPI في السعر. النشر الحقيقي يقضي حصة كبيرة من تلك الدقائق خاملاً.
أنت تشتري طاقة مخصصة لأسباب غير سعر الوحدة: إقامة البيانات، وعدم الاحتفاظ الخارجي، وحدود كمون تتحكم فيها، وLoRAs مخصصة، ونماذج لا يستضيفها أحد. هذه حقيقية. إنها أسباب شراء وليست أسباباً لجدول البيانات، وعليك أن تقولها بصوت عالٍ عندما تطرحها.
متى يتوقف تأجير الأوزان عن كونه أرخص
انهار الطرف الصغير من السوق على نفسه. يعمل GPT-5-nano بـ$0.05/$0.40 لكل مليون رمز ويعمل GPT-5 بـ$1.25/$10.00 (OpenAI)، مما يعني أن نموذجاً تجارياً الآن أقل تكلفة مما ستدفعه لإبقاء نموذج مفتوح بـ8B دافئاً على عتادك الخاص. واجهات برمجة الأوزان المفتوحة الرخيصة والواجهات التجارية الرخيصة تتنافس على نفس المحور، والاستضافة الذاتية تخسر أمام الاثنين.
اختر معيار المقارنة بعناية، لأنه يحدد الإجابة. يمتد نطاق Anthropic من $10/$50 لكل مليون لـFable 5.1 إلى $1/$5 لـHaiku 4.5 (Anthropic). قارن الاستضافة الذاتية بأعلى هذا النطاق وستبدو صفقة. قارنها بـHaiku، أو بـLlama من DeepInfra، وعلى عقدة GPU أن تُبرر نفسها بالتحكم لا بالتكلفة.
أربعة أنماط، أربع نقاط تعادل مختلفة تماماً
الفريق الذي يستضيف النسخ ذاتياً نادراً ما يستضيف استدلال النص ذاتياً، والسبب حسابي. لكل حمل عمل حدّه الأدنى الخاص من SaaS ونمط حمل GPU الخاص به وقواعد ترخيص خاصة. أجرِ نموذج تعادل واحداً عبر الأربعة وستحصل على إجابة خاطئة ثلاث مرات.
استدلال النص: أوسع نقطة تحوّل وأقلها قابلية للتنبؤ
هذا هو النمط الذي تتحرك فيه نقطة التحوّل أكثر، لأن سعر API الذي تقارن به يمتد لأمر قدره. تفرض Anthropic $2/$10 لكل مليون رمز إدخال/إخراج لـSonnet 5 و$1/$5 لـHaiku 4.5 (Claude pricing)، بينما تدرج OpenAI GPT-5-mini بـ$0.25/$2.00 وGPT-5-nano بـ$0.05/$0.40 (OpenAI API pricing). اختر مستوى المعيار ونقطة التعادل ستتراوح بين بضع مئات من ملايين الرموز شهرياً وعدة مليارات.
H100 مخصص بـ$2.20/ساعة على DeepInfra يكلف نحو $1,606 شهرياً بتشغيل كامل الوقت (DeepInfra pricing). مقابل معدل GPT-5-nano المدمج، ستحتاج إلى حجم لا تصله معظم الفرق. أما مقابل Fable 5.1 بـ$10/$50 لكل مليون (Claude pricing)، فالعقدة ذاتها تسترد تكلفتها أسرع بكثير. حدّد مستوى النموذج الذي يحتاجه حمل عملك قبل أن تنمذج أي شيء، وتصفح قوائم النماذج وـLLMs إذا كنت لا تزال تضيّق خياراتك من الأوزان المفتوحة.
توليد الصور: الترخيص يحسمه قبل أن يفعل GPU
هنا حسابات GPU هي الجزء السهل والترخيص هو الفخ. وُصفت أوزان FLUX.1 [dev] على نطاق واسع بأنها تأتي بترخيص غير تجاري، مما سيضع ترخيص Black Forest Labs المدفوع بينك وبين منتج تجاري، لذا اقرأ الشروط بنفسك قبل أن تضع ميزانية للعتاد. لا أحد يقارن نماذج الصور المفتوحة بـMidjourney يذكر ذلك، وهو البند الذي يمكنه قلب القرار.
العمل المتقطع على الصور هو ما يرسب في الاختبار. فريق تسويق يولّد الصور بدفعات أيام الثلاثاء يترك البطاقة خاملة بقية الأسبوع، وساعات الخمول تُفوتر بنفس معدل الساعات النشطة. L40S بـ$0.79/ساعة على RunPod Community Cloud (RunPod pricing) رخيصة بما يكفي لتجعل وظائف الدفعات المنتظمة تتجاوز العتبة بسهولة، ولهذا فإن خطوط الأنابيب المجدولة هي الشكل الناجح هنا. يضم دليلنا 727 أداة لتوليد الصور، وشروط الترخيص تتفاوت أكثر من جودة الإخراج.
النسخ: النمط الذي يتحوّل أسرع
إلا أنه عادةً لا يفعل، والسبب هو AssemblyAI. تفرض OpenAI $0.006/دقيقة لـWhisper وgpt-4o-transcribe، و$0.003/دقيقة لـgpt-4o-mini-transcribe، أي $0.36 و$0.18 لكل ساعة صوتية (OpenAI API pricing). مقابل $0.36/ساعة، يصل L40S بـ$0.79/ساعة إلى نقطة التعادل عند بضع مئات من ساعات الصوت شهرياً، بافتراض معدل نقل دفعات أسرع من الوقت الحقيقي. هذه عتبة منخفضة فعلاً. ثم تسعّر AssemblyAI Universal-2 بـ$0.15/ساعة وUniversal-3.5 Pro بـ$0.21/ساعة (AssemblyAI pricing)، ونقطة تعادلك ترتفع بأكثر من 2x.
المكان الوحيد الذي تنتصر فيه الاستضافة الذاتية بوضوح هو البث المباشر. تُفوتر AssemblyAI البث لكل مدة جلسة WebSocket، بما في ذلك وقت الاتصال الخامل (AssemblyAI pricing). إذا أبقيت مآخذ مفتوحة لاجتماعات لا يتحدث فيها الناس، فأنت تدفع مقابل الصمت. نقطة النهاية المستضافة ذاتياً تفوترك لثواني GPU لا للوقت الجداري.
RAG وطبقة المتجهات تعتمد على حجم الاستعلامات
يُقاس تعادل البحث المتجهي بعدد الاستعلامات شهرياً، والرقم المتداول يقع في مكان ما بين 60 و80 مليون استعلام قبل أن تتفوق الاستضافة الذاتية على الأسعار المُدارة. عامله كقاعدة عامة لا كجدول أسعار، إذ يتحرك مع حجم الفهرس وعدد النسخ ومقدار ميزانية الكمون التي أنت مستعد لإنفاقها. دون ذلك النطاق، أنت تدفع لمهندس لمراقبة فهرس تديره خدمة مُدارة بأقل من راتبه. توليد التضمينات هو حساب منفصل مجدداً، وهو أرخص شيء يمكن استضافته ذاتياً من بين كل ما نوقش هنا لأن النموذج صغير والعمل يتجمّع بشكل مثالي.
أربعة أحمال عمل، أربعة عتبات، ولا سبب لتحريكها جميعاً دفعة واحدة.
شراء العتاد؟ أزمة الذاكرة في 2026 تقول: استأجر
أي حساب لفترة الاسترداد قرأته وكُتب قبل منتصف 2026 يعمل على أسعار لم تعد موجودة. كان المشورة معقولة في ذلك الوقت: اشترِ جهازاً، استهلكه على مدى ثلاث سنوات، تجاوز معدل التأجير بحلول الشهر 14. ثم انهار سوق الذاكرة.
ارتفاع ~87% على GPU لم يتغير
NVIDIA RTX PRO 6000 Blackwell 96GB هو المثال الأوضح لأن المنتج لم يتغير. كان مدرجاً بـ$8,565 لدى أحد تجار التجزئة في مطلع 2025 (مع أدنى سعر طلب مسبق $7,673)، وصل إلى $13,250 في يونيو 2026، وبلغ $16,000 بحلول أغسطس 2026 (igor'sLAB). هذا ارتفاع بنحو 87% في 18 شهراً تقريباً، ولم تنشر NVIDIA أي توضيح رسمي.
أجرِ ذلك عبر جدول بيانات 2025 ويتضاعف شهر الاسترداد تقريباً. جهاز عمل ببطاقة واحدة قدّرت تكليفه بـ$12,000 شاملاً بات الآن أقرب إلى $20,000 قبل شراء الذاكرة العشوائية.
لماذا ابتلعت HBM إمدادات DRAM
الطلب على GPU ليس سوى نصف القصة. المهم هو ما فعله هذا الطلب بمصانع الذاكرة: تأخذ ذاكرة النطاق الترددي العالي الآن ما يُقدَّر بـ23% من طاقة رقاقات DRAM العالمية، مقارنةً بـ8% في 2024، لأن HBM تُدرّ 3–5 أضعاف الإيرادات لكل رقاقة مقارنةً بـDDR5 التقليدي (DatacenterDisk). نقلت المصانع الرقاقات حيث توجد الأرباح. ارتفعت أسعار Server DDR5 ECC RDIMM بنحو 100% إلى 116% بين الربع الأول من 2025 والربع الأول من 2026 نتيجة لذلك، فذاكرة المضيف حول وحدات GPU تأثرت بقدر المسرّعات. تشعر بذلك مرتين في عملية البناء الواحدة: البطاقة، وتيرابايت ذاكرة النظام العشوائية تحتها.
ما يجب أن يفترضه جدول الاستهلاك المكتوب في 2026
افترض أن التشويه يستمر أطول من قرار شرائك. توقعت Goldman Sachs في مايو 2026 عجزاً عالمياً في DRAM بنسبة 4.9% للعام، أوسع نقص في 15 سنة، إضافةً إلى فجوة إمدادات HBM بنسبة 5.1%، ومعظم المحللين لا يتوقعون تعافياً ملموساً قبل أواخر 2027 (Wccftech). جدول استهلاك لمدة ثلاث سنوات يبدأ اليوم يقضي سنتيه الأوليين داخل فترة النقص.
لذا سعّر حالة الشراء بتكاليف الاقتناء لأغسطس 2026 لا بأرقام 2025 الموجودة في صفحات التصنيف، ولا تفترض تحديثاً أرخص في السنة الثانية. إذا كانت الأرقام تنجح فقط بأسعار عتاد 2025، فاستأجر. الإيجار هو طريقتك للحفاظ على خيار الشراء في 2028 بدلاً من ذلك.
التحكم والامتثال: الجزء الذي يُفوّته جدول البيانات
بعض الضمانات لا يمكنك الحصول عليها إلا بتشغيل الأوزان بنفسك. معظم ما تذكره الفرق كسبب للاستضافة الذاتية يمكنك شراؤه الآن.
ما تشتريه الاستضافة الذاتية فعلاً، وما تبدو فقط أنها تشتريه
تشغيل استدلالك الخاص يمنحك أربعة أشياء لا يكررها أي بند عقدي: أوزان نماذج لا تتغير عليك وفق جدول إهمال المورّد، ولا بيانات لكل طلب تغادر VPC الخاص بك، ولا حدود معدل يفرضها تخطيط طاقة شخص آخر، وقدرة على الضبط الدقيق أو التكميم دون استئذان. إذا كان سجل المخاطر لديك يتضمن سطراً عن إيقاف إصدار نموذج في منتصف مراجعة، فهذه حجة حقيقية لامتلاك القطعة الأثرية.
قائمة ما تبدو الاستضافة الذاتية أنها تشتريه أطول. إقامة البيانات، والتشفير في حالة الراحة، والتزامات عدم التدريب على بياناتك، وأدلة SOC 2، وسجلات المراجعة، والمعالجة الإقليمية: كل هذه قابلة للشراء كبنود عقدية مع محدد منطقة، وكان كذلك منذ فترة. دفع علاوة GPU عليها هو شراء مزدوج. المخاطرة التي تقود هذه المحادثات هي حسابيات العقوبات، وحسابيات العقوبات لا تهتم بمن يُركّب العتاد. أصدر المنظمون €7.1 مليار عبر 2,245 غرامة GDPR حتى مطلع 2026، مع تعرّض GDPR يصل إلى 4% من الإيرادات العالمية وتعرّض AI Act يصل إلى 7%. نموذج مستضاف ذاتياً مُهيَّأ بشكل خاطئ يفشل في مراجعة بالسرعة ذاتها مثل النموذج المُستضاف خارجياً.
إعادة ضبط تنظيمي 2026 غيّر المواعيد النهائية التي تخطط بناءً عليها
تحقق من تاريخ الجدول الزمني للامتثال الذي يعمل عليه فريقك. تأجّلت التزامات EU AI Act عالية المخاطر بسبب الأمنيبوس الرقمي 2026، لذا الموعد النهائي في 2 أغسطس 2026 الذي تطبعه صفحات المقارنة المستشهَد بها تجاوزه الزمن، وعليك تأكيد التواريخ الحالية مع مستشارك القانوني الخاص قبل الإنفاق بناءً عليها. إذا أقررت ميزانية استضافة ذاتية في مطلع 2026 لتجاوز ذلك الموعد، فالإلحاحية التي بُنيت عليها ذهبت والإنفاق يستحق إعادة نظر.
يهم ذلك أكثر في القطاعات المنظَّمة. الفرق التي تتسوق أدوات الذكاء الاصطناعي للرعاية الصحية وعلوم الحياة هي الأكثر احتمالاً لتسعير نشر خاص مقابل موعد نهائي تحرّك.
السحابة السيادية المُدارة هي المسار الوسط
ضعفت حجة الإقامة خلال 2026. أصبحت مناطق السحابة السيادية الموظَّفة والمُدارة داخل الاتحاد الأوروبي خياراً مُداراً لم يكن موجوداً عندما كُتبت معظم مقارنات المصدر المفتوح مقابل SaaS التي ستجدها، لذا تحقق مما يقدمه مزوّدك الكبير المفضل داخل المنطقة قبل أن تسعّر عقدة. يمكنك الحصول على معالجة بيانات داخل الاتحاد الأوروبي فقط دون توظيف أحد لمراقبة vLLM في الثانية صباحاً.
الترتيب الذي يصمد هو هذا. إذا كان متطلبك إقامةً، اشترِ سيادية مُدارة. إذا كانت ديمومة الأوزان أو الضبط الدقيق غير المقيّد، فاستضف ذاتياً. إذا كان سطراً في استبيان يقول "يجب ألا تغادر البيانات سيطرتنا"، اذهب واقرأ ما سيقبله مدقق الحسابات قبل أن توقّع على عقدة.
كم تتأخر الأوزان المفتوحة فعلاً؟
أربعة أشهر. هذا هو التأخر المقاس، وهو الرقم الذي يجب أن يحلّ محل ما تعتقده حالياً عن تأخر النماذج المفتوحة بجيل كامل.
أربعة أشهر وست نقاط فهرس
وضعت Epoch AI رقماً على ذلك بتتبع أفضل إصدار ذي أوزان مفتوحة مقابل الحدود المغلقة على Epoch Capabilities Index بين 1 يناير و28 مايو 2026: تأخر 4 أشهر، أو 8 نقاط ECI بفترة ثقة 90% من 7 إلى 11. يقيس Artificial Analysis الشيء ذاته بطريقة مختلفة ويصل إلى المكان ذاته. تسجّل النماذج المفتوحة الرائدة 52 إلى 54 على مؤشر الذكاء مقابل 60 لـGPT-5.5، فجوة 6 نقاط كانت 13 نقطة قبل اثني عشر شهراً.
إذن الفجوة حقيقية وهي تتقلّص. بالنسبة لمعظم أحمال العمل الإنتاجية (التصنيف والاستخراج والتلخيص والإجابات المعززة بالاسترجاع وكود المسودة الأولى) فإن الحدود التي مضى عليها أربعة أشهر كافية. أما لذيل الاستدلال الصعب، فليست كذلك، ولا يسدّ أي قدر من عمل الأوامر 8 نقاط ECI. اختر حمل عملك قبل أن تختار جانبك في الجدل. إصدارات الأوزان المفتوحة المتتبَّعة في دليلنا تتجدد بسرعة كافية لجعل النموذج الذي اختبرته في مارس ليس النموذج الذي ستنشره اليوم.
فجوة التبنّي إلى الإنتاج التي تكلّف الفرق مالاً حقيقياً
تخسر النماذج المفتوحة في الشحن لا في القدرة. وجد استطلاع 2026 لحالة المصدر المفتوح في الذكاء الاصطناعي (N=1,410) أن 79% من مطوري الذكاء الاصطناعي يتبنّون النماذج المفتوحة لكن 53% فقط يصلون بها إلى الإنتاج، مقابل 71% تبنّياً و63% وصولاً للإنتاج للنماذج المغلقة. يُجرَّب بها أكثر وتُشحَن أقل.
هذا الانخفاض بـ26 نقطة هو وقت هندسي تدفع مقابله ولا تسجّله في جدول TCO. ويزداد سوءاً مع الحجم لا أفضل: ترتفع معدلات إنتاج النماذج المغلقة من 54% في الشركات الصغيرة إلى 73% في الشركات الكبرى، بينما تبقى النماذج المفتوحة شبه ثابتة عند 53% إلى 57%. المؤسسات التي تمتلك أكثر مهندسي المنصات هي الأكثر تخلياً عن نشر المصدر المفتوح، وهو عكس ما يتنبأ به طرح الاستضافة الذاتية. ضع في الميزانية المحاولات التي لن تُشحن.
مسارات الهجرة: ما يستغرقه التحوّل فعلاً
التبديل نفسه رخيص. ما يكلّفك هو عمل التقييم الذي تجاوزته قبل التبديل، والذي تدفعه لاحقاً في حوادث الإنتاج.
مبادلة رابط الجذر، والاستثناءات الموثّقة التي تستحق التسمية
يأتي vLLM مزوداً بخادم متوافق مع OpenAI، لذا لإتمام دردشة عادية فإن الهجرة هي رابط جذر واسم مستعار للنموذج. وجّه عميلك الحالي إلى نقطة نهايتك، وغيّر model من gpt-5-mini إلى ما تخدمه، وابقِ بقية الكود كما هو. هذا هو الجزء الذي يعامله كل منافس كصندوق أسود وهو فعلاً النصف السهل.
الاستثناءات هي حيث تضيع الفرق أسبوعاً. تتصرف المخرجات المهيكلة وتطبيق مخطط JSON الصارم بشكل مختلف عبر مجموعات الخدمة، لذا أي شيء يعتمد على حجج وظيفة مضمونة الصحة يحتاج اختباراً على حمولات حقيقية لا اختباراً دخانياً. استدعاءات الأداة المتوازية هي فجوة شائعة. التخزين المؤقت للأوامر خاص بالمزوّد، وإذا افترض نموذج تكلفتك معدلات إدخال مخزّنة على جانب SaaS فهذا الخصم لن يرافقك. يتدهور سلوك السياق الطويل عند نقاط مختلفة عما يُعلن عنه، والمحوّلون يختلفون أيضاً، مما يعني أن ميزانياتك المستندة إلى عدد الرموز ومنطق الاقتطاع كلاهما يحتاجان إعادة معايرة.
ابنِ منظومة التقييم قبل التحوّل لا بعده
إذا كنت لا تستطيع قياس الجودة على حركة مرورك الحقيقية، لا يمكنك معرفة ما إذا كانت فجوة قدرة لمدة أربعة أشهر مهمة لحالة استخدامك أم لا. التقط بضع مئات من طلبات الإنتاج الحقيقية مع مخرجاتها، وصنّفها بأي طريقة يصنّف بها عملك، ثم شغّل النموذج المفتوح المرشح على نفس المجموعة. افعل هذا قبل توفير GPU.
- سجّل 200 إلى 500 طلب حقيقي مع ردودها وأي إشارة لاحقة تتتبعها بالفعل (إبهام للأعلى، تعديلات، إعادة محاولات، تصعيدات).
- صنّف إخراج SaaS الحالي لتأسيس خطك الأساسي. تحتاج الرقم الذي تدافع عنه لا انطباعاً.
- شغّل المرشح ذا الأوزان المفتوحة عبر API أولاً، إذ تخدم DeepInfra Llama-3.3-70B بـ$0.10 إدخالاً / $0.32 إخراجاً لكل مليون رمز (DeepInfra) ولا تكلّفك شيئاً في البنية التحتية للاختبار.
- فقط إذا حافظت الجودة وبرّر الحجم ذلك، انتقل إلى الطاقة المخصصة.
الإعداد الهجين الافتراضي: التوجيه بحسب فئة الطلب بدلاً من الاستبدال الكلي
قسّم حركة المرور بناءً على قيمة كل طلب. التصنيف والاستخراج والتلخيص وإعادة صياغة الاسترجاع تعمل بشكل جيد على نموذج 8B بـ$0.02/$0.04 لكل مليون رمز (DeepInfra)، وذيل الاستدلال الصعب يذهب إلى Sonnet 5 بـ$2/$10 (Anthropic). إذا كان 80% من استدعاءاتك في الفئة الرخيصة، فقد خفّضت معظم الفاتورة دون المراهنة بالجودة على نموذج واحد.
يمنحك التوجيه أيضاً مساراً احتيواطياً، وهو ما لا يمنحه الاستبدال الكلي. تشكّل أكوام الخدمة والموجّهات حصة جيدة من 128 إطار عمل AI في دليلنا، ومستودعات الذكاء الاصطناعي مفتوح المصدر التي تستحق البدء بها هي تلك التي لها سطح متوافق مع OpenAI، لأن ذلك هو ما يُبقي التراجع مجرد تغيير تهيئة واحدة.
من يجب أن يتحوّل في 2026 — ومن لا يجب
ثلاثة ملفات تصبّ الرياضيات في صالحها. وثلاثة لا تصبّ، ولا يصلح أي قدر من الحماس من فريق منصتك ما في ذلك.
ثلاثة ملفات تنتصر فيها الاستضافة الذاتية بوضوح
نسخ عالي الحجم بحمل ثابت. إذا كنت تضخ أكثر من بضعة آلاف ساعة صوتية شهرياً عبر خط أنابيب يعمل وفق جدول، يمكنك إبقاء بطاقة مشغولة والتفوق على حد $0.15/ساعة من AssemblyAI (AssemblyAI). العمل الدفعي هو الشكل المثالي هنا لأنك تتحكم في وقت استنزاف قائمة الانتظار، فإبقاء البطاقة مُغذّاة يصبح مشكلة جدولة لا أمنية.
بيانات منظَّمة لا يمكنها مغادرة حدودك، حيث المتطلب تعاقدي لا تفضيلي. تحسين التكلفة ليس الهدف في تلك الحالة. أنت تشتري إجابة تدقيق، وفاتورة GPU هي ثمنها.
خمسون مطوراً فأكثر على مساعدات الترميز المعتمدة على الاستخدام. عند نحو 50 مطوراً تبلغ الفاتورة قرابة $110,000 شهرياً مقابل عقدة يمكن إبقاؤها مُشبَعة، علاوة 3–9x، وعند ~100 مطور (~$220,000/شهر) يُسدَّد العتاد المملوك في نحو سنة (DoiT).
ثلاثة تخسر فيها الحسابيات وحدها
الفرق الأقل من نحو 10 مطورين. عند ~$22,000/شهر فاتورة المساعد تتعادل مع عقدة لا يستطيع هؤلاء العشرة إبقاؤها مشغولة (DoiT)، والتعادل لا يستحق دورة استدعاء.
أي شخص حمل عمله حركة مستهلكين متقطعة. وحدات GPU الخاملة تُفوتر بالمعدل الكامل، ومنحنى يومي متذبذب يعني أنك تدفع للذروة بينما تتوسط ربما 20% منها. واجهات برمجة النماذج المفتوحة بلا خادم تأكل هذا الملف حياً.
الفرق التي تقع سقف جودتها عند الحدود الأمامية. إذا كانت تقييماتك لا تنجح إلا على Fable 5.1 بـ$10/$50 لكل مليون رمز (Anthropic)، فإن النموذج المفتوح المستضاف ذاتياً هو منتج مختلف بمستوى جودة مختلف، والمدخرات تشتري لك تراجعاً.
اختبار 90 يوماً لتشغيله قبل استثمار رأس المال
- الأسابيع 1–2: قِس التزامن لا الإنفاق. سجّل الطلبات المتزامنة في الدقيقة وجد الـp95 الخاص بك. إذا كان أقل من 4، توقف هنا.
- الأسابيع 3–6: وجّه 10% من حركة المرور إلى نقاط النهاية ذات الأوزان المفتوحة من DeepInfra وشغّل مجموعة التقييم الحالية عليها. هذا تغيير رابط جذر واسم مستعار للنموذج لمعظم الأكوام.
- الأسابيع 7–12: استأجر لا تشترِ. H100 بـ$2.20/ساعة مخصص (DeepInfra) يمنحك رقماً حقيقياً للاستخدام بأقل من $1,700 شهرياً، وهو الرقم الذي سيطلبه مديرك المالي.
إذا كانت البطاقة خاملة أكثر من 60% من الوقت في نهاية ذلك، فالإجابة هي API الأوزان المفتوحة المُدارة، وقد أمضيت ربعاً تتعلم ذلك بدلاً من ثلاث سنوات في استهلاكه.
أسئلة شائعة
هل الاستضافة الذاتية للذكاء الاصطناعي مفتوح المصدر أرخص فعلاً من مقاعد ChatGPT Business أو Claude Team؟
بأسعار المقاعد المعلنة، لا. يكلف Claude Team $20 لكل مقعد شهرياً بالفوترة السنوية ($25 شهرياً)، مع مقاعد مميزة بـ$100/$125، وEnterprise بـ$20 للمقعد سنوياً إضافةً للاستخدام بمعدلات API (Anthropic pricing). لا توجد GPU مستأجرة تقترب من $20 للرأس، لذا الاشتراكات ذات السعر الثابت هي الأصعب في مجال الذكاء الاصطناعي للتغلب عليها بعتادك الخاص. تبدأ الاستضافة الذاتية في المنافسة فقط عندما يعمل فريقك بالفوترة المعتمدة على الاستخدام، حيث يبلغ متوسط مهندسي DoiT الخاصين نحو $2,200 لكل مطور شهرياً (DoiT).
عند أي مستوى إنفاق شهري تصل الاستضافة الذاتية لـLLM إلى نقطة التعادل في 2026؟
تقريباً $15,000 إلى $25,000 شهرياً من إنفاق API المعتمد على الاستخدام، وهو بـ$2,200 لكل مطور شهرياً الذي رصدته DoiT يعادل نحو 7 إلى 12 مقعداً كثيف الاستخدام (DoiT). الرقم يتحرك أكثر بناءً على مزوّد السحابة من النموذج: نفس عقدة 8xH100 لشهر 730 ساعة تكلف نحو $12,600 على Nebius spot، و$22,500 على Nebius عند الطلب، و$40,200 على AWS، و$71,800 على Azure (DoiT). عدد الموظفين هو الوحدة الخاطئة على أي حال. فقط 10 إلى 20% من فريق المطورين لديه طلب قيد التنفيذ في أي لحظة، لذا عشرة مطورين يمثلون جلستين أو ثلاث متزامنة، في أحسن الأحوال نصف طاقة عقدة (DoiT).
كم ساعة GPU أحتاج للتفوق على $0.36 لكل ساعة صوتية من Whisper API؟
معدل النقل هو الفيصل، والساعات مهمة فقط عبر المعدل الذي تُفوتر به. تفرض OpenAI $0.006/دقيقة لـWhisper وgpt-4o-transcribe، أي $0.36 لكل ساعة صوتية، و$0.003/دقيقة ($0.18/ساعة) لـgpt-4o-mini-transcribe (OpenAI). على RunPod L40S 48GB بـ$0.79/ساعة سحابة مجتمع (RunPod)، تحتاج معدل نقل أفضل من نحو 2.2x الوقت الحقيقي للتفوق على $0.36، ونحو 4.4x للتفوق على مستوى mini، ونحو 5.3x للتفوق على معدل $0.15/ساعة Universal-2 من AssemblyAI (AssemblyAI). وقت GPU الخامل يُحسب ضدك، لذا النشر ينجح فقط مع قائمة انتظار ثابتة لا حركة مرور نهارية متقطعة.
هل الذكاء الاصطناعي مفتوح المصدر مجاني للاستخدام التجاري؟
لا، ونماذج الصور هي حيث تُمسك الفرق. يُرجَّح أن أوزان FLUX.1 [dev] تحمل ترخيصاً غير تجاري، مما سيضع ترخيص Black Forest Labs المدفوع بينك وبين نشر تجاري، لذا اقرأ الشروط قبل التخطيط بناءً عليها. حتى مع الأوزان المتاحة بشكل كامل، الحوسبة ليست مجانية: تخدم DeepInfra Llama-3.3-70B-Instruct-Turbo بـ$0.10 إدخالاً و$0.32 إخراجاً لكل مليون رمز، وMeta-Llama-3.1-8B بـ$0.02/$0.04 (DeepInfra)، وهو أرخص مما تستطيع معظم الفرق تشغيل الأوزان المتطابقة بنفسها على H100 مخصص بـ$2.20/ساعة.
هل يجب أن أستضيف ذاتياً لأكون متوافقاً مع GDPR وقانون الذكاء الاصطناعي الأوروبي؟
لا. الامتثال يتعلق بموقع البيانات واتفاقيات المعالجة والتوثيق، ولا يتطلب أي منها امتلاك مجموعة الاستدلال. المخاطر حقيقية (أصدر المنظمون €7.1 مليار عبر 2,245 غرامة GDPR حتى مطلع 2026، والتعرض يصل إلى 4% من الإيرادات العالمية بموجب GDPR وما يصل إلى 7% بموجب AI Act، وفقاً لـKiteworks)، لكن خيارات الاستضافة الإقليمية المُدارة والسيادية داخل الاتحاد الأوروبي تغطي الآن معظم ما يطلبه مسؤول حماية البيانات. استضف ذاتياً عندما تحظر عقد أو جهة تنظيمية بشكل صريح المعالجة من طرف ثالث، لا كتحوّط عام.
هل أشتري وحدات GPU أم أستأجرها خلال نقص الذاكرة في 2026؟
استأجر، ما لم يكن لديك حمل عمل متعدد السنوات يُبقي البطاقات مشغولة. ارتفع NVIDIA RTX PRO 6000 Blackwell 96GB من $8,565 لدى أحد تجار التجزئة في مطلع 2025 إلى $13,250 في يونيو 2026 و$16,000 بحلول أغسطس 2026، بارتفاع نحو 87% لمنتج لم يتغير (igor'sLAB). السبب هو الذاكرة: HBM تأخذ الآن ما يُقدَّر بـ23% من طاقة رقاقات DRAM العالمية مقابل 8% في 2024، وارتفعت أسعار Server DDR5 ECC RDIMM بنحو 100 إلى 116% بين الربع الأول من 2025 والربع الأول من 2026 (DataCenterDisk). توقعت Goldman Sachs عجزاً في DRAM بنسبة 4.9% لعام 2026، الأوسع في 15 سنة، مع إمكانية تعافٍ غير مرجحة قبل أواخر 2027 (Wccftech)، لذا خطط لأسعار شراء مرتفعة وخذ فروق سوق التأجير بدلاً من ذلك، من $2.20/ساعة لـH100 مخصص على DeepInfra وحتى $4.29/ساعة على Lambda.