

أربعة سير عمل مالي بالذكاء الاصطناعي تجتاز المعيار في 2026: التسوية، والتنبؤ، وتصنيف المصروفات، والتحضير للتدقيق. كل ما عدا ذلك لا يزال في مرحلة تجريبية مع عروض توضيحية جيدة.
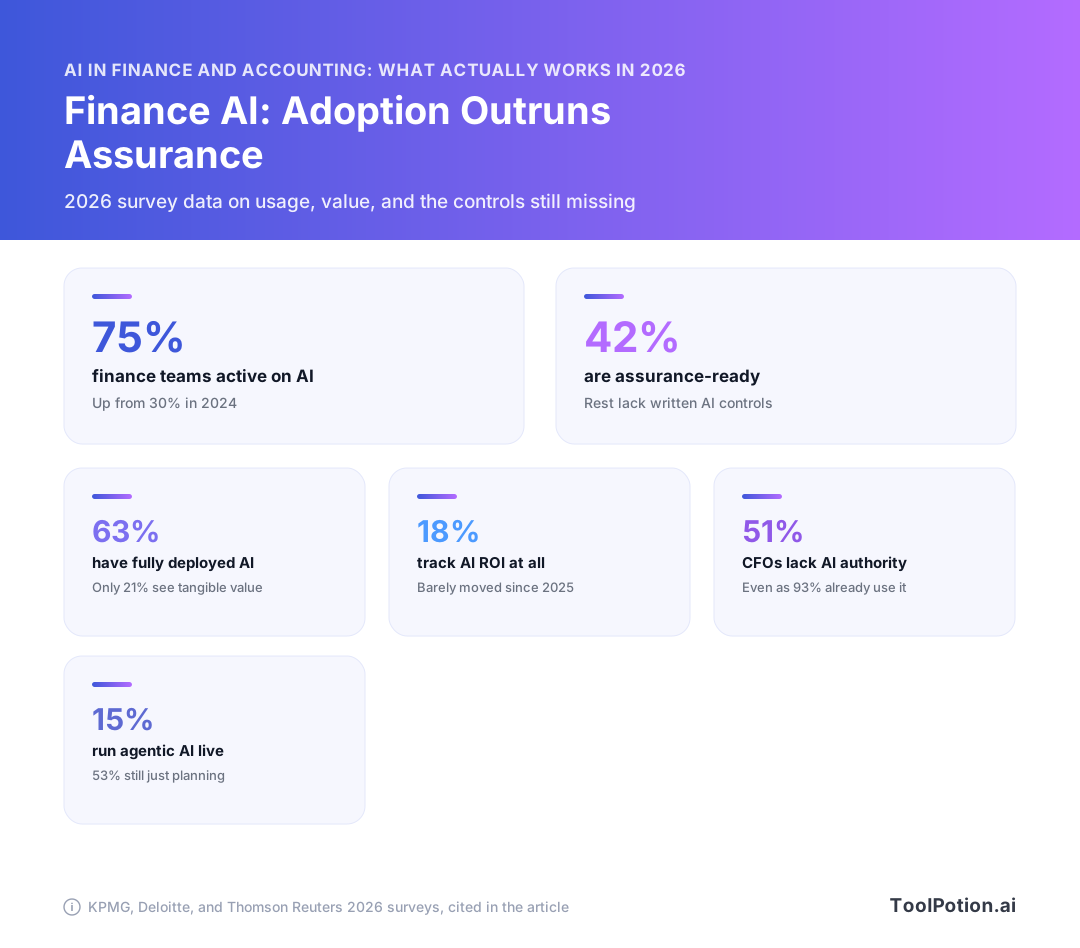
أرقام التبني لن تساعدك على الاختيار. تقول KPMG إن الاستخدام الفعلي للذكاء الاصطناعي في الوظيفة المالية بلغ 75% في 2026، مقارنة بـ 30% في 2024. وجد استطلاع Deloitte للاتجاهات المالية الذي شمل 1,326 مديراً أن 63% نشروا الذكاء الاصطناعي بالكامل، لكن 21% فقط يرون قيمة ملموسة. وجدت Thomson Reuters أن 18% يتتبعون العائد على الاستثمار بأي طريقة كانت. هذه ليست تناقضات، بل هي ثلاثة تعريفات لكلمة «تبني».
لذا، يُصفّي هذا المقال بالضوابط: ما تتطلبه توجيهات COSO للذكاء الاصطناعي التوليدي الصادرة في فبراير 2026، وما تقيسه حقاً حاشية دقة المورد، وأيٌّ من 309 أدوات المالية والمصرفية في دليلنا ينجو من كلا الاختبارين.
أرقام التبني لعام 2026 تتناقض مع بعضها، لذا اقرأها وفق تعريفها
حين يقول استطلاع 93% ويقول آخر 14%، قد يكون كلاهما صحيحاً. إنهما يحصيان أشياء مختلفة، وكاد أيٌّ منهما لا يصرّح بذلك في العنوان.
الاستخدام التجريبي والاستخدام المنشور واستخدام سير العمل الأساسية ثلاثة أسئلة مختلفة
وجد تقرير KPMG العالمي للذكاء الاصطناعي في المالية 2026 أن الاستخدام الفعلي للذكاء الاصطناعي في الوظيفة المالية تضاعف من 30% في 2024 إلى 75% في 2026، مع قول 71% من قادة المالية إن الذكاء الاصطناعي يلبي توقعات العائد أو يتجاوزها. «الاستخدام الفعلي» هنا يشمل أي شيء يعمل، بما في ذلك مراقب يلصق تعليقاً على التباين في نافذة محادثة. Thomson Reuters، عند السؤال عن استخدام الذكاء الاصطناعي التوليدي على مستوى المؤسسة، حصلت على 40%، مرتفعاً من 22% قبل عام، و15% فقط للذكاء الاصطناعي الوكيل مع 53% يخططون له أو يفكرون فيه. نفس العام، نفس المهنة، فارق ثلاثة أضعاف. الفارق سببه صياغة السؤال، لا السوق.
قبل أن تستشهد بأي رقم، اعثر على تعريفه: هل يحسب كل من جرّب أداة، أم كل شركة اشترت واحدة، أم سير عمل أجتاز إغلاق نهاية الشهر مع مدقق يراقبه؟ الثالث فقط يخبرك بشيء عن خارطة طريقك الخاصة.
الفجوة بين النشر والقيمة التي لا يسويها أحد
استطلاع Deloitte لاتجاهات المالية 2026 الذي شمل 1,326 مديراً مالياً عالمياً هو الاستطلاع الذي ينبغي الاحتفاظ به، لأنه طرح الشقين معاً. 63% نشروا الذكاء الاصطناعي في المالية بالكامل، 21% يعتقدون أن تلك الاستثمارات حققت قيمة ملموسة، و14% دمجوا وكلاء الذكاء الاصطناعي بالكامل. النشر يساوي تقريباً ثلاثة أضعاف القيمة. هذه الفجوة هي الواقع الفعلي للذكاء الاصطناعي المالي في 2026، وهو الرقم الذي ينبغي أن تحمله إلى أي مكالمة مع مورد.
كاد لا أحد يقيس العائد على الاستثمار أصلاً
هذا هو الجزء الذي يجعل كل مخطط تبني أهشّ مما يبدو: 18% فقط من المستطلعين يعرفون أن مؤسستهم تتتبع عائد الاستثمار في الذكاء الاصطناعي بأي طريقة، مستقر تقريباً عاماً بعد عام، ومعظم من يتتبعون يقيسون مقاييس تشغيلية داخلية لا نتائج أعمال. الرضا الذاتي عن إنفاق غير مقاس مزاج، لا دليل.
عادتان تساعدان. اقرأ كل إحصاء مقابل تعريف الاستطلاع الخاص قبل إعادة نشره، وعامل أي رقم من دراسة ترعاها شركة مورد باعتباره ادعاء تسويقي حتى تجد الحاشية. نطبق نفس المصفاة على 309 أداة من أدوات الذكاء الاصطناعي المالي والمصرفي في دليلنا وعلى تقارير اتجاهات الذكاء الاصطناعي التي نتابعها، ولهذا القائمة المختصرة في القسم التالي قصيرة.
التسوية: معدل المطابقة التلقائية الذي ستحصل عليه فعلاً
خطط لتصديق 60% إلى 80% من الحسابات تلقائياً، وابنِ حالتك التجارية عند الحد الأدنى لهذا النطاق. الرقم الذي ستسمعه في العرض التوضيحي هو «حتى 98%» تصديقاً تلقائياً بدقة مطابقة 99%. نتائج نشر العملاء الفعلية تتراوح بين 43% و85%، مما يجعل 60-80% افتراض التخطيط الواقعي (Numeric). إذا كان نموذج تخصيص موارد الإغلاق لديك يعمل فقط عند 90%، فالمشروع يفشل قبل أول إغلاق شهري.
سقف التسويق مقابل النطاق الفعلي للعملاء
الحد الأدنى 43% والحد الأقصى 85% لنفس البرنامج. الفارق هو بياناتك، لا نموذج المورد.
يمكن تحقيق 98% على شريحة ضيقة: حسابات عالية الحجم منخفضة التباين كمقاصة النقد المصرفي وبطاقات الائتمان، مع مطابقة نظيفة واحداً لواحد وعتبة أهمية محددة بسخاء. وسّع نفس الأداة إلى المصروفات المدفوعة مسبقاً وبين الشركات والالتزامات المستحقة والمخزون، وستنخفض النسبة المصدّقة بشدة لأن هذه الحسابات تحتاج إلى حكم، لا مجرد مطابقة. اسأل أي مورد عن أنواع الحسابات التي تغطيها نسبة العميل المرجعي. إذا كانت الإجابة «النقد والذمم المدينة»، فقد اكتشفت أن الرقم نسبة مجموعة فرعية، لا نسبة محفظة.
ما يحدد الفجوة: جودة البيانات، وتغطية السجلات الفرعية، وعتبات الأهمية
ثلاثة أشياء تحدد موضعك، وأنت تتحكم في جميعها قبل التوقيع على أي شيء. تغطية السجل الفرعي أولاً: الحسابات التي تعيش تفاصيلها الداعمة في جدول بيانات أو نظام بلا واجهة برمجية لا يمكن تصديقها تلقائياً بأي دقة، فاحسبها واطرحها من المقام الآن. جودة البيانات ثانياً، وتعني معرفات مرجعية متسقة وتسمية مورد ثابتة وتغذية مصرفية لا تعدّل الفترات السابقة. عتبات الأهمية ثالثاً، وهي الرافعة التي يسحبها الناس بهدوء لتحسين مظهر لوحة البيانات.
ارفع عتبة التصديق التلقائي من 500 دولار إلى 5,000 دولار وسترتفع نسبتك دون أي تحسين في المطابقة الأساسية. سيلاحظ مدققك ذلك. حدد العتبة من وثائق SOX الموجودة لديك واتركها للفترة التجريبية، ثم قِس. دراسات الحالة للذكاء الاصطناعي ذات النتائج المُفصح عنها في دليلنا تستحق القراءة بنفس المصفاة: تحقق مما إذا كانت النسبة المُبلَّغ عنها تسمي أنواع الحسابات والعتبة، لأن معظمها لا تفعل.
معايير القبول التي ينبغي كتابتها في مرحلة الاختبار
اكتب هذه في نموذج الطلب، لا في عرض الانطلاق. قم بتشغيل إغلاق كامل لنهاية الربع، الأشهر الثلاثة كاملة، عبر محفظة حساباتك الفعلية.
- معدل تصديق تلقائي لا يقل عن 65% عبر جميع حسابات الميزانية العمومية في النطاق، مقاساً عند عتبة الأهمية الحالية مع تجميد العتبة طوال فترة الاختبار.
- معدل تصديق خاطئ صفر على الحسابات ما فوق الأهمية، حيث يعني التصديق الخاطئ أن الأداة صادقت رصيداً أعاد فتحه مراجع لاحقاً. هذا هو الرقم الذي ينهي الاختبار، لا معدل المطابقة.
- كل تصديق ينتج مساراً تدقيقياً قابلاً للتصدير يُظهر السجلات المصدرية المطابَقة، وإصدار القاعدة أو النموذج المطبق، والشخص الذي وافق على قائمة الاستثناءات.
- نسبة التجاوز تُتابع شهرياً وتُرفع إليك، حتى ترى الانحراف قبل أن يراه مدققك.
إذا لم يلتزم المورد بمعدل مقاس على بياناتك، فاسعّر الصفقة كما لو كنت ستحصل على 43%.
التنبؤ: مكاسب حقيقية في السرعة، ومكاسب متفاوتة جداً في الدقة
اشترِ ذكاء اصطناعي FP&A لتوفير وقت الدورة، لا للحصول على رقم أفضل. وجد استطلاع KPMG لمارس 2026 الذي شمل 1,013 قائداً مالياً رفيعاً من 20 دولة أن سرعة اتخاذ القرار تحسنت لدى 71% وجودة القرار لدى 70%، بينما تحسنت دقة التنبؤ لدى 64% (KPMG). تلك النسبة 64% هي الأضعف من بين الثلاثة، وتخفي نطاقاً واسعاً بما يكفي لتدمير حالة عمل.
سرعة اتخاذ القرار تتحسن بشكل أكثر موثوقية من دقة التنبؤ
مكاسب السرعة والجودة تأتي من العمل الذي يُحسن فيه الذكاء الاصطناعي: سحب الأرقام الفعلية من أربعة أنظمة في عرض تباين واحد، وصياغة التعليقات، وإعادة تشغيل سيناريو في دقائق بدلاً من يوم. لا يتطلب أيٌّ من ذلك من النموذج توقع أي شيء. يتطلب منه التجميع والشرح، وهو الجزء الذي يُجيده.
لذا اكتب معايير النجاح بالأيام، لا بالنقاط الأساسية. وقت دوران الإغلاق إلى التنبؤ، عدد السيناريوهات المُشغَّلة لكل دورة، ساعات وقت المحلل المُنفق على تجميع البيانات. إذا كان اختبار قبولك الوحيد هو خطأ التنبؤ، فأنت تراهن على الأضعف من بين المخرجات الثلاثة المقاسة لدى KPMG.
لماذا تشهد البنوك 71% والرعاية الصحية 44%
تفاوتت مكاسب دقة التنبؤ من 71% في القطاع المصرفي إلى 44% في الرعاية الصحية في نفس بيانات KPMG (KPMG). يتتبع الفارق مدى القطاع من تاريخ نظيف وعالي التردد ومنظم. للبنوك بيانات معاملات يومية وعقود منها، مسعّرة ومختومة بالوقت. يعتمد تنبؤ الرعاية الصحية على مزيج الدافعين وشروط العقود وتوقيت السداد، التي تعيش في نص وتتغير بالعقد.
اسأل المورد من أي من هذين العالمين جاء عملاؤه المرجعيون. نتيجة 71% في قطاع غني بالبيانات لا تخبرك تقريباً بشيء عن تنبؤ إيراداتك إذا كانت مدخلاتك ملفات PDF للعقود.
أين تقف مساعدات FP&A: طبقة الافتراضات تبقى بيد الإنسان
يمكن للنموذج استقراء اتجاه حجوزاتك. لكنه لا يستطيع تقرير أن مستوى التسعير الجديد يغيّر معدل الانسحاب، أو أن خطة التوظيف للربع الثالث تتأخر ستة أسابيع، أو أن عميلاً يعيد التفاوض في نوفمبر ينبغي تخفيضه بنسبة 30%. هذه الافتراضات هي التي تقود التنبؤ، وتأتي من أشخاص يتحدثون مع المبيعات والعمليات.
حدد نطاق الأداة لكل ما هو تحت خط الافتراضات، واحتفظ بالافتراضات في سجل قابل للمراجعة مع مالك وتاريخ لكل منها.
تصنيف المصروفات: أقرب شيء إلى سير عمل محلول
إذا كنت ستختبر سير عمل واحد للذكاء الاصطناعي المالي هذا الربع، فليكن ترميز المعاملات ومراجعة سياسة المصروفات. المهمة ضيقة، الحقيقة الأساسية مكتوبة في وثيقة سياستك الخاصة، وكل قرار يتخذه الوكيل يترك مساراً قابلاً للمراجعة.
لماذا تناسب فحوصات السياسة وكيلاً أفضل مما تناسبه الأحكام
فحص السياسة هو بحث مقابل قواعد كتبتها أنت. هل لهذا العشاء بقيمة 340 دولاراً إيصال وغرض تجاري وحضور ضمن الحد الأقصى للفرد؟ هذا تفكير حتمي عبر حقول منظمة بالإضافة إلى صورة إيصال، وأوضاع الفشل مرئية للمراجع في ثوانٍ. قارن ذلك بتنبؤ لا يستطيع أحد إخبارك فيه ما إذا كان الرقم خاطئاً حتى ينتهي الربع. الترميز أقرب إلى طرف السياسة: التاجر، والمبلغ، والقسم، وحساب دفتر الأستاذ العام، مع الترميز التاريخي كمجموعة التسميات.
الحجم يساعد أيضاً. تحصل على آلاف القرارات شبه المتطابقة شهرياً، وهو بالضبط الشكل الذي يجعل معدل الدقة ذا معنى بدلاً من كونه مجرد أنيكدوت.
ما يقيسه تعريف دقة المورد فعلاً
تنشر Ramp انخفاضاً بنسبة ~85% في المراجعات اليدوية بدقة 99%+ لوكيل سياستها، وتعرّف الدقة في الحاشية: الموافقات الموصى بها من الوكيل التي وافق عليها المراجعون البشريون أيضاً، من تحليل داخلي مؤرخ 1/7/25 (Ramp Support). اقرأ هذا التعريف مرتين قبل أن يدخل في حالة عمل. إنه يقيس الاتفاق على مسار الموافقة، لذا لا يقول شيئاً عن المصروفات التي وضعها الوكيل في قائمة خاطئة، ولا شيء عن المخالفات التي وافق عليها مراجع على أي حال. المنهجية المُفصح عنها تضع Ramp في مقدمة معظم المجال، الذي ينشر في معظمه نسبة مئوية بلا مقام. اطلب من كل مورد في قائمتك المختصرة نفس الحاشية، وعامل الرفض إجابة.
تصميم الإنسان في الحلقة للاستثناءات المتبقية
وجّه 15% التي لن يصفيها الوكيل إلى مراجع مُسمّى، وسجّل معدل التجاوز، وحدد عتبة تُطلق إعادة التدريب حين ترتفع التجاوزات. نسبة التجاوز هذه هي أحد مؤشرات KPI للانجراف التي تطالب بها COSO في توجيهات الذكاء الاصطناعي التوليدي الصادرة في فبراير 2026 (Deloitte Heads Up). من بين 550 وكيل ذكاء اصطناعي مدرج في دليلنا، الأدوات التي تستحق وقتك هي تلك التي تُسلّمك ذلك السجل دون تذكرة دعم.
التحضير للتدقيق: أدلة يمكن لمدققك اختبارها فعلاً
اطرح على أي مورد لتحضير التدقيق سؤالاً واحداً قبل أن تشاهد العرض: كيف يبدو التصدير حين يسأل فريق المشاركة كيف أُنتج هذا الرقم؟ إذا كانت الإجابة نسخة محادثة، فأنت تشتري أداة إنتاجية، لا أداة تحضير للتدقيق.
لا معيار PCAOB خاص بالذكاء الاصطناعي التوليدي، لكن AS 1105 و AS 2301 ينطبقان بالفعل
لا يوجد معيار PCAOB مكتوب للذكاء الاصطناعي التوليدي. هذه ليست فجوة يمكنك الجلوس فيها. المعايير القائمة للأدلة التدقيقية وتقييم المخاطر تحدد بالفعل المستوى المطلوب للعمل المُساعَد بالذكاء الاصطناعي (Fieldguide)، مما يعني أن جدول بيانات أنتجه الذكاء الاصطناعي يُقيَّم على أساس الكفاية والملاءمة تماماً كجدول بيانات أعده مساعد يدوياً. مدققك لا يحتاج إلى قاعدة جديدة لرفضه.
أكمل COSO الشق الحوكمي في 23 فبراير 2026، بأول امتداد رسمي لإطاره المتكامل للرقابة الداخلية إلى الذكاء الاصطناعي، مُصنِّفاً حالات استخدام الذكاء الاصطناعي التوليدي في ثمانية أنواع من القدرات تشمل الاستيعاب والتحويل والترحيل والحكم (Journal of Accountancy). الاستيعاب والتحويل هما الأسهل دفاعاً. الحكم هو حيث تطول الأسئلة.
ما تعنيه الأدلة الكافية الملائمة حين أنتجها نموذج
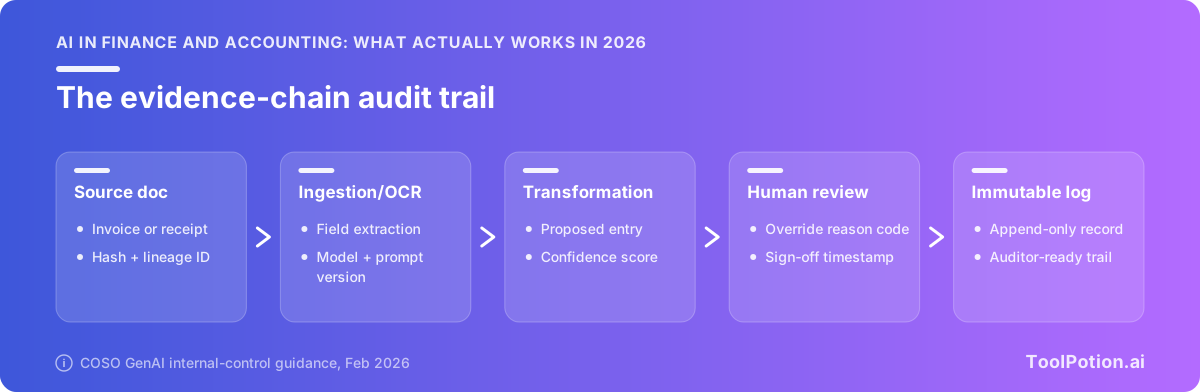
يعني ذلك أن المخرج يجب أن يعود إلى وثيقة مصدرية يمكن لمدققك فتحها. الاستخراج هو سير العمل الذي يصمد هنا أفضل من غيره، لأن ملف PDF الأساسي أو الفاتورة لا تزال هي الدليل والنموذج مجرد عين أسرع عليها. إذا كنت تبحث في هذه الطبقة، يتتبع دليلنا 217 أداة لاستخراج المستندات وملفات PDF، والجديرة بوقتك هي تلك التي تُظهرك مرجعاً بالصفحة والإحداثيات لكل حقل تسحبه، لا إجابة ملخصة.
صاغ Sebastian Stöckle، الرئيس العالمي لابتكار التدقيق والذكاء الاصطناعي في KPMG International، الاختبار ببساطة: «لا يُحقق الذكاء الاصطناعي قيمة حقيقية إلا حين يمكن شرحه والتحكم فيه» (KPMG).
الاحتفاظ والتسجيل وإعادة الإنتاج لتحديدها مسبقاً
اكتب هذه في العقد، لأن استرجاعها بعد النشر مكلف. اطلب معرف النموذج والإصدار المختوم على كل تشغيل، والموجّه أو الإعداد المستخدم، والسلسلة غير القابلة للتغيير من حقل المخرج إلى الوثيقة المصدرية والصفحة، وسجل قابل للتصدير لمن راجع وافق على كل بند مع طابع زمني، ونافذة احتفاظ تطابق سياسة احتفاظ التدقيق لديك لا الإعداد الافتراضي للمورد. اسأل ماذا يحدث لسجلاتك حين يحدّث المورد النموذج الأساسي في منتصف العام.
ثم استمر في مراقبتها. توجيهات COSO تطلب مراقبة مستمرة لأداء النموذج مع مؤشرات KPI كحجم المعاملات وحجمها ونسب التجاوز، لأن الضوابط «اضبط وانسَ» لا تكتشف الانجراف (Deloitte). معدل التجاوز هو الذي تضعه على لوحة البيانات. إذا كان مراجعوك يصححون النموذج بهدوء على 30% من البنود، فلديك ملاحظة ضبط داخلي تنتظر أن تُكتب وحالة عمل لم تصل أبداً.
قائمة التحقق من الضوابط التي تصفي قائمتك المختصرة
سلّم هذه لكل مورد قبل العرض التوضيحي الثاني. معظمها مستخرج مباشرة من وثيقة COSO «تحقيق رقابة داخلية فعالة على الذكاء الاصطناعي التوليدي»، الصادرة في 23 فبراير 2026 كأول امتداد رسمي للإطار المتكامل للرقابة الداخلية (2013) إلى حوكمة الذكاء الاصطناعي (Journal of Accountancy). إنها أقرب شيء لديك إلى معيار مكتوب، والموردون الذين يبيعون في قطاع المالية ينبغي أن يعرفوها بالفعل.
أنواع القدرات الثمانية للذكاء الاصطناعي التوليدي في COSO، وأيها يلمس حالة استخدامك
يصنف COSO حالات استخدام الذكاء الاصطناعي التوليدي في ثمانية أنواع من القدرات: الاستيعاب والتحويل والترحيل والتنسيق والحكم والمراقبة والذكاء التنظيمي والتفاعل بين الإنسان والذكاء الاصطناعي (Journal of Accountancy). اجعل المورد يُخبرك أيها يُؤدي منتجه، كتابةً.
الخط الفاصل هو الترحيل والحكم. أداة تستوعب المستندات فقط وتحوّلها إلى مسودة تمثّل مشكلة ضبط مختلفة عن أداة تكتب في دفتر الأستاذ أو تقرر ما إذا كان الاستثناء مقبولاً. ترميز المصروفات يلمس عادةً الاستيعاب والتحويل والحكم. التصديق التلقائي للتسوية يلمس الترحيل. إذا كانت إجابة المورد «الأنواع الثمانية»، فهو لم يقرأها أيضاً.
من ضمان نقطة الزمن إلى المراقبة المستمرة
جولة التفتيش القديمة بأسلوب SOC لا تغطي نموذجاً ينجرف بين الأرباع. يطالب توجيه COSO بمراقبة مستمرة لأداء النموذج بدلاً من ضمان ثابت في نقطة زمنية، مع مؤشرات KPI تُعطى الأولوية لحجم المعاملات وأحجامها ونسب التجاوز لاكتشاف الانجراف. الضوابط «اضبط وانسَ» غير كافية صراحةً (Deloitte Heads Up).
مؤشرات KPI للتجاوز والانجراف المطلوب تضمينها في العقد
- معدل التجاوز حسب المستخدم وحسب نوع المعاملة، قابل للتصدير شهرياً، ليس مجرد مرئي في لوحة بيانات.
- تاريخ إصدارات النموذج مع التواريخ، حتى تتمكن من ربط تغيير في معدل الخطأ بإصدار محدد بدلاً من التخمين.
- الدقة مقاسة على بياناتك خلال فترة تشغيل متوازٍ تحددها أنت، مع كتابة المقام.
- عتبة مُسمّاة تُطلق المراجعة. حدد رقماً الآن (مثلاً، معدل تجاوز فوق 8% في أي شهر) وضعه في العقد.
جاهزية الضمان هي المتغير الذي يتنبأ بالنتائج
وجدت KPMG أن 42% فقط من المؤسسات جاهزة للضمان بالكامل، والفجوة في النتائج ليست دقيقة: تلك الشركات تُبلّغ عن تحسينات في تقليل الأخطاء بنسبة 33% مقابل 6% للنظيرات غير الجاهزة، والثقة في توسيع نطاق الذكاء الاصطناعي 42% مقابل 14% (KPMG).
لا يُحقق الذكاء الاصطناعي قيمة حقيقية إلا حين يمكن شرحه والتحكم فيه. تُميّز جاهزية الضمان الأداء المستدام عن المخاطر المخفية. — Sebastian Stöckle، الرئيس العالمي لابتكار التدقيق والذكاء الاصطناعي، KPMG International
قم بتطبيق قائمة التحقق قبل اختيار القائمة المختصرة، لا بعدها. تضم فئة المالية والبنوك لدينا 309 إدراجاً، وقائمة التحقق تختصرها إلى حفنة أسرع من أي مقارنة للميزات.
اقرأ كل ادعاء دقة مقابل حاشيته الخاصة
كل رقم أداء في عرض الذكاء الاصطناعي المالي هو قياس، والقياس بلا مجتمعه وتعريف الصحة وتاريخه هو أصل تسويقي. الحواشي منشورة عادةً. كاد لا أحد يقرأها.
ثلاثة أسئلة تُفرغ معظم الأرقام
اطرحها بالترتيب، كتابةً، قبل العرض التوضيحي الثاني.
- أي المعاملات تم احتسابها؟ ليس الحجم الكلي، بل المجموعة الفرعية التي حُسب عليها الرقم.
- ما الذي جعل إجابة صحيحة؟ حدد شخص ما الحقيقة الأساسية. احصل على ذلك التعريف كلمةً بكلمة.
- متى قُيس، وعلى بيانات من؟ تحليل داخلي واحد من العام الماضي ليس مستوى خدمة.
المقامات والتواريخ والمقارنات المختارة ذاتياً
تنشر Ramp انخفاضاً بنسبة ~85% في مراجعات المصروفات اليدوية بدقة 99%+، وتعرّف وثائقها الخاصة تلك الدقة بأنها الموافقات الموصى بها من الوكيل التي وافق عليها المراجعون البشريون أيضاً، من تحليل داخلي مؤرخ 1/7/25 (Ramp Support). هذا مقياس اتفاق على مسار الموافقة. لا يقول شيئاً عن المصروفات التي وضعها الوكيل في قائمة خاطئة واضطر مراجع إلى التراجع عنها، وهو نوع الخطأ الذي يهتم به مراقبك.
ادعاءات التسوية تفشل بطريقة مختلفة. رقم التصديق التلقائي مُقدَّم كسقف، «حتى 98%»، بينما تتراوح نشريات العملاء بين 43% و85% (Numeric). السقف حقيقة عن أفضل حساب في أفضل شهر لدى أفضل عميل.
كيف يبدو الإفصاح الموثوق
يُسمي حجم العينة وقاعدة التسجيل والتاريخ، كما تفعل Ramp، ويُبلّغ عن معدل الموافقة الخاطئة جانباً مع معدل الدقة. اطلب الرقم المحسوب على ربعك الأخير من البيانات خلال الاختبار. المورد الذي يرفض إجراء هذا الاختبار أخبرك بما ستقوله حاشيته.
لماذا تموت العروض عند إغلاق نهاية الشهر، وتصميم الاختبار الذي يمنع ذلك
العرض يعمل على مقتطف منتقى. السجل الفرعي النظيف للربع الأخير، وعشرات الفواتير المنسقة بشكل جيد، ولا شيء بين الشركات، ولا قيد يومية يدوي نشره فريق الضرائب في الساعة 11 مساءً في اليوم الثالث. الإغلاق هو مجتمع معاكس، وكل وضع فشل كان مهندس المبيعات سيُخرجه من المكالمة يظهر دفعة واحدة، في موعد نهائي، أمام مراقبك.
بناء الاسترداد يتحكم في الدقة أكثر مما يتحكم اختيار النموذج
استبدل نموذجاً حدودياً بآخر على نفس مجموعة الأسئلة المالية وستتغير الإجابات قليلاً. غيّر طريقة تقسيم المستندات، وأي ملف للفترة يُسحب، وما إذا كانت الحواشي تنتقل مع الجدول، وستتغير الإجابات كثيراً. معظم الإجابات الخاطئة في أسئلة وأجوبة المالية هي إخفاقات استرداد في جملة سليمة: وجدت الأداة جدول السنة المالية 2024 حين سألت عن 2025، والنثر يُقرأ بشكل مثالي في كلتا الحالتين.
يعامل توجيه COSO الصادر في فبراير 2026 الاستيعاب والتحويل كأنواع قدرات منفصلة عن الحكم، يحمل كل منها ضوابطه الخاصة (Journal of Accountancy). اختبر الأنابيب على ملفاتك المصدرية المعقدة الخاصة. مجموعة عينة المورد لا تخبرك تقريباً بشيء.
المراجعون ذوو الخبرة يجنون معظم المكسب
ضع الأداة أمام أقوى اثنين من كبار موظفيك قبل طرحها على الفريق. البحث الميداني الذي يُحدد وقت توفير الذكاء الاصطناعي للمحاسبين القانونيين يشير إلى نفس الاتجاه: الساعات تنتقل إلى الأشخاص الذين يعرفون مسبقاً كيف تبدو الإجابة الصحيحة ويمكنهم اكتشاف الخاطئة في ثوانٍ (Journal of Accountancy).
تجاوز طبقة المراجعة وستحصل على نتيجة Deloitte: رد أكثر من 60,000 دولار للحكومة الأسترالية على تقرير يحتوي على أخطاء مولّدة بالذكاء الاصطناعي (CFO Dive).
التكلفة وغموض القيمة وضعف ضوابط المخاطر تُوقف مشاريع الوكلاء
قدرة النموذج نادراً ما تعيق هذه البرامج. وجد استطلاع Deloitte لاتجاهات المالية لـ 1,326 مديراً مالياً أن 63% نشروا الذكاء الاصطناعي في المالية بالكامل بينما 21% فقط رأوا قيمة ملموسة، و14% دمجوا وكلاء بالكامل (CFO Dive). تضع Thomson Reuters تبني الذكاء الاصطناعي الوكيل عند 15% مقابل 53% يخططون له أو يفكرون فيه (Thomson Reuters). في إشارات CFO الربع الثاني 2026 لـ Deloitte، سمّى 59% من CFOs الموازنة بين ضغط النشر ومقابل المخاطر تحديهم الأكبر و51% قالوا إنهم يفتقرون إلى سلطة الحوكمة (Deloitte).
اختبار 90 يوماً مع الأرقام مكتوبة قبل البدء
- اختر سير عمل واحداً وكياناً واحداً. التسوية لشركة تابعة واحدة أفضل من طرح مالي شامل لا يمكن قياسه.
- ضع الخط الأساسي لإغلاقين قبل أن تلمس الأداة أي شيء: الساعات المُنفقة وعدد الاستثناءات ومعدل إعادة العمل وأيام التصديق.
- اتفق على عتبة القبول كتابةً مع مراقبك وشريك المشاركة من مدقق خارجي، وضع تاريخاً عليها.
- راقب معدلات التجاوز أسبوعياً، جنباً إلى جنب مع حجم المعاملات وأحجامها، وهو إشارة الانجراف التي تبنى عليها توقعات المراقبة المستمرة لـ COSO (Deloitte Heads Up).
- اكتب معيار الإيقاف في اليوم الأول. شيء مثل: إذا بقي التصديق التلقائي تحت 55% في اليوم 90، أو تجاوز تجاوز المراجع 15% لثلاثة أسابيع متتالية، نتوقف ونعيد التفاوض.
ثم انشر النتيجة داخلياً، بما فيها الأرقام، كما توثّق الفرق النشر الفعلي في دليلنا. 18% فقط من المؤسسات تتتبع عائد الاستثمار في الذكاء الاصطناعي بأي طريقة (Thomson Reuters)، لذا فإن خطاً أساسياً مكتوباً يضعك في مقدمة أربعة من كل خمسة مشترين عند وقت التجديد.
الأسئلة الشائعة
هل الذكاء الاصطناعي موثوق بما يكفي لمسك الدفاتر دون مراجع بشري في 2026؟
لا، وأطر الضبط الآن تفترض أنك ستحتفظ بمراجع. تضع KPMG الاستخدام الفعلي للذكاء الاصطناعي في الوظيفة المالية عند 75% في 2026، مرتفعاً من 30% في 2024، لكن 42% فقط من المؤسسات جاهزة للضمان بالكامل، والتي تُبلّغ عن مكاسب في تقليل الأخطاء بنسبة 33% مقابل 6% للباقين (KPMG، 11 مايو 2026). يعامل توجيه COSO لفبراير 2026 الضوابط «اضبط وانسَ» باعتبارها غير كافية صراحةً ويدفع نحو مراقبة مستمرة لأداء النموذج (Deloitte Heads Up). المخرجات غير المراجَعة لها ثمن فعلي: Deloitte ردّت أكثر من 60,000 دولار للحكومة الأسترالية على تقرير يحتوي على أخطاء ذكاء اصطناعي (CFO Dive).
ما معدل المطابقة التلقائية الذي ينبغي أن أتوقعه من برنامج تسوية الذكاء الاصطناعي؟
خطط لتصديق تلقائي بنسبة 60% إلى 80%، لا للرقم الموجود على الشريحة. يسوّق بائعو التسوية «حتى 98%» تصديقاً تلقائياً بدقة مطابقة 99%، بينما تتراوح نتائج العملاء الفعلية بين 43% و85% (Numeric). اكتب المعدل في معايير قبولك وقِسه على دفتر أستاذك التاريخي الفعلي خلال الاختبار، لا على بيانات العرض، ثم أعد القياس بعد ثلاثة إغلاقات لأن جودة المطابقة تنجرف مع تغيّر مزيج معاملاتك (Deloitte Heads Up on COSO).
ما الذي يتطلبه توجيه COSO لفبراير 2026 للذكاء الاصطناعي المستخدم في التقارير المالية؟
نشر COSO «تحقيق رقابة داخلية فعالة على الذكاء الاصطناعي التوليدي» في 23 فبراير 2026، أول امتداد رسمي لإطاره المتكامل للرقابة الداخلية لعام 2013 إلى حوكمة الذكاء الاصطناعي، ويُصنّف حالات استخدام الذكاء الاصطناعي التوليدي في ثمانية أنواع من القدرات: الاستيعاب والتحويل والترحيل والتنسيق والحكم والمراقبة والذكاء التنظيمي والتفاعل بين الإنسان والذكاء الاصطناعي (Journal of Accountancy). المطلب التشغيلي هو الانتقال من ضمان نقطة الزمن إلى مراقبة مستمرة، مع مؤشرات KPI كحجم المعاملات وأحجامها ونسب التجاوز لاكتشاف انجراف النموذج (Deloitte Heads Up). صنّف كل أداة تشغّلها حسب نوع القدرة، وحدد عتبة لكل مؤشر KPI، وسجّل التجاوزات من اليوم الأول، لأن أداة الترحيل أو الحكم تحمل توقعات ضبط أثقل بكثير من أداة الاستيعاب.
هل سيقبل مدققي أوراق العمل المُعدَّة بالذكاء الاصطناعي التوليدي؟
نعم، إذا استطعت إثبات كيفية إنتاج المخرج ومن راجعه. لم يُصدر PCAOB معياراً للذكاء الاصطناعي التوليدي، ومعاييره القائمة للأدلة التدقيقية وتقييم المخاطر تحدد بالفعل المستوى المطلوب للكفاية والملاءمة وقابلية المراجعة (Fieldguide). احتفظ بالموجّه والمستندات المصدرية التي استردها الأداة والنموذج والإصدار والتاريخ وتوقيعات المُعدّ والمراجع، حتى تقف ورقة العمل بذاتها دون أن يعيد أحد تشغيل النموذج. توقع أن تصبح الأسئلة أحدّ: PwC طالبت PCAOB بجعل الذكاء الاصطناعي في التدقيق أولويتها القصوى (Big4 News).
كيف أحسب عائد الاستثمار على أداة مالية بالذكاء الاصطناعي حين 18% فقط من المؤسسات تتتبعه؟
التقط الخط الأساسي قبل بدء الاختبار، لأنك لا تستطيع إعادة بنائه لاحقاً. 18% فقط من المحترفين علموا أن مؤسستهم تتتبع عائد الاستثمار في الذكاء الاصطناعي بأي طريقة في 2026، مستقر تقريباً من 2025، ومعظم هؤلاء يقيسون مقاييس تشغيلية داخلية لا نتائج أعمال (Thomson Reuters، 9 فبراير 2026). الفجوة التي يخلقها واضحة في استطلاع Deloitte لاتجاهات المالية لـ 1,326 مديراً مالياً: 63% نشروا الذكاء الاصطناعي في المالية بالكامل و21% يعتقدون أنه حقق قيمة ملموسة (CFO Dive). تتبّع أربعة أرقام عبر نافذة زمنية ثابتة: ساعات الإغلاق، ومعدل الاستثناء، وزمن دورة المعاملة، والتكلفة الإجمالية بما فيها وقت المراجعة الذي تخلقه الأداة. نتيجة KPMG أن 71% من قادة المالية يقولون إن الذكاء الاصطناعي يلبي توقعات العائد أو يتجاوزها تقيس التوقعات، فلا تستبدلها بأرقامك الخاصة (KPMG).
أي سير عمل مالي ينبغي أتمتته أولاً؟
تصنيف المصروفات ومراجعة السياسة، في الغالب لأنه سير العمل الوحيد الذي ينشر فيه مورد ما يعنيه رقم دقته: تُبلّغ Ramp عن انخفاض بنسبة ~85% في المراجعات اليدوية بدقة 99%+، معرّفةً بأنها الموافقات الموصى بها من الوكيل التي وافق عليها المراجعون البشريون أيضاً، من تحليل داخلي مؤرخ 1/7/25 (Ramp). التسوية تأتي ثانياً لأن معدل المطابقة القابل للتحقيق يقع بأدنى بكثير من المُسوَّق ويحتاج إلى اختبار مدفوع على بياناتك (Numeric). التنبؤ يأتي لاحقاً: 44% من CFOs في شركات فوق مليار دولار يستخدمون بالفعل الذكاء الاصطناعي للتخطيط والميزانية (Deloitte Q2 2026 CFO Signals)، لكن مكاسب الدقة تتفاوت بشدة حسب القطاع، من 71% في البنوك إلى 44% في الرعاية الصحية (KPMG). ضيّق المجال قبل أن تشاهد أي عرض، إذ يضم دليلنا وحده 550 وكيل ذكاء اصطناعي وقليل جداً منها بُني للإغلاق المضبوط.