

لن يفشل خط أنابيب الوسائط المتعددة لديك بسبب هلوسة نموذج ما. سيفشل لأن رابط تنزيل Sora انتهت صلاحيته بعد 61 دقيقة من اكتمال التصيير، أو لأن بودكاست مدته 90 دقيقة اصطدم بـ حد التحويل الصوتي البالغ 25 ميغابايت لدى OpenAI بينما كان AssemblyAI سيقبل الملف الكامل بحجم 5 غيغابايت في طلب واحد.
لكل انتقال بين النماذج عقد محدد: تنسيق ملف دقيق، ومستوى خطة يتيح الوصول إليه، ونافذة انتهاء صلاحية، وبديل عند إيقاف المورد للنموذج. معظم الأدلة تتجاهل هذه الجوانب الأربعة كليًا.
هذا الدليل يمنحك العقود، وثلاثة خطوط أنابيب جاهزة، وخطة الاستبدال التي تحتاجها قبل أن يوقف OpenAI واجهة برمجة تطبيقات الفيديو ونموذجَي Sora 2 في 24 سبتمبر 2026 دون إعلان عن بديل. يتبقى 19 يومًا.
لماذا تفشل خطوط الأنابيب متعددة الوسائط عند نقاط الانتقال لا عند النماذج
كل نموذج في سلسلتك يعمل بشكل صحيح. التحويل دقيق، الصورة صحيحة، الصوت يبدو بشريًا، الفيديو يُصيَّر. ما ينهار هو اللحظة التي يجب فيها أن يصبح مخرج نموذج ما مدخلًا للنموذج التالي، ولم يكتب أحد كيف يبدو ذلك المخرج.
مثال ملموس: روابط تنزيل الأصول المُولَّدة من Sora تظل صالحة لمدة أقصاها ساعة واحدة بعد التوليد، ويصل المخرج على هيئة ملف MP4 مصحوبًا بصورة مصغرة WebP وصفحة بصرية JPG (OpenAI). إذا وضع خط الأنابيب لديك التصيير في قائمة الانتظار ووصل إلى خطوة النسخ بعد 90 دقيقة، فالتصيير قد اختفى. النموذج أدّى عمله بإتقان.
عقد الانتقال: التنسيق، والمستوى، والصلاحية، والبديل
تعامل مع كل انتقال باعتباره عقدًا من أربعة بنود تكتبها قبل بناء أي شيء.
التنسيق هو المواصفة الدقيقة للملف التي يتطلبها الانتقال التالي، وصولًا إلى معدل أخذ العينات وأبعاد البيكسل، لا مجرد نسبة عرض إلى ارتفاع وأمل. المستوى هو درجة الخطة أو معامل واجهة برمجة التطبيقات الوحيد الذي يتيح ذلك التنسيق، لأن كثيرًا من التنسيقات التي تحتاجها محجوبة خلف اشتراك مدفوع أو اسم نموذج قديم. الصلاحية هي المدة التي يبقى فيها الأصل قابلًا للاسترجاع من المورد قبل أن تتحمل الخسارة بنفسك. البديل هو ما تستبدله عندما يُوقف المورد النموذج، وهذا ليس افتراضيًا الآن.
اكتب هذه البنود الأربعة لكل انتقال وستختفي معظم مشكلات التنقيح قبل أن تبدأ.
أربعة أنماط فشل تقتل خط الأنابيب في منتصف التشغيل
- الانتقال الأعلى يُصدر تنسيقًا يخفّضه الانتقال الأدنى صامتًا أو يرفضه كليًا.
- ميزة افترضت وجودها في واجهة برمجة التطبيقات تبيّن أنها محجوبة خلف مستوى خطة أعلى أو إصدار نموذج أقدم.
- الأصل تنتهي صلاحيته في تخزين المورد بينما وظيفتك لا تزال في قائمة الانتظار.
- النموذج الذي بنيت عليه يحصل على تاريخ إيقاف، والمورد لا يذكر بديلًا موصى به.
خطوط الأنابيب الثلاثة التالية كلها تجسيد للعقد ذاته: البودكاست إلى ملاحظات العرض، والسيناريو إلى فيديو مُروى، وصورة المنتج إلى مجموعة حملة إعلانية. كل واحد منها يُسمّي التنسيق والمستوى والصلاحية والبديل في كل انتقال.
هذا مكتوب لمن يشحن منتجًا حقيقيًا، لا لمن يقارن بُنى الدمج. يمكنك اختيار الأدوات الفردية من 18,982 أداة ذكاء اصطناعي نشطة في دليلنا. توصيلها ببعض هو الجزء الذي لا يوثقه أحد.
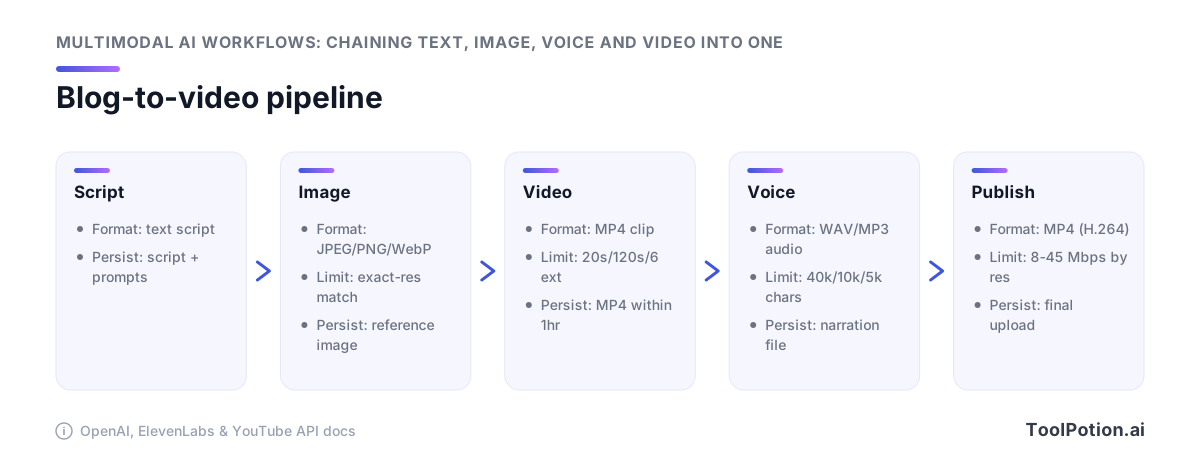
خط الأنابيب الأول: من مقالة مدوّنة إلى فيديو مُروى
لديك مقال من 1,200 كلمة وتريد الحصول على فيديو مُروى مدته دقيقتان. أربع خطوات: تقسيم النص، وتوليد الصور الثابتة، وتحريكها، والتعليق الصوتي عليها. لكل خطوة مواصفة يجب أن تستوفيها الخطوة السابقة، وتضع معظم هذه المواصفات قبل إجراء أي استدعاء لواجهة برمجة التطبيقات.
تجزئة السيناريو قبل أي استدعاء توليد
التجزئة ليست خطوة تنسيق تؤديها في النهاية. إنها المعامل الذي يرث منه كل شيء لاحق، لأن نموذج الصوت الذي تختاره يحدد سقف ما يمكنك إرساله في طلب واحد. يقبل Eleven Flash v2.5 حتى 40,000 حرف، وMultilingual v2 يقبل 10,000، وv3 يتوقف عند 5,000 (ElevenLabs). اختر v3 للتعليق الصوتي التعبيري وسيناريو 1,200 كلمة يناسب استدعاءً واحدًا. اختره لشرح من 9,000 كلمة وستجزّئ إلى قسمين مع فصل يجب إخفاؤه.
جزّئ على حدود المشاهد لا على عدد الجمل. كل مقطع يحتاج فكرة بصرية واحدة، ومدة مستهدفة بالثواني، ودقة بيكسل مستهدفة مرفقة كبيانات وصفية. هذا الحقل الأخير هو ما تقرأه خطوة الصورة.
خطوة الصورة: مطابقة أبعاد البيكسل الدقيقة لخطوة الفيديو
يتطلب مسار الصورة إلى الفيديو في Sora أن تطابق الصورة المرجعية دقة الفيديو المستهدفة تمامًا، وأن تكون بتنسيق image/jpeg أو image/png أو image/webp (OpenAI). التطابق يعني البيكسل لا "نسبة 16:9". مولّد الصور المطلوب منه إنتاج صورة ثابتة عريضة سيمنحك 1792x1024 بسعادة بينما استدعاء الفيديو يريد 1280x720، والوظيفة ستفشل عند الإرسال لا عند التصيير. لذلك يحمل قالب مُحفِّز الصورة العرضَ والارتفاعَ كأعداد صحيحة مجلوبة من إعدادات خطوة الفيديو، وتتحقق من أبعاد الملف المُعاد ونوع MIME قبل وضع أي شيء في قائمة الانتظار. من بين 324 نموذج ذكاء اصطناعي في دليلنا، تلك التي تتيح لك تحديد أبعاد البيكسل العشوائية بدلًا من إعدادات مسبقة مُسمّاة هي الجديرة بالربط هنا.
خطوة الفيديو: مقاطع من 16 و20 ثانية مُتسلسلة
يولّد كلٌّ من sora-2 وsora-2-pro مقاطع مدتها 16 أو 20 ثانية. تضيف كل امتداد ما يصل إلى 20 ثانية، بحد أقصى ستة امتدادات و120 ثانية إجمالًا (OpenAI). مقطعك الذي مدته دقيقتان يستلزم ستة استدعاءات متسلسلة.
الاستمرارية عبر هذه الستة هي مسؤوليتك. النموذج لا يتذكر القوس السردي بين الامتداد 3 والامتداد 4، لذا يجب على مُحفِّز كل استدعاء إعادة صياغة الإعداد والموضوع وحركة الكاميرا. خصّص ميزانية للمحاولات المتكررة عند مواضع الفصل.
خطوة الصوت والدمج
ولّد التعليق الصوتي لكل مقطع على حدة لا لكل فيديو، حتى لا تكلفك المحاولة الفاشلة سوى استدعاء واحد. ثم اضبط التزامن: يجب أن يناسب صوت المقطع 4 مقطع الفيديو المُصيَّر للمقطع 4 ذاته، وهذا يعني عادةً تقليص نص السيناريو لا تمطيط الصوت. ادمج باستخدام ffmpeg مقطعًا بمقطع، ثم ضمّها معًا.
خط الأنابيب الثاني: من حلقة بودكاست إلى مقاطع وملاحظات عرض
يدخل ملف WAV مدته 58 دقيقة. يخرج نص مكتوب، وفصول مُضمَّنة بالوقت، وستة مقاطع رأسية بعنوان مُحروق، وصفحة ملاحظات عرض. لا يتغير تنسيق الصوت بعد الخطوة الأولى، وهذا ما يجعل خط الأنابيب هذا أسهل من خط الفيديو. ما يحدد نجاحه هو مورد التحويل الصوتي الذي تختاره والمعاملات الثلاثة التي تضبطها على الطلب.
حاجز 25 ميغابايت وكيفية الالتفاف حوله
نقطة نهاية التحويل الصوتي لدى OpenAI تحدّ رفع الملفات بـ 25 ميغابايت وتقبل mp3 وmp4 وmpeg وmpga وm4a وwav وwebm (OpenAI). ملف WAV بتردد 48 كيلوهرتز ومدة 58 دقيقة يبلغ حجمه نحو 300 ميغابايت تقريبًا. إما أن تحوّله إلى MP3 ذي معدل بت منخفض على أمل نجاح ذلك، أو أن تقسّم الملف، وتقسيم الصوت عند حدود بايت عشوائية يبتر الكلمات ويُزحزح كل طابع زمني بعد موضع التقسيم.
AssemblyAI يقبل ما يصل إلى 5 غيغابايت لكل طلب على /v2/transcript (2.2 غيغابايت عند رفع الملفات المحلية عبر /v2/upload) ويتعامل مع أي شيء من 160 ميلي ثانية حتى 10 ساعات (AssemblyAI). هذا حوالي 200 ضعف الحد الأقصى. للصوت الطويل، أرسل الحلقة كاملة هناك واحتفظ بمورد نموذج اللغة لخطوات الاستنتاج لاحقًا.
الطوابع الزمنية على مستوى الكلمة هي الأداة الأساسية لتقطيع المقاطع
لا يمكنك تقطيع المقاطع تلقائيًا من نص لا تتوفر فيه سوى حدود الفقرات. تحتاج أن تعرف أن كلمة "على أي حال" تبدأ عند 00:41:12.340 حتى يقع القطع قبلها لا في منتصفها.
تحذيران على الجانب OpenAI. مخرجات SRT وVTT ومعامل timestamp_granularities[] لا تعمل إلا مع whisper-1 لا مع gpt-transcribe أو gpt-4o-transcribe (OpenAI). إذا كان خط أنابيبك يحرق التعليقات التوضيحية أو يقطع بالكود الزمني، فأبقِ النموذج الأقدم في السلسلة عن قصد وتوقف عن التعامل معه كدَيْن تقني. ElevenLabs Scribe v2 يمنحك طوابع زمنية على مستوى الكلمة وتحديد المتحدثين واكتشاف الكيانات عبر 90+ لغة في استجابة واحدة (ElevenLabs)، وهو الخيار الأنظف إذا كنت تدفع لهم أصلًا مقابل خطوة تحويل النص إلى كلام.
تحديد المتحدثين لا يعمل إلا عند طلبه صراحةً
تسميات المتحدثين تتطلب ضبط chunking_strategy على auto لأي صوت أطول من 30 ثانية، وgpt-4o-transcribe-diarize يقوم بتحديد هوية المتحدث فقط (OpenAI). أغفل المعامل والطلب سينجح. ستحصل على نص سلس نظيف بلا تسميات إطلاقًا، ولن يُخبرك شيء في الاستجابة أن مقابلة ثنائية المذيعين انهارت في صوت واحد. افحص حقول المتحدثين في خطوة التحقق، لا بالعين المجردة.
من النص إلى ملاحظات العرض والفصول ونصوص التواصل الاجتماعي
نص واحد مع توقيت الكلمات يتفرع إلى أربعة أصول دون أي معالجة صوتية إضافية: علامات الفصول من التحولات الموضوعية، وفقرة ملخص مع قائمة روابط لصفحة ملاحظات العرض، ومرشحو المقاطع المصنّفون بحسب كثافة الاقتباسات، والقطعات الرأسية ذاتها مُصيَّرة من نقاط الدخول والخروج تلك. أرسل النص ذاته إلى كل منها، بالتوازي، مع مُحفِّزات مختلفة. إذا كنت تبحث عن مراجع للتنسيق قبل البناء، هناك 201 بودكاست ذكاء اصطناعي في دليلنا تنشر على هذه المجموعة التقنية تقريبًا.
خط الأنابيب الثالث: من صور المنتج إلى متغيرات الإعلانات
صورة استوديو واحدة لحذاء تتحول إلى اثنتي عشرة صورة ثابتة على العلامة التجارية، ثم أربعة إعلانات متحركة مدتها 8 ثوانٍ للتواصل الاجتماعي المدفوع. الخطوات هي: صورة داخل، صورة خارج، فيديو خارج، والهندسة الرائعة تقع بين الخطوتين الثانية والثالثة، حيث ينظر نموذج رؤية إلى ما أنتجه مولّد الصور ويقرر ما إذا كان يصلح للإرسال.
مراجعة نموذج الرؤية كبوابة ضمان جودة
صور المنتجات المُولَّدة تفشل بطرق مملة. موضع الشعار خاطئ، ستة حلقات بدلًا من خمسة، ظل يتعارض مع ضوء المفتاح. لا تريد إنسانًا يدقق 120 متغيرًا، لذا ترسلها إلى نموذج رؤية مع الصورة الأصلية ومواصفة العلامة التجارية المكتوبة، وتطلب حكمًا بالنجاح أو الفشل مع سلسلة سبب.
Claude يقبل ما يصل إلى 100 صورة لكل طلب على النماذج ذات السياق 200 ألف رمز، و600 على النماذج الأخرى، بحد أقصى 20 لكل رسالة على claude.ai، وبسقف 8000x8000 بيكسل و10 ميغابايت لكل صورة (Claude Docs). هذه ليست الأرقام التي ستُعيقك.
حد حجم الطلب القياسي البالغ 32 ميغابايت هو ما سيعيقك. اثنا عشر ملف PNG بدقة 4K سيتجاوزونه قبل أن تقترب من 100 صورة، ولهذا يوصي Anthropic برفع الصور عبر Files API والإشارة إلى كل صورة بـ file_id بدلًا من تضمين base64 (Claude Docs). ابنِ خطوة المراجعة بهذه الطريقة من اليوم الأول. إعادة تجهيزها بعد نمو أحجام الدُفعات يعني إعادة كتابة منشئ الطلبات ومنطق المحاولة المتكررة معًا.
أخذ عينات الإطارات هو رافعة تحكم مباشر في التكلفة
Claude يُحاسب الصور كرموز بصرية بحجم 28x28 بيكسل، تُحسب بالمعادلة ⌈width/28⌉ × ⌈height/28⌉. إطار 3840x2160 يكلف 4,784 رمزًا بصريًا على المستوى عالي الدقة و1,560 بعد خفض الدقة على المستوى القياسي، أي حوالي $23.92 لكل ألف إطار بدقة 4K بسعر إدخال Claude Opus 5 البالغ $5 لكل مليون رمز (Claude Docs). اخفض الدقة قبل الإرسال، إلا إذا كان فحص ضمان الجودة يعتمد على التفاصيل الدقيقة كالخياطة أو النص الصغير.
الحساب ذاته ينطبق على خطوة تحليل الفيديو. مراجعة أربعة إعلانات مدتها 8 ثوانٍ بمعدل 24 إطار/ثانية تعطيك 768 إطارًا إذا تصرفت بشكل ساذج. خذ عينات بمعدل إطارين/ثانية، افحص 64 إطارًا، وفاتورة المراجعة لديك ستنخفض بعامل اثني عشر دون فقدان أي تغيير مشهدي.
دفع الصور على دُفعات دون الاصطدام بسقف الطلب
جزّئ حسب بايتات الحمولة لا حسب عدد الصور. رتّب المتغيرات في مجموعات تبقى تحت نحو 25 ميغابايت من المراجع، أبقِ الصورة الأصلية في كل دُفعة كمرجع مقارنة، وأعد إرسال حالات الفشل منفردةً بالدقة الكاملة حتى تكون سلسلة السبب ذات قيمة للقراءة. يُدرج دليلنا 727 مولّد صور و342 محرر صور ضمن أدوات الصور والصور بالذكاء الاصطناعي في دليلنا، وكاد لا أحد منها يكشف آليات الدُفعات التي تحتاجها هنا. ذلك الجزء يبقى في كودك أنت.
جدول مواصفات التسليم: ما تطلبه عند كل خطوة انتقال
اكتب العقد قبل أن تكتب الكود. كل خطوة انتقال في السلسلة لها ثلاثة أشياء تحتاج تثبيتها: التنسيق الدقيق للمخرج الذي تطلبه، ومستوى الخطة أو المعامل الذي يتيحه، ومدة بقاء الأصل قبل اختفائه. أخطأ فيها وسيظهر الفشل بعد خطوتين كشكوى جودة لا يستطيع أحد تتبعها.
الصوت: المستوى الذي يُتيح مخرجات بجودة البث
ElevenLabs يضع pcm_44100 وpcm_48000 وwav_44100 وwav_48000 خلف اشتراك Pro، وmp3_44100_192 خلف مستوى Creator (ElevenLabs API reference). على الخطة المجانية أو خطة الدخول، سيتلقى محرر الفيديو لديك MP3 مضغوطًا بمعدل 128 كيلوبت/ثانية أو أقل بغض النظر عن جودة نموذج الصوت. هذا سقف جودة تحدده الفوترة لا الاستنتاج.
إذا كانت نتيجتك النهائية بودكاست يحتاج الوصول إلى -16 LKFS مع ذروة حقيقية عند -1 dBFS أو أقل (Apple Podcasts)، فأنت تريد صوتًا غير مضغوط للإدخال وترميزًا واحدًا في النهاية. تطبيع MP3 بمعدل 128 كيلوبت/ثانية وإعادة ترميزه يكدّس جيلين من الخسارة. خصّص مستوى Pro كتكلفة إنتاج لا كترقية.
الفيديو: الروابط منتهية الصلاحية وملفات الإرفاق
Sora لا يمنحك ملفًا واحدًا. التصيير المكتمل يعطيك ملف MP4 وصورة مصغرة WebP وصفحة بصرية JPG، وروابط التنزيل تبقى صالحة لمدة أقصاها ساعة واحدة (OpenAI video guide). وظيفتك عند تلك الخطوة هي نسخ إلى مخزن الكائنات الخاص بك، مُشغَّلة بحدث الاكتمال لا بدُفعة ليلية. افوّت النافذة والتصيير لا يمكن استرداده.
النص والتوقيت: الحقول التي تتطلبها الخطوات اللاحقة
الخطوات اللاحقة تتطلب حقولًا محددة بصرامة، وتلك التي تحتاج التوقيت هي التي تفشل صامتةً. مخرجات SRT وVTT ومعامل timestamp_granularities[] لا تعمل إلا مع whisper-1 لا مع نماذج التحويل الأحدث (OpenAI speech to text). أي شيء يقطع مقاطع أو يحرق تعليقات توضيحية يحتاج طوابع زمنية على مستوى الكلمة في العقد.
| الخطوة | اطلب هذا المخرج | ما الذي يتيحه | الصلاحية |
|---|---|---|---|
| نص إلى كلام | wav_48000 أو pcm_44100 | مستوى Pro؛ Creator لـ mp3_44100_192 | لا انتهاء صلاحية، احفظ عند الكتابة |
| كلام إلى نص | طوابع زمنية على مستوى الكلمة، تسميات المتحدثين | whisper-1 للـ SRT/VTT؛ chunking_strategy: auto فوق 30 ثانية للفرز بالمتحدث | لا انتهاء صلاحية |
| صورة إلى فيديو | MP4 مع صورة مصغرة وصفحة بصرية | صورة مرجعية تطابق دقة الفيديو تمامًا | ساعة واحدة على روابط التنزيل |
| فيديو إلى نص | إطارات بأخذ عينات بمعدل ثابت | المستوى القياسي مقابل عالي الدقة يغير تكلفة الرمز البصري ~3x | لا انتهاء صلاحية |
أيًا كان المُنسِّق الذي تختاره من 128 إطار عمل للذكاء الاصطناعي في دليلنا، اختبره أولًا على الخطوات الثنائية. تمرير JSON بين النماذج هو الجزء السهل.
منصة الأتمتة أم الصمغ اليدوي
القاعدة بسيطة: دع المنصة تقرر ما يحدث ومتى، ودع كودك الخاص ينقل البايتات. أي شيء يلمس ملفًا كبيرًا أو يسابق نافذة انتهاء صلاحية يجب أن يكون في سكريبت تقف وراءه مساحة تخزين كائنات.
أين تتفوق المنصة
المحفزات، والمحاولات المتكررة على الخطوات الرخيصة، وبوابات الموافقة، والتشعب في النهاية. Zapier يُقدّم أكثر من 9,000 تكامل تطبيق مدمجة في Zaps وTables وForms وZapier MCP، وهذا الكتالوج هو السبب الحقيقي لاستخدامه. إيصال ملاحظات العرض المنتهية إلى نظام إدارة المحتوى ورابط المقاطع إلى تقويم المحتوى هو عمل موصّلات، وكتابة تلك الموصّلات بنفسك لا يجلب لك شيئًا.
التدخل البشري في الحلقة ينتمي هنا أيضًا. Zap ينشر أربعة متغيرات إعلانية في Slack، ينتظر إبهامًا لأعلى، ثم يُصدر خطوة النشر هو عشرون دقيقة من الإعداد والشيء الوحيد الفاصل بين ادعاء منتج مهلوس وميزانيتك الإعلانية المدفوعة.
أين يهزمها الوسائط الثنائية
عقد بدون كود تمرر JSON جيدًا والملفات بشكل سيئ. ملف WAV مدته 58 دقيقة يجب تقسيمه إلى أجزاء بحجم 25 ميغابايت أو أقل قبل أن تقبله نقطة نهاية التحويل الصوتي لدى OpenAI (OpenAI). تصيير Sora مدته دقيقتان يستلزم ما يصل إلى ستة استدعاءات امتداد متسلسلة بمعدل 20 ثانية لكل منها (OpenAI)، ورابط التنزيل صالح لمدة أقصاها ساعة واحدة بعد التوليد (OpenAI). منطق إعادة المحاولة عبر ستة استدعاءات مع عداد تنازلي يعمل على الأصل هو برنامج لا لوحة رسم.
منصتان تتعاملان مع الوسائط فعلًا. n8n تحتفظ بالملفات كبيانات ثنائية بين العقد بدلًا من إجبارك على رحلات base64 ذهابًا وإيابًا، وعقدة الكود تجلس مباشرةً بجوار عقد الوكيل (n8n). Descript يكشف التحويل الصوتي والمقاطع والتعليقات التوضيحية عبر واجهة برمجة تطبيقات لا عبر واجهة رسومية (Descript).
المسار الوسط: المنصة للتحكم في التدفق، والكود للبايتات
كل خطوة تكتب إلى دلوك الخاص وتعيد مفتاحًا. المنصة تمرر المفاتيح ورموز الحالة لا الملف. تنظيم العمل بهذه الطريقة يخفض الحوسبة أيضًا: يُفيد نظام OnePiece بانخفاض 16 ضعفًا في استهلاك GPU لـ Wan2.1 لتحويل الصورة إلى فيديو بمجرد تحليل خط الأنابيب الأحادي البنية إلى خدمات مرحلية (arXiv).
إذا كنت تختار مكونات، يتتبع دليلنا 550 وكيل ذكاء اصطناعي وأداة تنسيق إلى جانب 301 مستودع ذكاء اصطناعي مفتوح المصدر. المستودعات هي المكان الذي يعيش فيه عادةً الصمغ المنقول للبايتات، لأن لا أحد يبيع ذلك الجزء.
مواصفات التسليم: مقابلة المنصة حيث تنشر
خطوتك الأخيرة ليست التصيير. إنها الرفع، وللرفع جدول مواصفاته الخاص.
الفيديو: أهداف معدل البت والصوت للرفع
YouTube ينشر معدلات تسليم موصى بها حسب الدقة: 8 ميغابت/ثانية لـ 1080p SDR، و16 ميغابت/ثانية عند 1440p، و35–45 ميغابت/ثانية عند 4K، مع صوت مُسلَّم بتنسيق AAC-LC أو Opus أو Eclipsa بتردد 48 كيلوهرتز ومعدل 384 كيلوبت/ثانية استيريو (YouTube Help). إذا سلّمتك خطوة الفيديو ملفًا بأرقام أقل بكثير من تلك، لا ترفع معدل البت عند التصدير. ستُنفق وقت الترميز على حشو تشوهات الضغط. ما يجب فعله هو جعل خطوة الترميز تقرأ دقة المصدر وتختار الهدف المطابق، حتى لا يُجبَر تصيير Sora بدقة 1080p على سلّم 4K لأن أحدهم رمّزه في إعداد قبل ستة أشهر.
هدف الصوت أهم من هدف الفيديو للمحتوى المُروى. مسار AAC بمعدل 384 كيلوبت/ثانية وتردد 48 كيلوهرتز من مصدر 44.1 كيلوهرتز يعني إعادة أخذ عينات في مكان ما، وتريد أن تحدث تلك العملية مرة واحدة في استدعاء ffmpeg الخاص بك حيث يمكنك رؤيتها.
الصوت: تكييف مستوى الصوت قبل الترميز
Apple Podcasts تطلب -16 dB LKFS ±1 dB مع ذروة حقيقية عند -1 dB FS أو أقل، مقيسة وفق ITU-R BS.1770-5، وتوضح صراحةً أن الصوت يجب تكييفه لهذا الهدف قبل الترميز (Apple Podcasts for Creators). ترتيب العمليات لا تفضيل. تطبيع MP3 منتهٍ يعني دفع مستوى الصوت عبر مشوهات مضغوطة خُبزت عند مستوى مختلف، وقد تتجاوز الذروة الحقيقية لـ MP3 المفكوك ما رآه المُشفِّر أصلًا. ضع مرحلة الصوت على ملف WAV ثم شفّره.
هذا هو السبب في أن مستوى تنسيق TTS من وقت سابق في السلسلة يظل مهمًا. تسليم مُطبِّعك MP3 بمعدل 128 كيلوبت/ثانية نقطة بداية أسوأ من تسليمه PCM، ولا تُصلح العناية اللاحقة ذلك أبدًا.
مصدر الأصول المُولَّدة وتسميتها
قرر الإسناد بينما تصمم خط الأنابيب لا بعد أن تسأل عنه منصة ما. SynthID من Google يضع علامة مائية على الوسائط المُولَّدة وقت الإنشاء، وهذا يعني أنها تنتقل مع الأصل فقط إذا لم يُجرِّد خط أنابيبك العلامة المائية أو يُعيد ترميزها. كل مرور عبر ffmpeg بين التوليد والرفع فرصة لفقدان تلك الإشارة، لذا تتبع الخطوة التي أدخلت الملف واحتفظ بسجل للنموذج والمُحفِّز والطابع الزمني في مخزن البيانات الوصفية الخاص بك بدلًا من الثقة بالحاوية لحمله.
ابنِ من أجل الاستبدال: حافة الإيقاف تحت كل خطوة فيديو
إذا كانت خطوة الفيديو لديك تستدعي Sora، فلديك 19 يومًا. أعلن OpenAI في 24 مارس 2026 أن واجهة برمجة تطبيقات الفيديو ونموذجَي sora-2 وsora-2-pro سيُوقَفان في 24 سبتمبر 2026، بما في ذلك اللقطات sora-2-2025-10-06 وsora-2-2025-12-08 وsora-2-pro-2025-10-06، دون ذكر نموذج بديل موصى به (OpenAI deprecations). عمود الاستبدال الفارغ يعني أنك تختار الخلف بنفسك، وتختاره قبل الموعد لا بعده.
تجريد الخطوة حتى يكون الاستبدال مجرد تغيير إعداد
الحل هو محوّل رفيع لكل خطوة توليدية. خط أنابيبك يسلّم المحوّل وظيفة موحّدة المعايير: المُحفِّز، ومسار الصورة المرجعية، والدقة المستهدفة، والمدة بالثواني، ومفتاح دلو المخرج. المحوّل يمتلك كل شيء ذو شكل خاص بالمورد. قاعدة Sora التي تشترط تطابق الصورة المرجعية مع دقة الفيديو تمامًا، ومقاطعها من 16 و20 ثانية مُمتدة بخطوات 20 ثانية إلى سقف 120 ثانية، وانتهاء صلاحية تنزيلها بعد ساعة (OpenAI video generation). لا شيء من ذلك يتسرب إلى كود التنسيق لديك.
عندئذٍ يصبح تبديل الموردين قيمة إعداد لا إعادة كتابة. تحقق من صحة محوّل ثانٍ وفق وثائق نماذج Runway الآن، شغّل كليهما على نفس العشرة مُحفِّزات، واحتفظ بالخاسر جاهزًا.
عائلات الصور والصوت تحمل تواريخها الخاصة، لذا تعامل مع هذا كصيانة دورية لا اندفاعة لمرة واحدة. يوجد دليلنا جزئيًا لتمكينك من تتبع إصدارات النماذج وإيقافاتها عبر 324 نموذجًا مُدرجًا.
قائمة مراجعة ترحيل خطوط الأنابيب الجارية اليوم
- ابحث في كل مستودع وملف JSON للسير في كل مستودع ومسارات العمل عن
sora-2وsora-2-proومسار Videos API الأساسي. اشمل وظائف cron والسكريبتات الفردية، وهي المكان الذي تعيش فيه الاستدعاءات المنسية. - لفّ كل تطابق في محوّل مع مخطط الوظيفة الخاص بك قبل تغيير الموردين، حتى لا يكون الاستبدال وإعادة الهيكلة في نفس الالتزام.
- شغّل المورد البديل على عشرة مُحفِّزات حقيقية وقارن المخرجات على الدقة وطول المقطع وجودة الحركة.
- اضبط تذكيرًا في التقويم بأسبوعين قبل كل تاريخ إيقاف منشور، لكل مورد ولكل عائلة نماذج.
- سجّل معرّف النموذج واللقطة على كل تصيير حتى تتمكن من الإجابة على "ماذا ولّد هذا الأصل" بعد اختفاء النموذج.
الأسئلة الشائعة
ما هو سير العمل متعدد الوسائط بالذكاء الاصطناعي من الناحية العملية؟
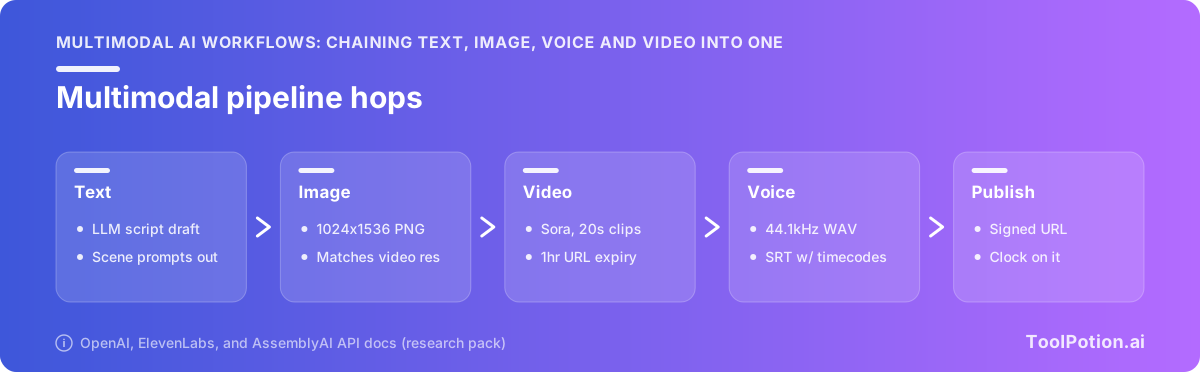
إنه سلسلة استدعاءات لواجهة برمجة التطبيقات حيث يصبح ملف مخرج نموذج ما ملف مدخل النموذج التالي، ولكل خطوة انتقال عقد تنسيق يجب الوفاء به. سلسلة نموذجية تسير كما يلي: نص مُحوَّل إلى سيناريو، إلى صورة ثابتة، إلى فيديو، إلى تعليق صوتي، إلى تصيير نهائي، وكل سهم هو موضع يمكن أن يكسر دقة خاطئة أو كودك للتشغيل. مسار Sora من الصورة إلى الفيديو مثال جيد على مدى حرفية تلك العقود: يجب أن تطابق الصورة المرجعية دقة الفيديو المستهدفة تمامًا وأن تكون image/jpeg أو image/png أو image/webp، لذلك تحتاج خطوة الصورة الأعلى إلى أبعاد البيكسل لخطوة الفيديو لا مجرد نسبة عرض إلى ارتفاع (OpenAI video generation docs). فكّر في خط الأنابيب كمجموعة تسليمات لا مجموعة أدوات.
كيف أربط أدوات الذكاء الاصطناعي معًا دون فقدان الجودة بين الخطوات؟
ثبّت مواصفة المخرج عند كل خطوة انتقال بما يحتاجه آخر خطوة في السلسلة، ثم اعمل للخلف. فقدان الجودة يأتي عادةً من مستوى تسعير أو معامل افتراضي لا من النموذج: ElevenLabs يضع pcm_44100 وpcm_48000 وwav_44100 وwav_48000 خلف اشتراك Pro وmp3_44100_192 خلف مستوى Creator، لذا حساب المستوى الأدنى يسلّم محررك MP3 مضغوطًا سواء أردت ذلك أم لا (ElevenLabs create speech reference). انسخ كل أصل مُولَّد فورًا إلى مخزن الكائنات الخاص بك، لأن روابط التنزيل من Sora صالحة لمدة أقصاها ساعة واحدة بعد التوليد (OpenAI video generation docs). معدل أخذ العينات أيضًا رافعة للتكلفة لا للجودة فقط: Claude يُسعّر إطار 4K بـ 4,784 رمزًا بصريًا على المستوى عالي الدقة مقابل 1,560 على المستوى القياسي، بما يعادل نحو $23.92 لكل ألف إطار بدقة 4K بسعر Opus 5 البالغ $5 لكل مليون رمز (Claude vision docs).
ما تنسيق الصوت الذي يجب تسليمه من خطوة تحويل النص إلى كلام إلى محرر الفيديو؟
WAV غير مضغوط بتردد 48 كيلوهرتز أو PCM، وهذا على ElevenLabs يعني wav_48000 أو pcm_48000 واشتراك Pro أو أعلى (ElevenLabs create speech reference). تسليم المحرر MP3 بمعدل 128 كيلوبت/ثانية يُخبز فيه مشوهات الضغط التي تنجو من كل ترميز لاحق. إذا كان الهدف YouTube، فهدف التسليم النهائي هو AAC-LC أو Opus أو Eclipsa بتردد 48 كيلوهرتز ومعدل 384 كيلوبت/ثانية استيريو (YouTube upload encoding settings)، وإذا كان خلاصة بودكاست، فـ Apple تريد تكييف مستوى الصوت إلى -16 dB LKFS ±1 dB مع ذروة حقيقية عند -1 dB FS أو أقل، مقيسة وفق ITU-R BS.1770-5، قبل الترميز (Apple Podcasts audio requirements). لا يمكنك الوصول إلى أي من الهدفين بشكل موثوق من وسيط مضغوط.
لماذا يفشل تحويل البودكاست إلى نص على الحلقات الكاملة؟
نقطة نهاية التحويل الصوتي لدى OpenAI تحدّ رفع الملفات بـ 25 ميغابايت وتقبل mp3 وmp4 وmpeg وmpga وm4a وwav وwebm، لذا يجب تقسيم أي شيء أطول من نحو نصف ساعة بمعدل بت معقول إلى أجزاء بحجم 25 ميغابايت أو أقل (OpenAI speech-to-text docs). لهذا تُوجّه خطوط الأنابيب الطويلة عادةً التحويل الصوتي بعيدًا عن مورد نموذج اللغة: AssemblyAI يقبل ما يصل إلى 5 غيغابايت لكل طلب على /v2/transcript (2.2 غيغابايت للرفع المحلي) وملفات من 160 ميلي ثانية إلى 10 ساعات، أي نحو 200 ضعف حد OpenAI (AssemblyAI pre-recorded audio docs). نمطا فشل آخران يبدوان كنجاح: تحديد المتحدثين يعيد نصًا غير مُسمَّى صامتًا إلا إذا ضبطت chunking_strategy على 'auto' للصوت الأطول من 30 ثانية، ومخرجات SRT/VTT ومعامل timestamp_granularities[] لا يعملان إلا مع whisper-1 لا مع gpt-transcribe أو gpt-4o-transcribe (OpenAI speech-to-text docs). إذا احتجت طوابع زمنية على مستوى الكلمة لتقطيع المقاطع الآلي، فـ ElevenLabs Scribe v2 يمنحها عبر 90+ لغة إلى جانب تحديد المتحدثين (ElevenLabs models).
هل يجب بناء خط أنابيب محتوى الذكاء الاصطناعي في n8n أو Zapier أم كتابة الكود بنفسي؟
اكتب كودًا لأي خطوة تنقل وسائط ثنائية، واستخدم منصة أتمتة للمحفزات والموافقات والإشعارات حولها. نقطة قوة Zapier هي الاتساع، مع 9,000+ تكامل تطبيق مُعلن عنه من المورد بالإضافة إلى Zaps وTables وForms وZapier MCP (Zapier developer platform)، وهذا بالضبط ما تريده لـ "صف جديد في Airtable، ابدأ التصيير، انشر الرابط على Slack." إنه الطبقة الخاطئة لملف MP4 حجمه 200 ميغابايت برابط ينتهي خلال ساعة. n8n يقع في المنتصف، إذ تتيح عقد الوكلاء ومعالجة التمرير الثنائي فيه الاحتفاظ بالملفات داخل سير العمل (n8n Tools Agent docs)، وهناك حجة بنية تحتية حقيقية لتقسيم السلسلة إلى مراحل بدلًا من كتلة أحادية: تُفيد ورقة OnePiece بانخفاض 16 ضعفًا في استهلاك GPU من تحليل خط أنابيب AIGC إلى خدمات مصغّرة مرحلية لتحويل الصورة إلى فيديو Wan2.1 (arXiv).
ما الذي يحل محل Sora في خط أنابيب الفيديو بعد إيقاف سبتمبر 2026؟
أعلن OpenAI في 24 مارس 2026 أن واجهة برمجة تطبيقات الفيديو ونموذجَي sora-2 وsora-2-pro (اللقطات sora-2-2025-10-06 وsora-2-2025-12-08 وsora-2-pro-2025-10-06) ستُوقَف في 24 سبتمبر 2026، ولا يُدرج أي نموذج بديل موصى به (OpenAI deprecations). اعتبارًا من 5 سبتمبر 2026 يتبقى 19 يومًا، لذا الخطوة العملية هي وضع خطوة الفيديو خلف واجهة رفيعة اليوم وتوجيهها إلى مورد آخر، مع واجهة برمجة تطبيقات Runway كأبرز بديل للتقييم (Runway models docs). خصّص ميزانية أيضًا لإعادة كتابة منطق التجزئة، إذ شكّلت حدود Sora كثيرًا من خطوط الأنابيب: مقاطع من 16 و20 ثانية، وما يصل إلى 20 ثانية مضافة لكل امتداد، وحد أقصى 120 ثانية عبر ستة امتدادات، مما جعل مقطعًا مُروى مدته دقيقتان ستة استدعاءات متسلسلة (OpenAI video generation docs). إذا كنت تتسوق بدائل، يتتبع دليلنا حاليًا 452 أداة تحت فئة مولّدات الفيديو بالذكاء الاصطناعي.