

في إحدى تجارب مهندسي Anthropic، ترك الفريق وكيلًا رئيسيًا يوزّع تعليمات قصيرة على الوكلاء الفرعيين، مثل «ابحث في أزمة أشباه الموصلات». أساء الوكلاء الفرعيون فهمها: استكشف أحدهم أزمة الرقائق في قطاع السيارات عام 2021، بينما كرّر اثنان آخران العمل نفسه على سلاسل الإمداد في 2025 (Anthropic Engineering). لم ينهَر شيء. كل وكيل فعل شيئًا معقولًا مع طلب غامض يحتمل أكثر من قراءة.
نكرر أغلبنا هذا الخطأ كلما سلّمنا عملًا إلى ChatGPT أو Claude أو Gemini CLI أو أحد وكلاء البرمجة في الطرفية. نكتب مهمة ونسمّيها تعليمات. في هذا المقال: ستة أجزاء لا بد منها في أي تعليمات، وثلاث إعادات صياغة يمكنك الاستعانة بها، وقالب، وجدول بأسباب فشل التعليمات. وهذه مواقفنا التي نحاجّ عنها على امتداد المقال: اكتب سطر «الإنجاز عندما» أولًا، واستبدل عبارة «اسألني إن لم تكن متأكدًا» بقائمة محددة من الإجراءات، واحذف جدران الحروف الكبيرة. وثائق الشركات التي نقتبس منها تؤيد بعض هذا ولا تتناول الباقي، وسنوضح أيّ ذلك أيّ.
المهمة ليست تعليمات
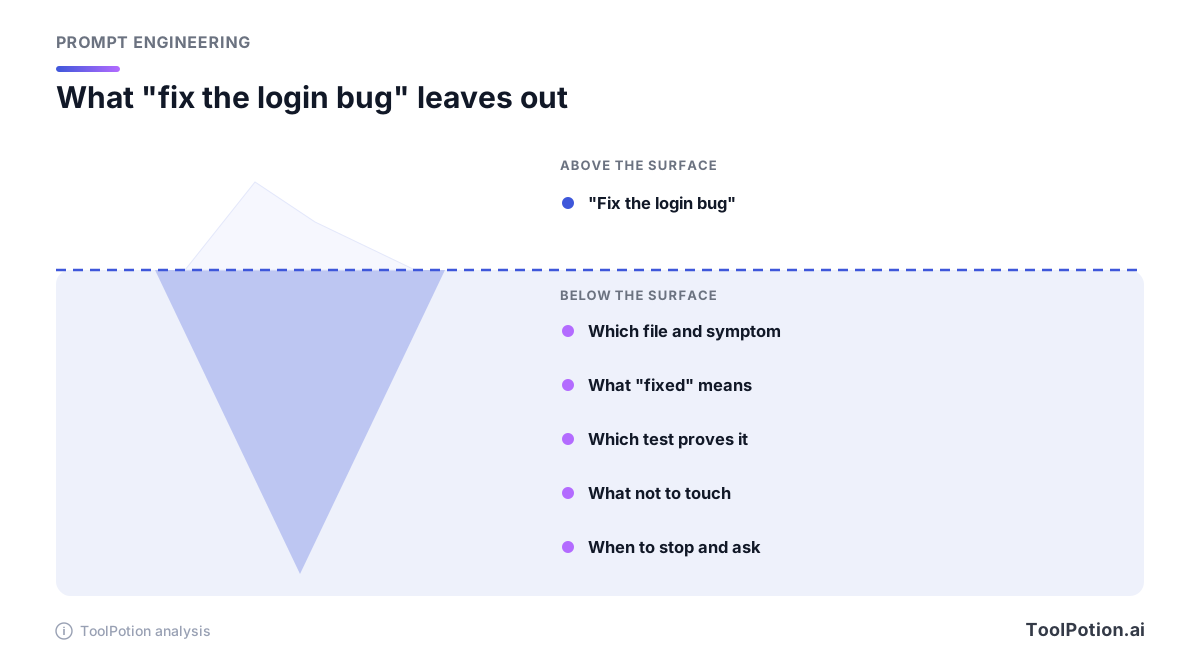
المهمة تسمّي نشاطًا. أما التعليمات فتعطي من ينفّذ العمل كل ما سيضطر لولاها إلى تخمينه. يصوغها دليل Anthropic للـ prompts على هيئة موظف جديد: «تخيّل Claude موظفًا جديدًا لامعًا لكنه لا يعرف سياق عملكم وأعرافه.» (Anthropic docs) وترسم OpenAI فرقًا مشابهًا بين أنواع النماذج. فنموذج الاستدلال «مثل زميل عمل كبير» يستطيع أن يأخذ هدفًا ويتدبّر التفاصيل بنفسه، أما نموذج GPT فهو «مثل زميل مبتدئ» يؤدي أفضل ما عنده «مع تعليمات صريحة لإنتاج مخرَج محدد» (OpenAI docs).
تقول OpenAI إن نماذج الاستدلال تتعامل جيدًا مع التوجيه العام، ونحن لا نذهب إلى هذا الحد في الثقة به حين يمتد العمل عشرات الخطوات وتترتب عليه آثار جانبية. فالزميل الكبير لا يعرف أيضًا ما تعنيه أنت بكلمة «انتهى»، وتخمين المبتدئ الخاطئ يكلّف رسالة بريد واحدة. أما الوكيل فيبني على سوء فهمه الأول في كل خطوة تليه، كما أظهر الوكيل الرئيسي في تجربة Anthropic.
تقترح Anthropic اختبارًا يعجبنا لأنه لا يستغرق سوى دقيقتين: «اعرض الـ prompt على زميل لا يعرف إلا القليل عن المهمة واطلب منه تنفيذه. إن ارتبك فسيرتبك Claude أيضًا.» (Anthropic docs) فإن كان مقاول لا يستطيع البدء من رسالتك دون أن يرسل لك خمسة أسئلة، فالوكيل سيجيب عن تلك الأسئلة الخمسة بنفسه وبصمت، ولن تعرف إلا من النتيجة.
اكتب سطر «الإنجاز عندما» قبل أي شيء آخر
تقولها صفحة أفضل الممارسات في Claude Code صراحة: «يتوقف Claude حين يبدو العمل منجزًا.» وإن لم يكن هناك ما يمكن تشغيله ليخبرك هل أُنجز العمل فعلًا، تتابع الصفحة: «عمليًا يجعلك ذلك أنت مجموعة الاختبارات، وكل خطأ يبقى في مكانه حتى تلاحظه بالمصادفة.» (Claude Code docs)
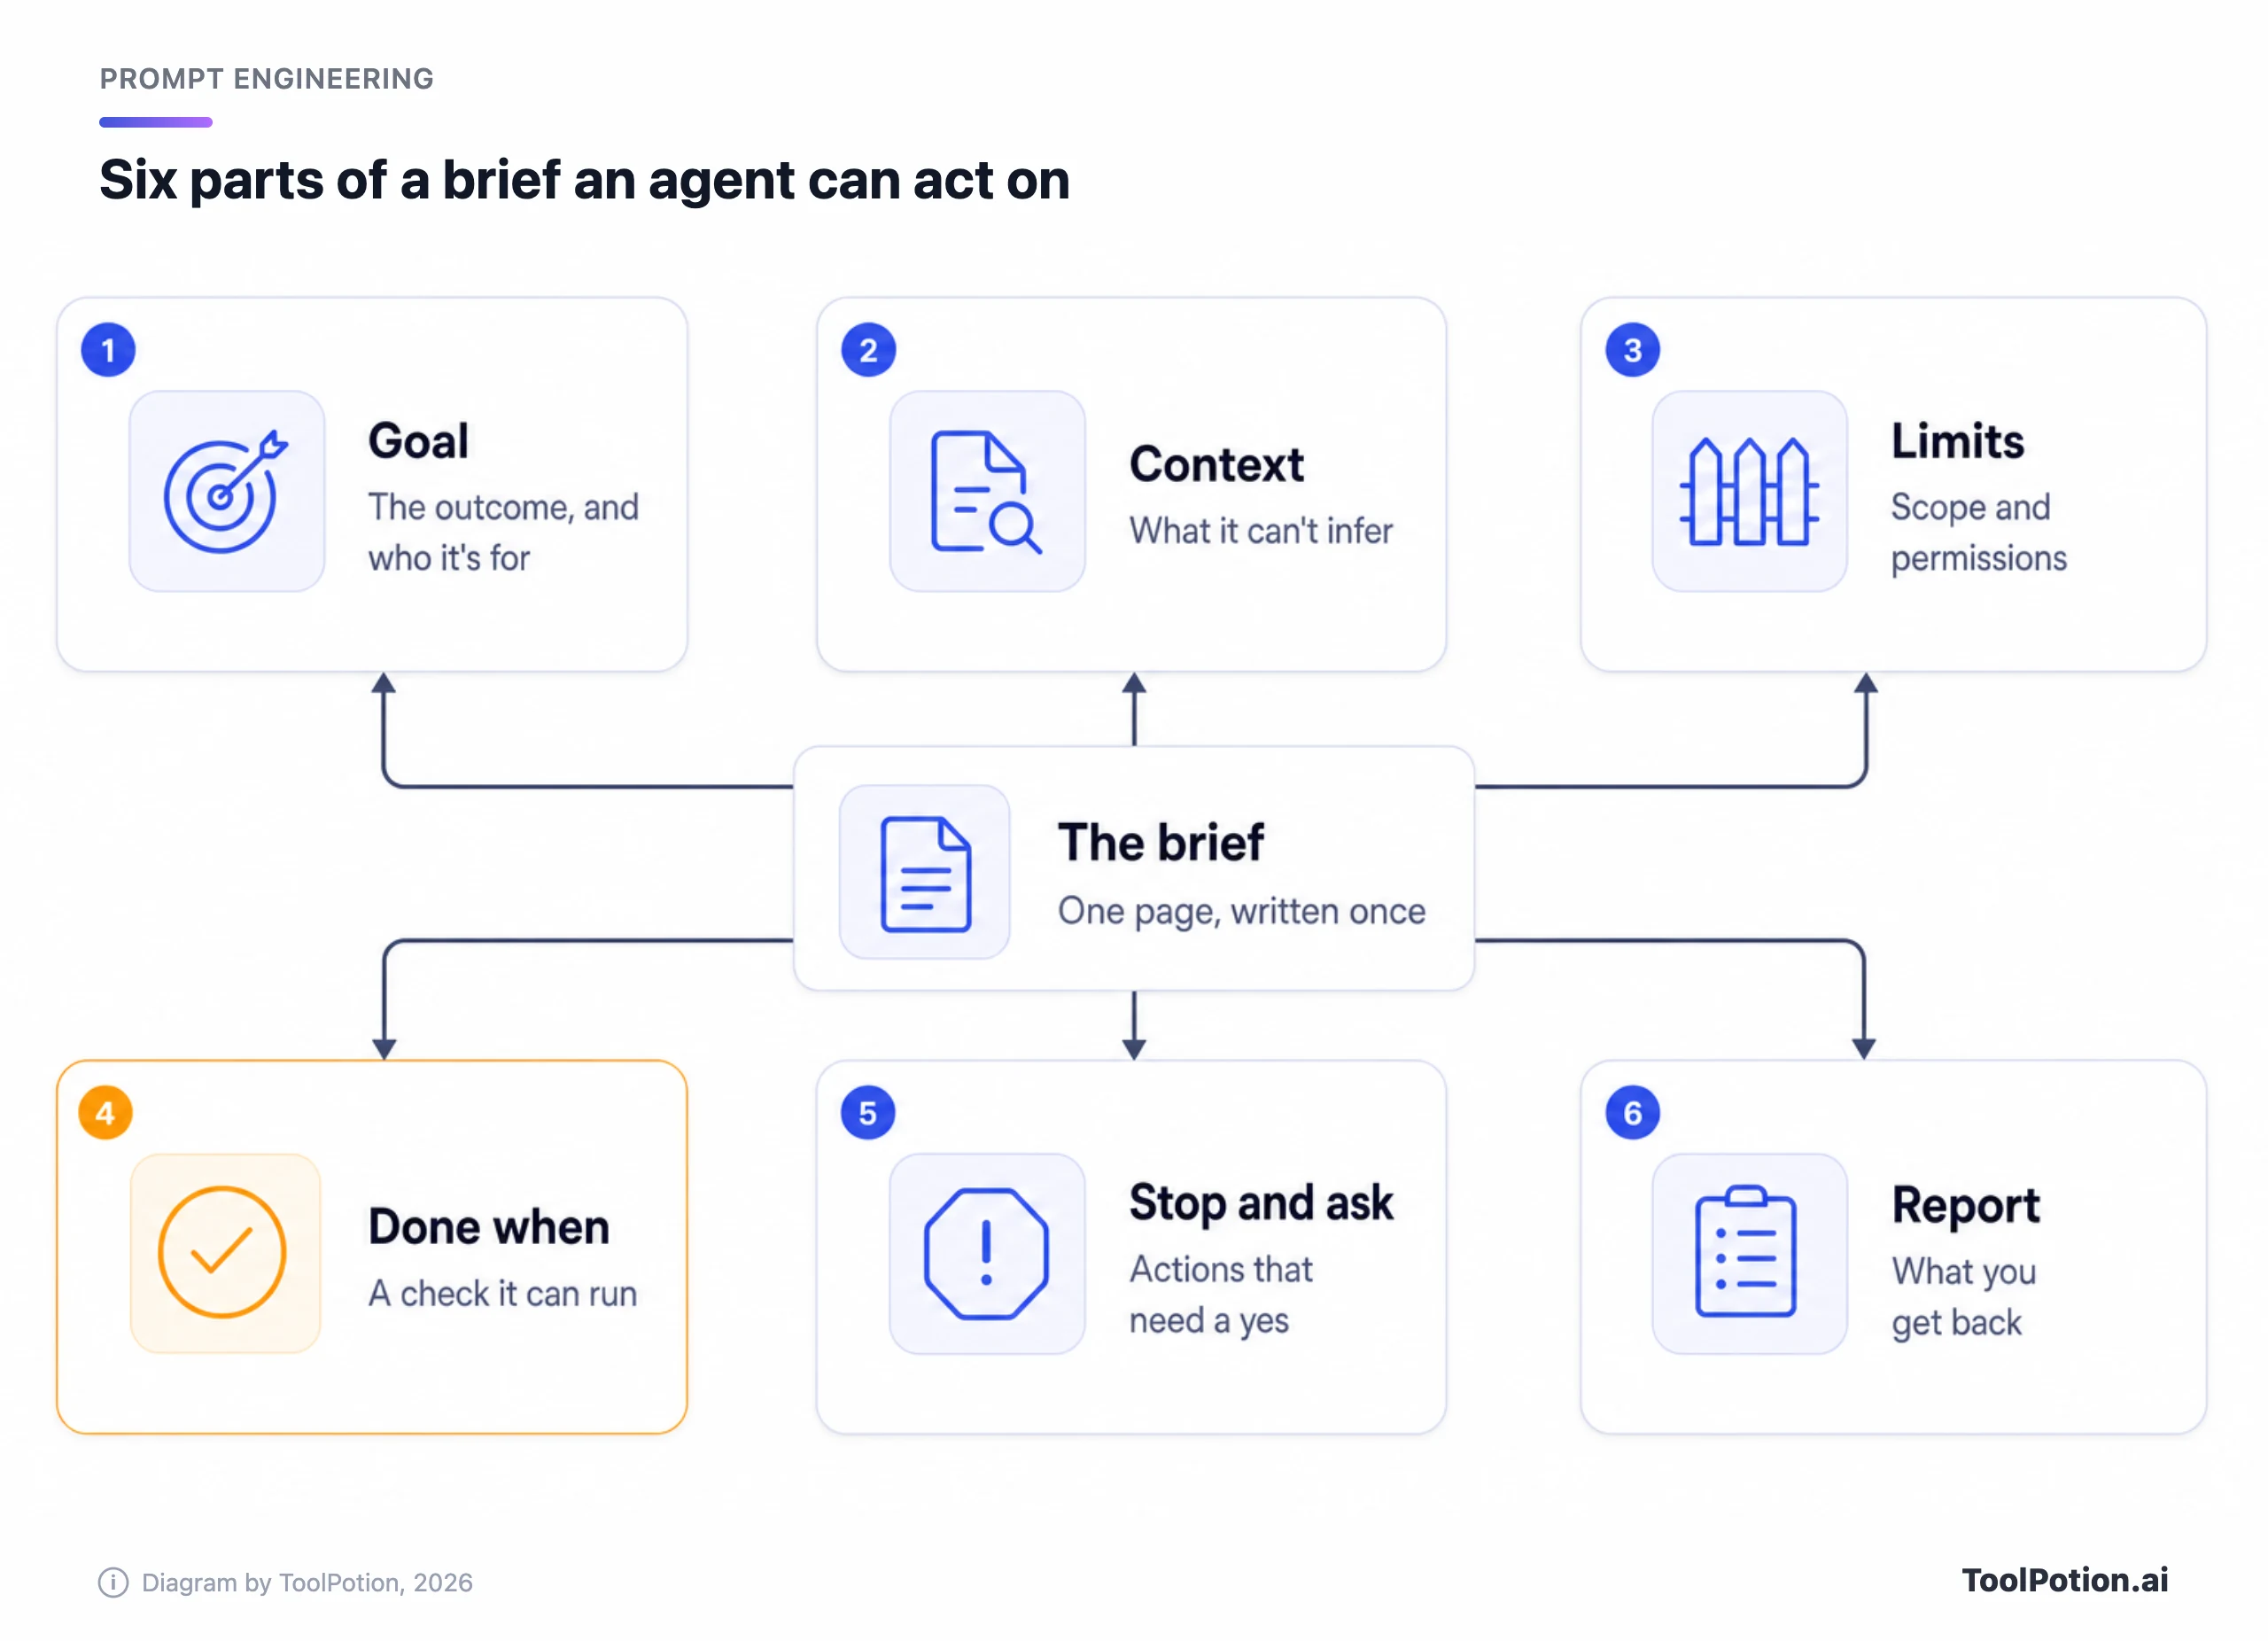
ويصل إرشاد Codex من OpenAI إلى الفكرة نفسها من الجهة الأخرى. فهو يقترح أربعة أشياء في الـ prompt: هدفًا، وسياقًا، وقيودًا، و«الإنجاز عندما» (Done when)، ويصوغها سؤالًا عمّا ينبغي أن يكون صحيحًا قبل اكتمال المهمة، «كنجاح الاختبارات، أو تغيّر السلوك، أو اختفاء خلل لم يعد يظهر» (OpenAI Codex docs). شركتان ومنتجان وهيكل واحد. ونضيف من عندنا جزأين (التوقف والسؤال، والتقرير)، ونكتب سطر «الإنجاز عندما» أولًا مع أنه يأتي رابعًا في التعليمات النهائية، لأن كتابته تجبرك على اكتشاف ما تريده فعلًا.
خارج البرمجة يصلح السطر نفسه مع فحص مختلف. «جدول بـ12 مزوّدًا، ورابط مصدر بجانب كل سعر، وعلامة على أي سعر غير معلن» شيء يستطيع الوكيل عدّه. أما «مقارنة شاملة» فشيء لا يستطيع إلا أن يستشعره.
الأجزاء الستة للتعليمات، من الأعلى إلى الأسفل
الهدف يسمّي النتيجة ومن يستخدمها
جملة أو اثنتان. قل ما تريده في النهاية وما الذي سيتغذى عليه: توصية سيقرؤها شريكان في خمس دقائق، أو إصلاح يُنشر يوم الجمعة، أو قائمة مختصرة لعملية شراء. الوجهة تغيّر ما يُدرجه الوكيل وما يحذفه. «ابحث في الأسعار» ينتج كمًّا هائلًا. «أوصِ بأداة واحدة بأقل من 15 دولارًا للمقعد» ينتج قرارًا.
السياق هو كل ما لا يستطيع الوصول إليه بنفسه
تقدّم وثائق Claude Code مرشّحًا مفيدًا: «هل كان يمكنه إيجاد هذا بقراءة الشيفرة؟ وهل سيذهب فعلًا ليبحث؟ إن كان الجوابان نعم، فاحذفه.» (Claude Code docs) وما يبقى هو قرار الاجتماع الذي لم يصل إلى المستودع، والحساب الذي ينبغي أن يستخدمه الوكيل، والأداة التي جرّبتها وتركتها، ومستوى القارئ.
اذكر السبب وراء القاعدة أيضًا. يقول دليل Anthropic إن السياق أو الدافع وراء التعليمة «قد يمنح Claude مزيدًا من المعلومات عن أهدافك ويساعده على تقديم إجابات أكثر استهدافًا»، ومثاله على الصيغة الأضعف عبارة «NEVER use ellipses» المجرّدة (Anthropic docs).
الحدود تحدد ما هو داخل النطاق وما هو ممنوع
تميل الوكلاء إلى فعل أكثر مما طلبت. يقول دليل Anthropic إن Claude Opus 4.5 و4.6 لديهما ميل إلى «إنشاء ملفات إضافية، وإضافة تجريدات غير ضرورية، أو بناء مرونة لم تُطلب»، ويقدّم تعليمة نموذجية تتضمن «لا تضف ميزات ولا تعِد هيكلة الشيفرة ولا تُجرِ "تحسينات" تتجاوز ما طُلب.» (Anthropic docs) ويربط الدليل هذه العادة بهذين النموذجين، فتحقق منها على أي نموذج تستخدمه. ونحن سنستعير الجملة في الحالتين. ثم أضف قائمتك الخاصة: المجلدات التي يجوز له لمسها، والمصادر التي يجوز له استخدامها، والحسابات التي لا يجوز له تسجيل الدخول إليها.
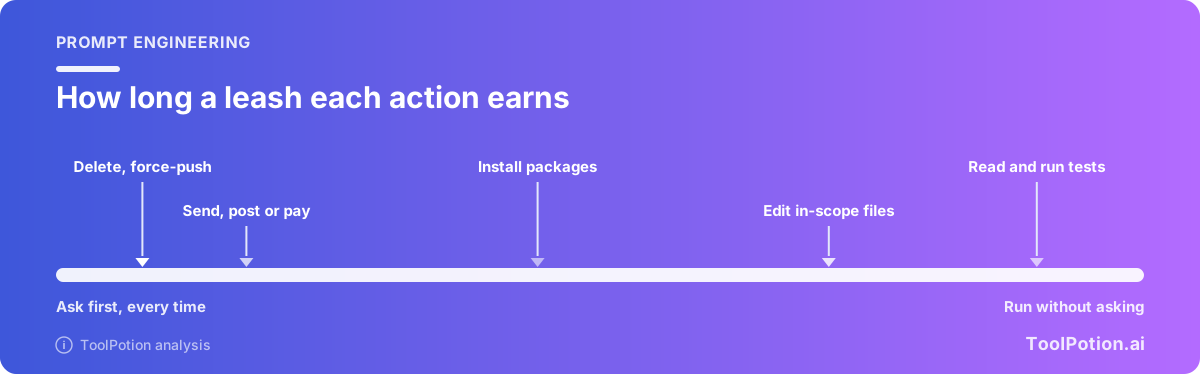
يدرج دليل Gemini من Google تقييم المخاطر ضمن الإعدادات التي يتحكم بها الـ prompt الخاص بالوكيل، ويقول إنه يستطيع أن يميّز صراحةً بين الإجراءات الاستكشافية منخفضة المخاطر (القراءة) وتغييرات الحالة عالية المخاطر (الكتابة) (Google AI docs). هذا التقسيم هو الجزء المفيد. القراءة وتشغيل الاختبارات لا تحتاج إلى تصريح، أما الحذف والإرسال والدفع فتحتاج.
تنبيه قبل أن تعتمد على أي من هذا. الكلمات في التعليمات مجرد طلبات. أما بيئة العزل (sandbox) أو token للقراءة فقط أو قاعدة صلاحيات فهي إنفاذ حقيقي، ولا يحلّ أحدهما محل الآخر. يتناول دليلنا حول احتواء وكلاء الذكاء الاصطناعي جانب الإنفاذ، أما هذا المقال فيقتصر على ما تكتبه أنت.
«الإنجاز عندما» فحص يستطيع تشغيله
سمِّ الأمر أو العدد أو الملف. «الاختبارات تنجح» بداية. أما «ينجح pnpm test ويُثبت اختبار جديد أن الطلب رقم 101 خلال دقيقة يحصل على 429» فهو فحص. وفي البحث، حدّد عدد العناصر والحقول وما يُكتب حين يتعذر العثور على حقل. وإن كان الفحص قد يفشل، فقل للوكيل ماذا يفعل بعد ذلك، وضع له سقفًا. يلاحظ دليل Google أن «المثابرة العالية ترفع معدلات النجاح لكنها تخاطر بتكاليف token أعلى أو بحلقات متكررة»، ولذلك فإن «أعد محاولة الاختبار الفاشل مرتين، ثم توقف وأبلغ» سطر أفضل من الصمت (Google AI docs).
التوقف والسؤال قائمة إجراءات، لا مزاج
عبارة «اسألني إن لم تكن متأكدًا» تترك للوكيل حكمًا عليه أن يصدره، والوكيل المتحمس نادرًا ما يشكّ. اكتب قائمة بالإجراءات بدلًا من ذلك. في دليل Anthropic prompt نموذجي لهذا الغرض بالضبط، كُتب لـ Claude Opus 4.6: بالنسبة إلى الإجراءات «التي يصعب التراجع عنها، أو تؤثر في أنظمة مشتركة، أو قد تكون مدمّرة، اسأل المستخدم قبل المتابعة»، ومن الأمثلة حذف الملفات أو الفروع، وgit push --force، وإرسال الرسائل (Anthropic docs). القائمة هي الجزء الذي ننصح بنسخه، أيًّا كان النموذج الذي تستخدمه.
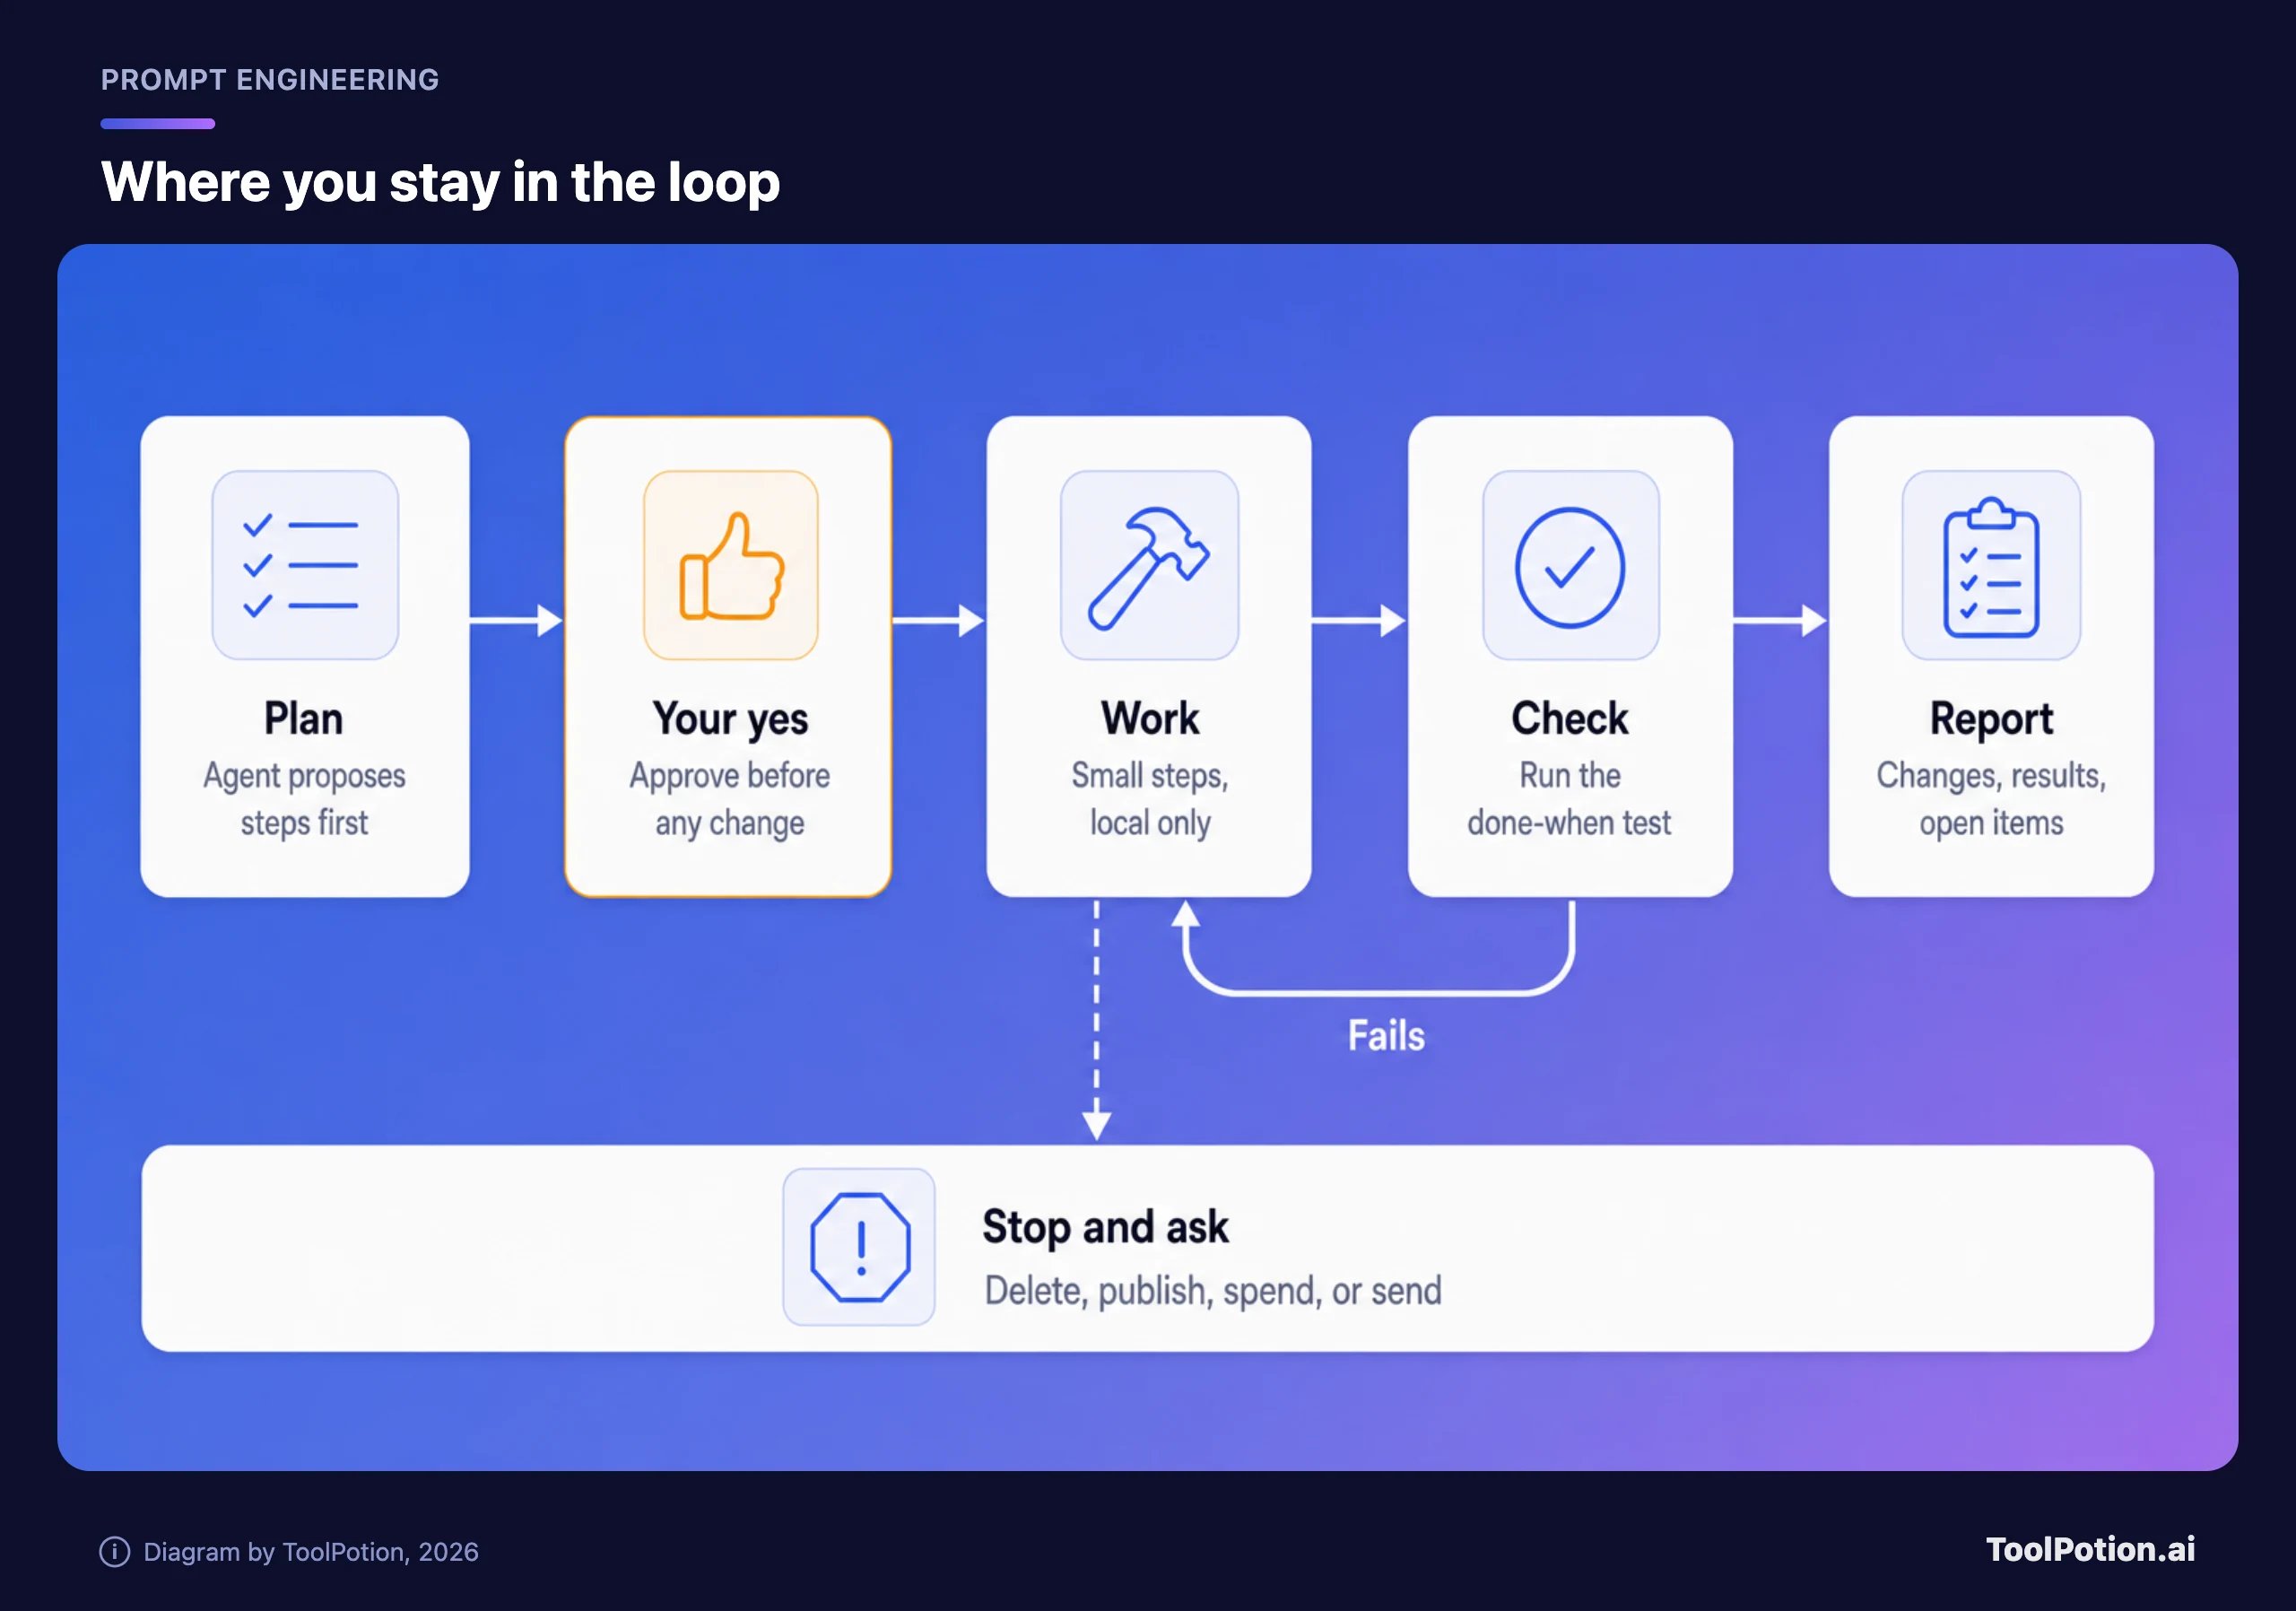
ويصف مقال Anthropic عن تصميم الوكلاء هذا النمط: يمكن للوكلاء «بعد ذلك التوقف لتلقي ملاحظات بشرية عند نقاط التفتيش أو عند مواجهة عوائق» (Anthropic Engineering). اجعل نقطة التفتيش الأولى خطة. اطلب الخطوات قبل أي تغيير، واقرأها، ثم قل «انطلق». تكلّف ذهابًا وإيابًا واحدًا، ونرى أنها أرخص نقطة تفتيش ممكنة.
التقرير هو المكان الذي تحدد فيه ما يعود إليك
اطلب التغييرات التي أُجريت، والفحوص التي نُفّذت مع نتائجها، وأي افتراض افترضه، وأي شيء اختار ألا يفعله. هذا البند الأخير هو الذي ينساه الناس. ففيه يخبرك الوكيل أنه تجاوز الـ migration لأنك قلت له ألا يلمس المخطط (schema).
ثلاث تعليمات، قبل التعديل وبعده
تتراوح كل إعادة صياغة أدناه بين 120 و150 كلمة تقريبًا. هذا أطول من الـ prompt المعتاد وأقصر مما يخشاه الناس. والتعليمات الثلاث كلها أمثلة ابتكرناها بأنفسنا: المهام والأدوات والأرقام مختلقة للتوضيح، ولا شيء منها مأخوذ من شركة أو من مشروع حقيقي.
وكيل بحث (مثال مُختلَق)
Before:
Find the best project management tool for a ten-person design agency.After:
Goal: Recommend one project-management tool for a ten-person design agency that bills by the hour. Two partners will read the result in five minutes.
Context: We use Google Workspace and Slack. Our shared spreadsheet fails at time tracking and client approvals. The ceiling is $15 per seat per month, billed monthly.
Limits: Use vendor pricing pages and documentation only. Skip review sites and "best tools" lists. Don't sign up for anything or enter our email anywhere.
Done when: A table of at most six tools with price per seat, billing basis, a link to the pricing page, and whether time tracking and client approvals are built in. Write "not public" for any price you can't find. End with one recommendation and the one reason it could be wrong.
Stop and ask: If fewer than three tools fit the budget, tell me before widening it.
Report: The table, your recommendation, and a list of what you assumed.وكيل برمجة (مثال مُختلَق)
تتضمن وثائق Claude Code مثالها الخاص قبل التعديل وبعده: فعبارة «أضف أداة تقويم» تتحول إلى طلب باتباع النمط الموجود في ملف أداة قائمة، مع «عدم استخدام مكتبات جديدة» (Claude Code docs). وهذه الخطوة نفسها على مهمة أكبر، مكتوبة لـ Claude Code أو Codex.
Before:
Add rate limiting to the public API.After:
Goal: Add per-API-key rate limiting (100 requests a minute) to the public REST endpoints so one noisy client can't slow the rest.
Context: Endpoints live in src/api/public/. Follow the middleware pattern in src/api/middleware/auth.ts. Limits belong in config/limits.yaml. Redis is available through src/lib/redis.ts.
Limits: Touch only src/api/ and config/. No new dependencies. Don't change the auth middleware or any existing test. Work on a new branch.
Done when: pnpm test passes, pnpm typecheck is clean, and a new test shows the 101st request in a minute returns 429 with a Retry-After header. If a test fails twice, stop and report.
Stop and ask: Before adding a dependency, changing a database schema, or pushing anything.
Report: Files changed, commands run with results, and any decision I should review.وكيل صندوق الوارد (مثال مُختلَق)
هذا المثال لأي مساعد تسمح له بالاقتراب من بريدك، وهو من نوع المهام التي تُباع من أجلها منتجات وكلاء مثل Manus وClaude Cowork. البريد هو المكان الذي قد تتحول فيه «نظّف» بهدوء إلى «احذف».
Before:
Clean up my inbox.After:
Goal: Reduce my inbox to messages that need a reply. Newsletters and receipts should end up under labels.
Context: Receipts come from stripe.com, paypal.com and amazon.com. Newsletters always carry an unsubscribe link. Anything from my accountant or the school stays where it is.
Limits: Create labels and move messages into them. Never delete, send, unsubscribe or reply.
Done when: The inbox holds only unread messages from people and anything from the last seven days.
Stop and ask: Show me the list of senders you plan to label before you move anything, and wait for my yes.
Report: Counts per label, and every sender you couldn't classify.سطر الهدف يكاد لا يتغير بين النسختين. الثقل كله في الأسطر الأربعة الأخيرة: فحص، وتوقف، وتقرير، وحدّ يقول ما لا يجوز للوكيل فعله أبدًا.
قالب جاهز للصق
احذف أي سطر لا ينطبق، لكن احذفه عن قصد.
Goal: <the result, and who or what uses it>

Context: <files, links, accounts, decisions and past attempts it can't see>

Limits: <in scope> / <off limits> / <sources or tools allowed>

Done when: <a command, a count or a file that proves it>. If the check fails twice, stop and report.

Stop and ask before: <delete / publish / send / spend / install / change shared systems>

Report: <changes made, checks run and results, assumptions, things you chose not to do>
قيّم مسودتك على أساسه. ثمانية أسئلة بنعم أو لا، في ثلاثين ثانية.
كيف تفشل التعليمات، وما الذي نغيّره
| الفشل | ما تراه | التعديل |
|---|---|---|
| الهدف نشاط لا نتيجة | صفحات من المخرجات بلا قرار | حدّد ما سيتغذى عليه المخرَج |
| لا يوجد «إنجاز عندما» | يتوقف عند «يبدو منجزًا» أو لا يتوقف أبدًا | أضف فحصًا يمكنه تشغيله وسقفًا لإعادة المحاولة |
| النطاق غير محدد | ملفات زائدة وإعادة هيكلة وتحسينات لم تُطلب | اذكر ما هو ممنوع |
| تحذيرات بلا أسباب | جدار من أسطر NEVER، تُتجاهل أو يُبالَغ في تطبيقها | أضف السبب في عبارة واحدة |
| الموافقة ضمنية فقط | يحذف أو يدفع أو يرسل بحكمه الخاص | سمِّ الإجراءات واطلب خطة أولًا |
| تصحيحات تتراكم | التعليمات تناقض بعضها | أعد كتابة التعليمات وابدأ من جديد |
اثنان من هذه الأسباب يستحقان كلمة أطول. الأول هو كومة الحروف الكبيرة. نشكّ في أن زيادة التأكيد أصلحت يومًا غياب السبب، ودليل Anthropic يتجه الاتجاه نفسه: فعبارة «NEVER use ellipses» المجرّدة هي مثاله الأضعف. وتضيف وثائق Claude Code أن «عبارات مثل think step by step أو be thorough نصّ عادي في الـ prompt وليست كلمات مفتاحية» (Claude Code docs). ولهذا سنحذف عبارات «كن شاملًا» الجاهزة. أما دليل Anthropic فيوصي فعلًا بإسناد دور لـ Claude، ولو بجملة واحدة، فلن نمنعه؛ لكننا نتجاوز شخصية «الخبير العالمي»، لأن الأجزاء الستة تخبر الوكيل بأكثر مما يخبره به لقب.
والثاني هو المشكلة المعاكسة. الـ prompt النموذجي للوكيل في دليل OpenAI (معروض لنموذج gpt-6-astra، كمثال لا كقاعدة) يطلب من النموذج أن «يواصل حتى تُحَلّ استفسارات المستخدم بالكامل» ويقول «لا تتوقف بعد إكمال جزء من الطلب فقط» (OpenAI docs). هذا معقول لعمل له خط نهاية واضح، وفخ لعمل بلا خط نهاية. فقد يواصل وكيل مثابر ذو هدف غامض إنفاق الـ tokens في حلقة؛ ودليل Google يقول الأمر نفسه عن المثابرة العالية. ويذكر مقال Anthropic أن من الشائع تضمين «شروط توقف (مثل حدّ أقصى لعدد التكرارات)» للحفاظ على السيطرة (Anthropic Engineering).
عادة أخرى نتخلى عنها: لصق التعليمات في محادثة تحتوي أصلًا عشرة تصحيحات. صار لدى الوكيل أحد عشر مجموعة من التعليمات ولا وسيلة لترتيبها بحسب الأولوية.
راقب الدقيقة الأولى، ثم أعد الكتابة
تنصح وثائق Claude Code: «راقب الدقيقة الأولى، واضغط Esc لحظة ينحرف Claude، وبعد تصحيحين فاشلين نفّذ /clear واكتب prompt أفضل بدل أن تكتب تصحيحًا ثالثًا» (Claude Code docs). نطبّق هذا على أي وكيل: فالخطة الأولى والإجراءات القليلة الأولى تكشف هل قُرئت تعليماتك كما قصدت.
وحين لا تستطيع كتابة التعليمات بعد، دع الوكيل يحاورك. تقترح وثائق Claude Code prompt على غرار «حاورني حتى تستطيع كتابة المواصفات، ثم اكتبها في SPEC.md»، ويقول إرشاد Codex أن تطلب منه أن يسألك أولًا و«يتحدى افتراضاتك» (Claude Code docs، وOpenAI Codex docs). ثم ابدأ جلسة جديدة من المواصفات المكتوبة.
التعليمات التي تنجح مرتين تستحق مكانًا دائمًا. القواعد الثابتة (كيف تُشغَّل الاختبارات، وما لا يجوز لمسه أبدًا) تُوضع في ملف AGENTS.md أو CLAUDE.md؛ وتقول OpenAI: «ملف AGENTS.md قصير ودقيق أنفع من ملف طويل مليء بقواعد غامضة» (OpenAI Codex docs). والإجراء الذي تكرره يمكن أن يصير skill، وهو ما نتناوله في من الـ Prompts إلى الـ Skills. أما ما ينبغي تحميله في الجلسة أصلًا فهو موضوع مقالنا عن هندسة السياق، وعادات إبقاء الـ prompts فعّالة عبر إصدارات النماذج في أنماط Prompt تصمد أمام تحديثات النماذج. وللاطلاع على أدوات مبنية حول هذا النوع من التفويض، راجع لوحاتنا الخاصة بـوكلاء الذكاء الاصطناعي ومهام بناء الوكلاء وأدوات هندسة الـ prompts.
الأسئلة الشائعة
ما الطول المناسب للتعليمات؟
بقدر ما يتّسع للأجزاء الستة، وهو في أغلب المهام بين 100 و200 كلمة. التفضيلات الثابتة مكانها ملف قواعد، حتى تقتصر كل تعليمات على المهمة الحالية. وإن تجاوزت التعليمات صفحة، فالأرجح أن المهمة تحتاج إلى تقسيمها إلى اثنتين.
هل تحتاج ChatGPT وClaude وGemini إلى تعليمات مختلفة؟
الهيكل واحد. فالأجزاء الأربعة في إرشاد Codex من OpenAI، ونصيحة Anthropic بتوفير السياق والسؤال قبل الإجراءات الخطرة، وأبعاد الوكيل عند Google (التعامل مع الغموض، وتقييم المخاطر، والمثابرة) كلها تصف مجموعة حاجات واحدة بكلمات مختلفة. التنسيق يختلف قليلًا: يوصي دليل Google بوسوم على نمط XML أو عناوين Markdown ويقول «اختر صيغة واحدة والتزم بها باستمرار» (Google AI docs). أما أي مساعد يناسب أي مهمة فسؤال مستقل نتناوله في ChatGPT مقابل Claude مقابل Gemini في 2026.
ماذا أقول للوكيل أن يفعل حين لا يكون متأكدًا؟
أعطه قاعدة يستطيع تطبيقها. «افترض أي شيء يمكن التراجع عنه وأدرجه في التقرير، واسأل قبل أي شيء لا يمكن التراجع عنه» أفضل من «اسأل إن لم تكن متأكدًا». ويصوغ دليل Google الاختيار نفسه بأنه متى يجوز للنموذج أن يفترض ومتى يجب أن يتوقف لطلب توضيح أو إذن.
هل تكفي التعليمات الجيدة لجعل الوكيل آمنًا؟
لا. التعليمات تقلّل الأخطاء ولا تمنع أيًّا منها. توصي Anthropic بـ«اختبارات مكثفة في بيئات معزولة (sandbox)، مع ضوابط حماية مناسبة» (Anthropic Engineering)، ويتناول دليلنا حول الاحتواء الصلاحيات ومسارات التدقيق.
ما زال الوكيل يخطئ. ماذا أفعل؟
ابحث عن أول خطوة انحرف فيها الوكيل واسأل ماذا قالت التعليمات عن تلك الخطوة. أضف السطر الوحيد الذي كان سيمنع ذلك، ثم أعد التشغيل من جلسة جديدة.