

«لا ندّعي أننا نفهم البرهان بالكامل حتى الآن». هذه الجملة صادرة عن اللجنة التي عيّنتها OpenAI لفحص نتيجتها المزعومة في مسألة يانغ–ميلز، كما نقلتها Scientific American. وكانت المجموعة، بقيادة الفيزيائي David Gross، قد أكدت للتو أن برهان أحد شطري المسألة يجتاز الفحص في Lean، وهي لغة برمجة تتحقق من الأعمال الرياضية. ومع ذلك لم تستطع أن تشرح كيف يعمل البرهان.
قرأنا أحدث ما نُشر في مجال الذكاء الاصطناعي للعلوم: ذلك المقال، وخمس تدوينات من Anthropic، ومعيارًا مخبريًا من OpenAI، وتقرير TechCrunch عن شركة ناشئة اسمها PSI، وتدوينة لكاتب رصد وكلاؤه من الذكاء الاصطناعي موقعًا لحضارة المايا غير مدرج في السجل الرسمي المكسيكي. العناوين الصحفية تسبق كل ذلك بمراحل. لذلك أخذنا ستة ادعاءات شائعة وفحصنا كلًا منها على ضوء ما تقوله المصادر فعلًا.
الادعاء الأول: الذكاء الاصطناعي يكتشف علمًا جديدًا من تلقاء نفسه
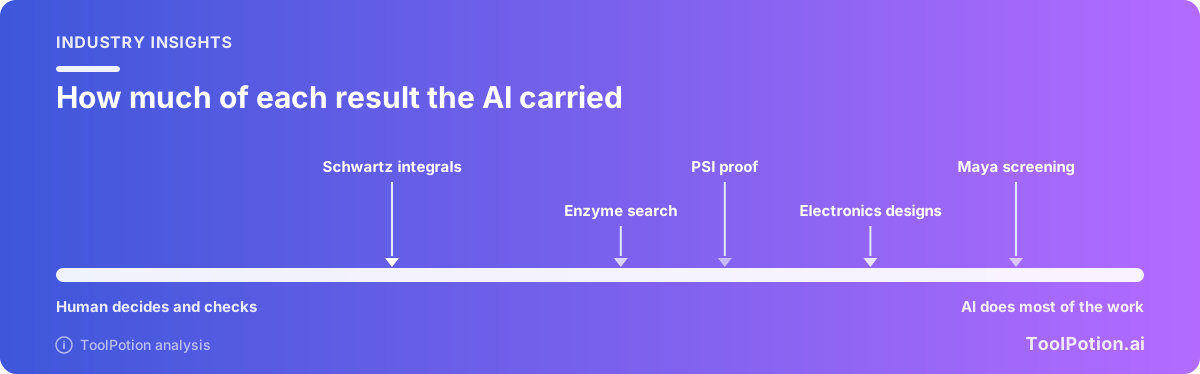
الحكم: ليس من تلقاء نفسه. أفضل الحالات حقيقية، وفي كل واحدة منها اختار إنسان السؤال، أو أجرى الفحوص، أو فعل الأمرين معًا.
لنبدأ بعلم الأحياء. تقول Anthropic إن وكلاء Claude عثروا على منظومة إنزيمية ذات تكرارات شبيهة بـ CRISPR، باستخدام نحو 950 وكيلًا و210 ملايين token و21 ساعة (Anthropic). رصد أحد الوكلاء نمط التكرار. أما علماء Anthropic فقدّموا الـ prompt الأولي وأنجزوا كل العمل المخبري، واستُبعد معظم مرشحي Claude أثناء المراجعة، والورقة المنشورة ما زالت preprint. والعمل على الوظيفة الأساسية للمنظومة لم ينتهِ بعد. تقول التدوينة إن Claude «يبدو أول من لاحظ» السمات المميزة للمنظومة، وإن Claude «يستطيع اكتشاف الشذوذ بصورة مستقلة»: وهذا منصف لمرحلة البحث، لا لبقية المراحل. وقد وصف Feng Zhang من MIT ومعهد Broad، في التدوينة نفسها بعد قراءته للـ preprint، العمل بأنه «مثال مثير على كيف يمكن لوكلاء الذكاء الاصطناعي أن يسهموا في الاكتشاف البيولوجي»، وقال إن النتيجة «تستحق مزيدًا من البحث».
الفيزيائي Matthew Schwartz، وهو باحث زائر في Anthropic، أكثر صراحة من معظم غيره. ففي تدوينة ضيف نشرها لدى Anthropic، يذكر أنه شغّل 30 تكاملًا (integral) من البداية إلى النهاية مع Claude، أعاد 15 منها نتائج معروفة، و15 لم تُحسب من قبل (Anthropic). يسمّي الأهداف الجيدة مسائل «على مقاس Claude»، ويضيف أن الأمر «قد يتطلب كثيرًا من الإمساك باليد حتى تُنتج هذه النماذج أي شيء ذي قيمة علمية». وبعد أن استعان بخبراء من خارج الفريق، وجد أن «Claude كان في أغلب الحالات صائبًا من الناحية التقنية، لكن النتيجة لم تكن مثيرة للاهتمام كثيرًا إلى أن ساعدنا الخبير في توجيه المسار». ويقول إن Claude «يميل إلى الجدالات القديمة، التي كثر الاستشهاد بها ثم طواها النسيان». أما الحكم على ما يستحق الحل فبقي بيد البشر.
ثم PSI. يفيد TechCrunch بأن David Turturean، عضو الفريق التقني في المختبر الناشئ Physical Superintelligence (PSI)، استخدم وصولًا مبكرًا إلى نموذج Fable 5.2 من Anthropic لحل مسألة عمرها 18 عامًا من الحوسبة الكمّية، هي حدسية Aaronson-Ambainis (TechCrunch). يكتب Scott Aaronson، الذي طرح المسألة، أنه لا يفهم البرهان تمامًا لكنه يعتقد بصحته، لأنه صُيغ آليًا في Lean وشرحه فريق من كبار الباحثين شاركتهم PSI إياه. ووصف Turturean نفسه متواضع: «إنها نتيجة سلبية تتيح للناس أن يعرفوا: حسنًا، لم نعد نبحث هناك». ويبدو أن الحل يغلق طريقًا واحدًا نحو التسريع الكمّي، لا كل الطرق.
نصف هذا بأنه متعاون سريع لا يكلّ، لكنه يحتاج إلى من يختار له المسألة. وهذا كثير. لكنه ليس استقلالية، وتدوينات الشركات نفسها تقول ذلك لمن يقرأ حتى التحفظات.
الادعاء الثاني: النتائج مُتحقَّق منها
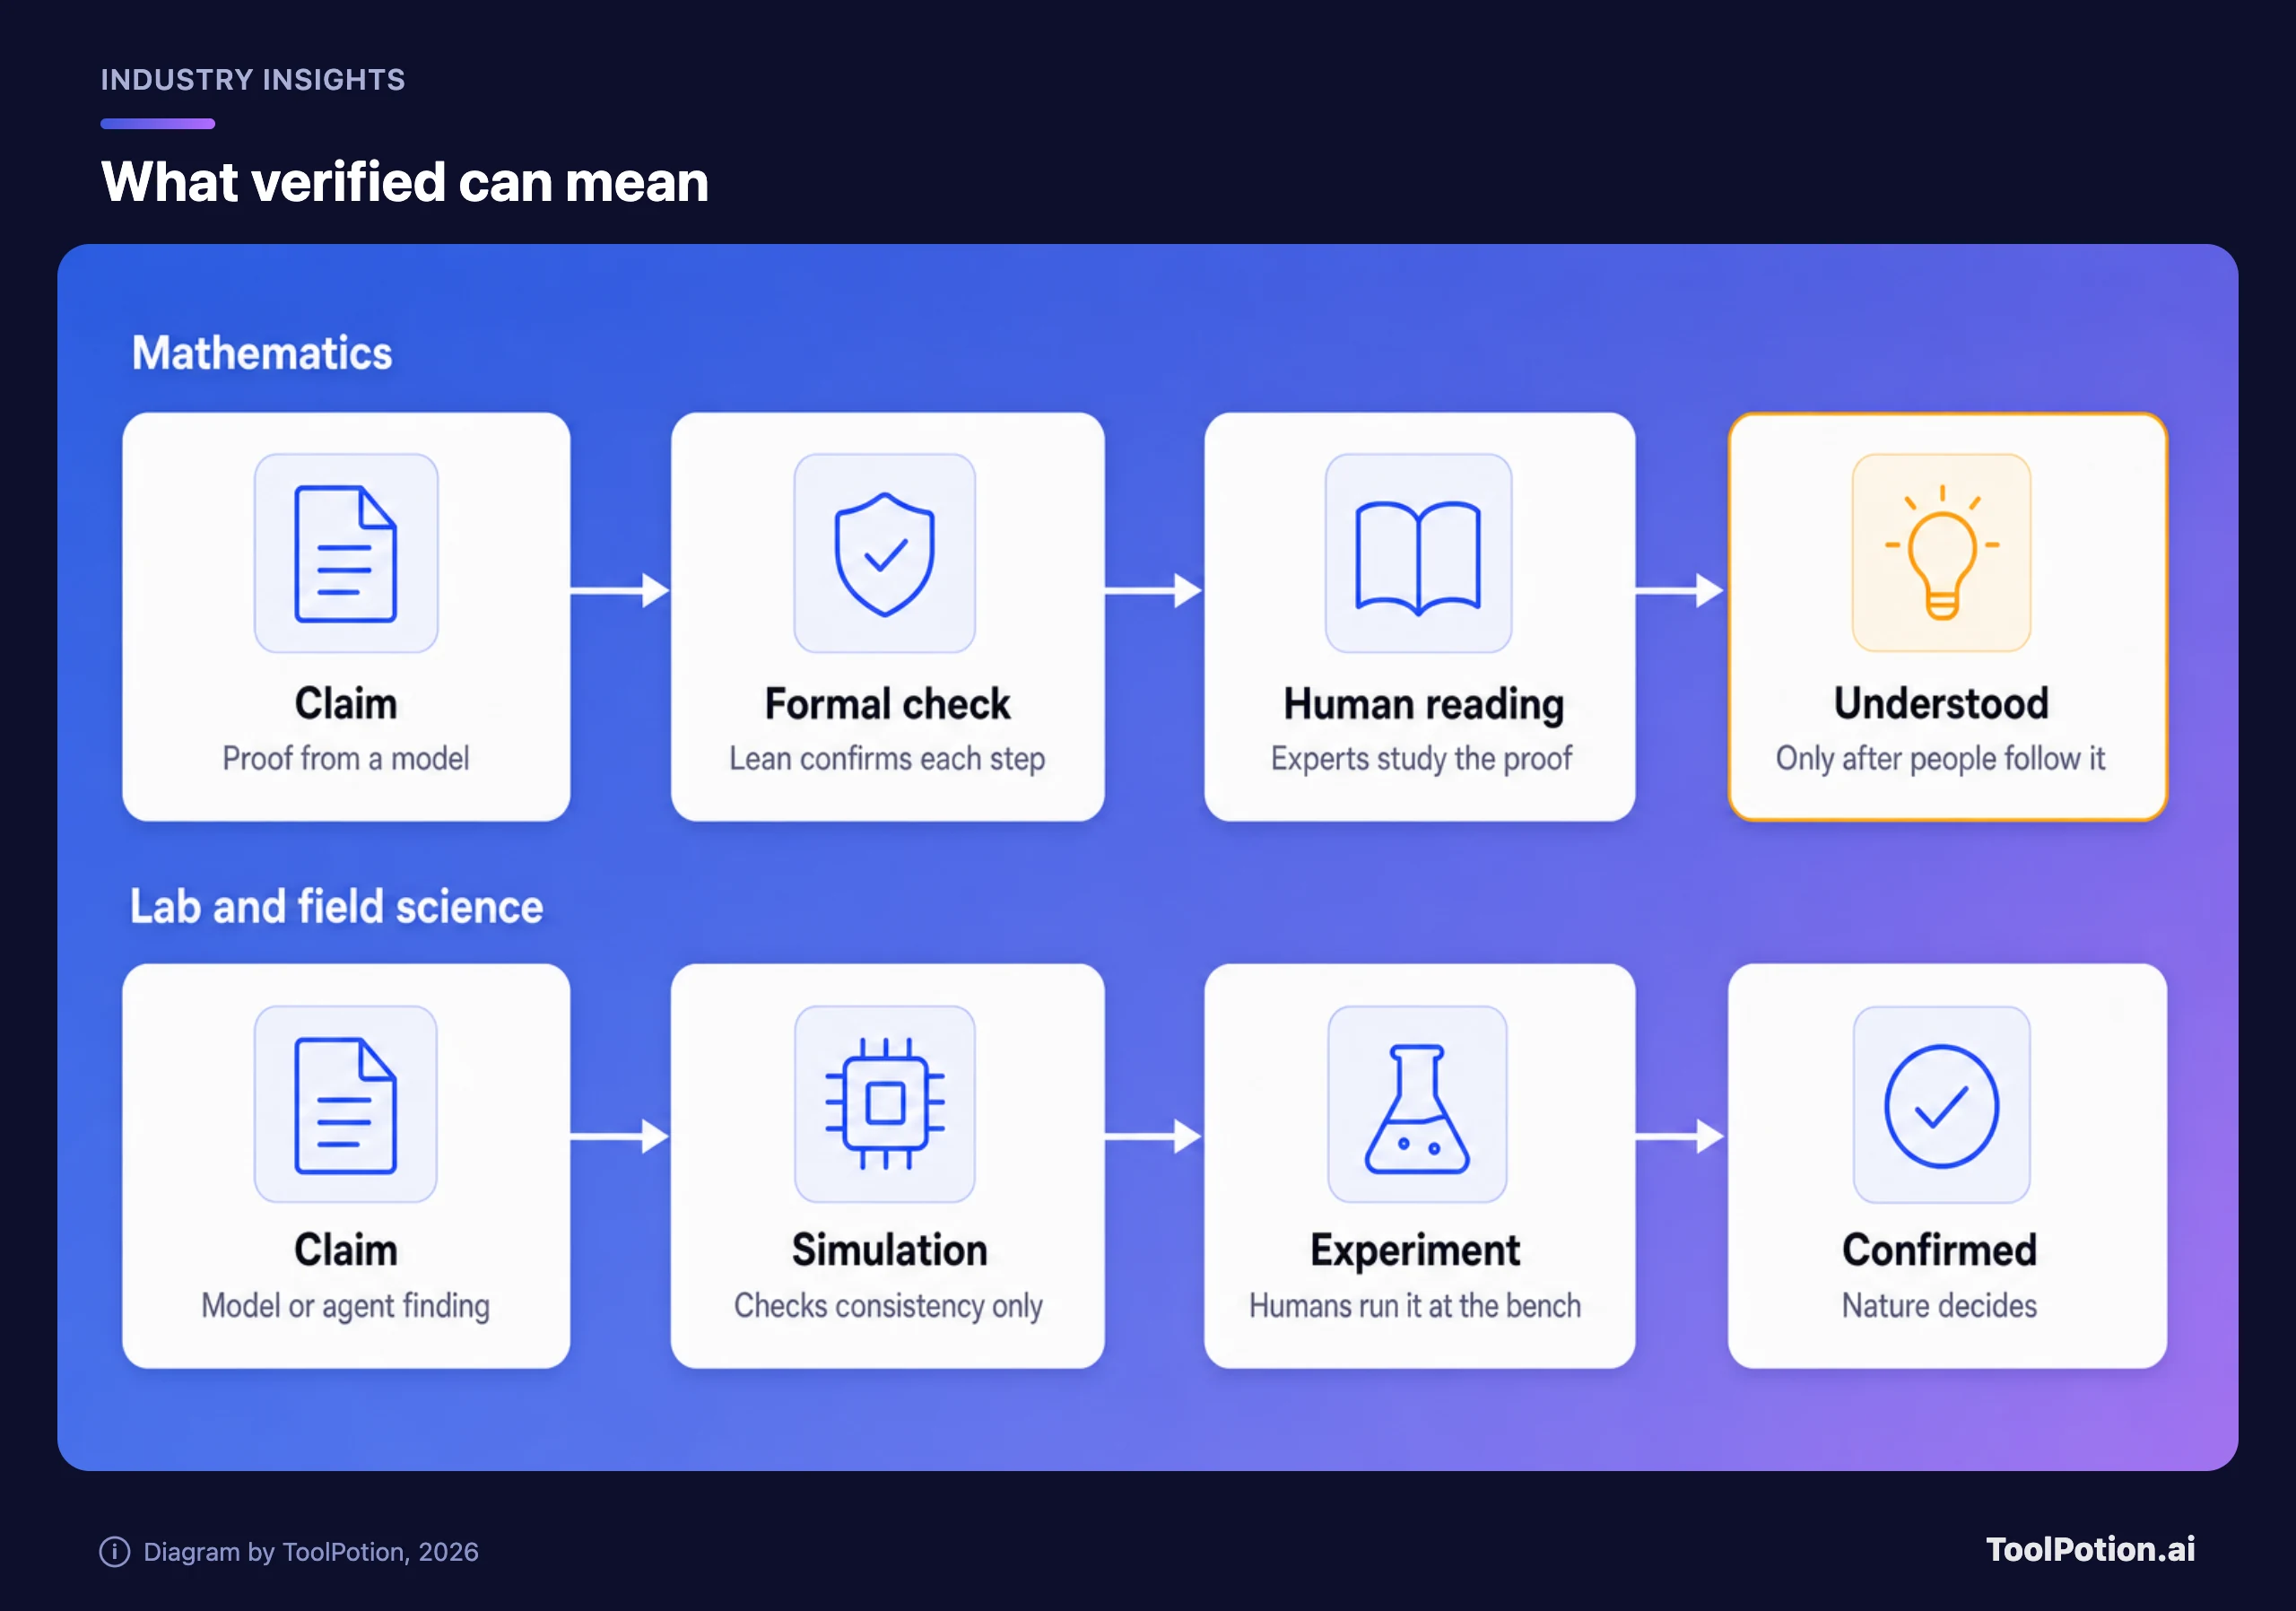
الحكم: جزئيًا. المدقق الصوري اختبار قوي في الرياضيات. أما في غيرها فقد تعني كلمة «مُتحقَّق منه» أي شيء، من محاكاة إلى بحث في سجل.
في الرياضيات، يستطيع Lean أن يؤكد آليًا أن البرهان يلزم عن المقولة التي أُعطيها. وهذا فحص قوي، وهو سبب أخذ نتائج PSI وOpenAI بجدية أصلًا. لكن تقارير Scientific American تُظهر حدوده. فادعاء OpenAI يغطي شطر الوجود من مسألة يانغ–ميلز، أما شطر فجوة الكتلة المنفصل فما زال دون حل. واستعانت اللجنة بنموذج Astra التابع لـ OpenAI نفسها لهضم شيفرة Lean، وتقول صراحةً إنها لا تدّعي فهم البرهان بعد.
ثم مسألة الانفتاح. تشير Scientific American إلى أن أسلوب «الرعاية» يتعارض مع توصيات الشفافية الصادرة عن مجموعة استشارية مرتبطة بـ OpenAI، وأنه أثار استياء بعض الرياضيين الذين يرونه احتكارًا للوصول. برهان Lean متاح للعامة الآن. وقال Scott Armstrong من NYU إنه سعيد بنشره أخيرًا، وأضاف: «يمكن إنجاز هذه المراجعة بكفاءة وسرعة أكبر في العلن» (Scientific American). ونحن نتفق معه. فبرهان لم تره إلا لجنة عيّنتها OpenAI كان ادعاءً ينتظر المراجعة، والمراجعة يمكن أن تبدأ أخيرًا.
خارج الرياضيات لا وجود لـ Lean. قال Matt Pines، الرئيس التنفيذي لـ PSI، لـ TechCrunch إن الفيزياء تختلف عن الرياضيات لأن «الطبيعة لها صوت في نماذجك عن الواقع»، وإن الفيزياء النظرية التي تقودها الآلة «لم تصل بعد، لكنها في الطريق». ووجد Schwartz أن «الفحوص الآلية ما زال لا يمكن الوثوق بها». أما تدوينة المايا، التي سنعود إليها، فقد تلقت ردًا رسميًا: لم يجد المعهد المكسيكي أي موقع مسجّل في الموضع المُبلَّغ عنه. وهذا يؤكد غياب الموقع عن السجل، لكنه لا يؤكد وجود الموقع.
الادعاء الثالث: الوكلاء يستطيعون إدارة مختبر
الحكم: ليس بعد. يستطيعون التخطيط والتصميم والتحليل. أما سحب العينات باللحام والمعايرة بالأنابيب فما زالا بيد الناس.
مقال الإلكترونيات من Anthropic هو أقوى مثال حديث، ويستحق القراءة كاملًا. بالتعاون مع شركة تصنيع اللوحات Diode (وتقول Anthropic إن لها علاقة تجارية بالشركة)، صمّم Claude (بنموذج Fable 5.2) سماعة هاتف USB-C وجهاز مساعد صوتي وحيوانًا افتراضيًا محمولًا، من المخطط الكهربائي إلى التخطيط إلى البرمجية الثابتة (Anthropic). صنّع مهندسو Diode اللوحات من ملفات تصميم Claude، وبنوا النماذج الأولية واختبروها يدويًا، لأن Claude لم يكن متصلًا بمعدات الاختبار ولا بالآلات التي تصنع اللوحات الإلكترونية. ولم تخضع الأجهزة للتحقق الكهربائي أو ضبط الهوائي أو الاختبار الحراري أو الاعتماد. كما يورد المقال مكاسب في المعايير (69% في اختبار التخطيط الداخلي PCB Gym لدى Diode، مقابل 25% للنموذج السابق)، وهي أرقام Anthropic على اختبار أُجري بطلبها، ولا يعرض التكلفة إلا على محور في رسم بياني، لا في النص.
وفي جانب الأحياء، نشرت OpenAI معيار BioBasicsBench، وهو معيار من 100 مهمة تقول إنه يقيس مدى قدرة وكلاء الذكاء الاصطناعي على تفسير البيانات التجريبية الخام والتعامل مع علم المختبر الرطب اليومي (OpenAI). إنه اختبار بنته الجهة المزوِّدة، والمعيار يظل مجرد ادعاء إلى أن يشغّله أشخاص من خارجها.
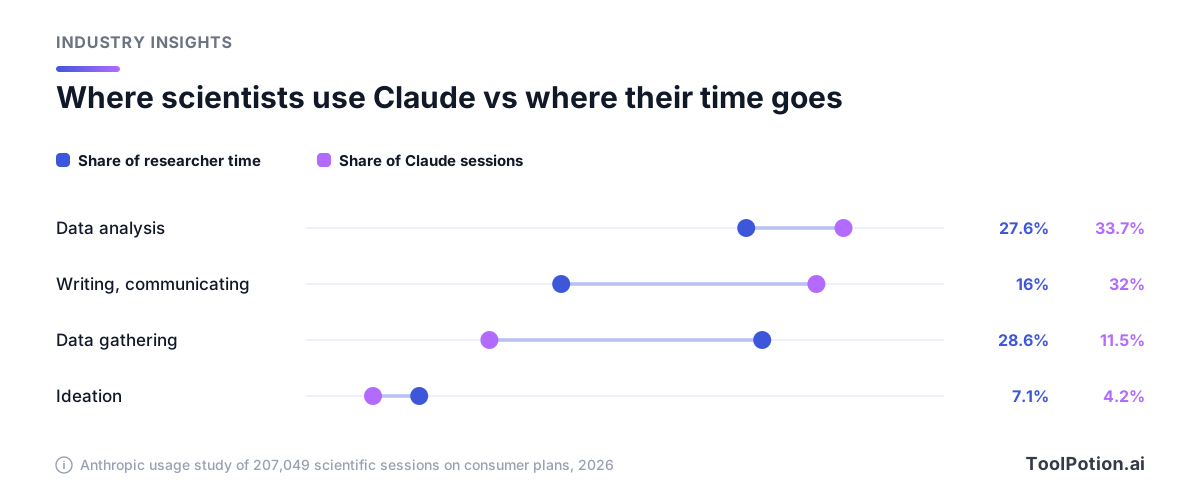
وتُظهر دراسة الاستخدام التي أجرتها Anthropic على 207,049 جلسة علمية ضمن الخطط الاستهلاكية الصورة نفسها في الواقع. فجمع البيانات يشغل 28.6% من وقت الباحثين، لكنه لا يمثل إلا 11.5% من الجلسات على Claude، وتتسع الفجوة أكثر حيث توجد عوائق مادية، مثل جمع البيانات السريرية أو الكيميائية الحيوية (Anthropic). وبعبارة الدراسة نفسها: «الاختناقات المادية ما زالت قوية».
الادعاء الرابع: بإمكان أي شخص أن يفعل هذا الآن
الحكم: بإمكان أي شخص أن يبدأ. أما الوصول إلى شيء يصمد فيتطلب شخصًا يعرف المجال.
قصة المايا هي أنقى اختبار. وجّه Pietro Miotti، الذي يقول إنه ليس عالم آثار، 48 وكيلًا إلى نحو 1,200 كيلومتر مربع من بيانات NASA العامة للـ lidar، فحصل على موقع فوق تلة فيه ساحة وهرم، ثم على رد رسمي، في أقل من 72 ساعة (تدوينته). وعبارته عن المنهج صريحة بشكل يستحق الإعجاب: «لم يكن هناك نموذج خاص ولا مصنّف: الوكلاء نظروا إلى الصور حرفيًا».
ثم التصحيح الذي يتصدر الصفحة الآن. «فات الوكلاء ذلك أثناء مرورهم على الأدبيات، فأعادوا اكتشافه بدل أن يكتشفوه». فالموقع كان قد رُسمت خريطته في ورقة عام 2025 لـ Estrada-Belli وزملائه؛ لكنه لم يكن مدرجًا بعد في السجل المكسيكي. والفضل لـ Miotti في وضع هذا في المقدمة. كما يذكر أنه لا يتحدث الإسبانية ووثق بترجمة الوكلاء لتقريره، وأن رواية العصر الكلاسيكي هي «تخمين، من محادثة طويلة مع الوكلاء»، وأن صورة إعادة البناء مولَّدة بالذكاء الاصطناعي. ولا يُذكر أي مسح ميداني.
قراءتنا: هو عرض جيد للفرز الرخيص، وعرض ضعيف للاكتشاف. فالنظر أصبح شبه مجاني. أما معرفة ما إذا كان أحد قد نظر من قبل فما زالت تحتاج إلى متخصص، أو على الأقل إلى بحث في الأدبيات لم يُجرِه الوكلاء بشكل صحيح. وكان طريق PSI مختلفًا ومفيدًا: فقد أمسكت النتيجة إلى أن اقترب نموذج Anthropic من الإصدار، واستغلت الوقت لعرضها على باحثين يستطيعون شرحها. وقال Jim Halverson، الأستاذ في Northeastern الذي يستشير PSI، لـ TechCrunch: «أفضل الممارسات ما زالت في طور التشكّل».
الادعاء الخامس: العلماء على وشك أن تحل الآلة محلهم
الحكم: غير مثبت، وأعلى الادعاءات صوتًا تأتي ممن له مصلحة فيها.
قال Turturean لـ TechCrunch: «أتقبّل تمامًا فكرة أن هذه قد تكون آخر ورقة أنشرها». وقال Pines إنه قبل ستة إلى تسعة أشهر، حين كان يحدّث المستثمرين، «اضطر إلى نوع من المبالغة» ليقول إن الفيزياء النظرية ستصبح قريبًا في معظمها من اختصاص الآلات، وإنها «لم تصل بعد». ويقول استطلاع Anthropic إن نحو 40% من 528 باحثًا يتوقعون أن ينفذ الذكاء الاصطناعي مشاريع بحثية كاملة بنفسه بحلول 2030، لكنهم جُنِّدوا من المتقدمين لبرامج منح AI for Science التابعة لـ Anthropic نفسها، فالأرجح أنهم أكثر استخدامًا للذكاء الاصطناعي من غالبية الباحثين (Anthropic).
الأرقام المبنية على النمذجة أصغر. فنمذجة Anthropic تقول إن القدرات الحالية، لو اعتُمدت على نطاق واسع، يمكن أن تتولى من 27 إلى 52% من وقت الباحثين اللازم لدراسة جديدة، ما يعني ارتفاع الإنتاج بمعدل 1.35 ضعف في الفنون وصولًا إلى 2.02 ضعف في الإحصاء. أما السيناريو الافتراضي في التقرير، حيث يؤتمت الذكاء الاصطناعي كل العمل غير المادي، فيصل إلى نحو 15 ضعفًا في الإحصاء وعلوم الحاسوب، لكنه لا يتجاوز 3 إلى 4 أضعاف في علوم المختبر كالأحياء والكيمياء، حيث تبقى الخطوات المادية هي الاختناق. وهذا سيناريو، لا قياس. وحتى الحالة المتواضعة تغيير كبير لأي مجال. لكنه ليس استبدالًا، ويشير التقرير إلى أن عمل الذكاء الاصطناعي اليوم مساعد أو مشترك في معظمه. وفي مسألة من ينال الفضل، يصوغها Schwartz أفضل مما نستطيع: فهي «لن تُحسم بالتظاهر بأن إسهام الإنسان كان الكتابة على لوحة المفاتيح».
الادعاء السادس: إذا طابق نموذج الذكاء الاصطناعي البيانات فقد فهمنا المنظومة
الحكم: خاطئ، والمؤلفون الذين يبنون هذه الأنظمة يقولون ذلك.
تدوينة ضيف من مجموعة في Tübingen (Jakob Macke وDaniel Gedon وStefan Wahl، وجميعهم من المستفيدين من منح AI for Science لدى Anthropic) عن تعليم الذكاء الاصطناعي بناء النماذج العلمية تعرض الحجة بعناية. فنماذج كثيرة تطابق البيانات نفسها، لذا فإن المخرج المفيد هو طيف من النماذج المعقولة وقائمة بما تتفق عليه (Anthropic). ويقرّون بأن هذه الأنظمة «اختُبرت في معظمها على إعادة اكتشاف نماذج يعرفها العلماء أصلًا»، مع أدلة شحيحة في المسائل التي لا جواب معروفًا لها. ويكتبون: «نظام ذكاء اصطناعي يكتفي بتسليمك النموذج قد يعطيك جوابًا، لكنه لا يعطيك فهمًا».
نرى أن هذه الجملة الأخيرة ينبغي أن تُعلّق فوق كل طاولة مختبر وكل مكتب طالب. المطابقة رقم. أما التفسير فهو شيء يستطيع الإنسان أن يستخدمه ليتنبأ بما سيحدث بعد ذلك.
روتين للباحثين والطلاب
لا شيء مما سبق يقول لا تستخدموا هذه الأدوات. فبيانات الاستخدام لدى Anthropic تشير إلى أن العلماء يستخدمونها فعلًا حيث تعمل بأفضل صورة، أي في التحليل والكتابة غالبًا. وهذا هو الروتين الذي كنا سنتبعه، مبنيًا على ما أخفق في الحالات أعلاه.
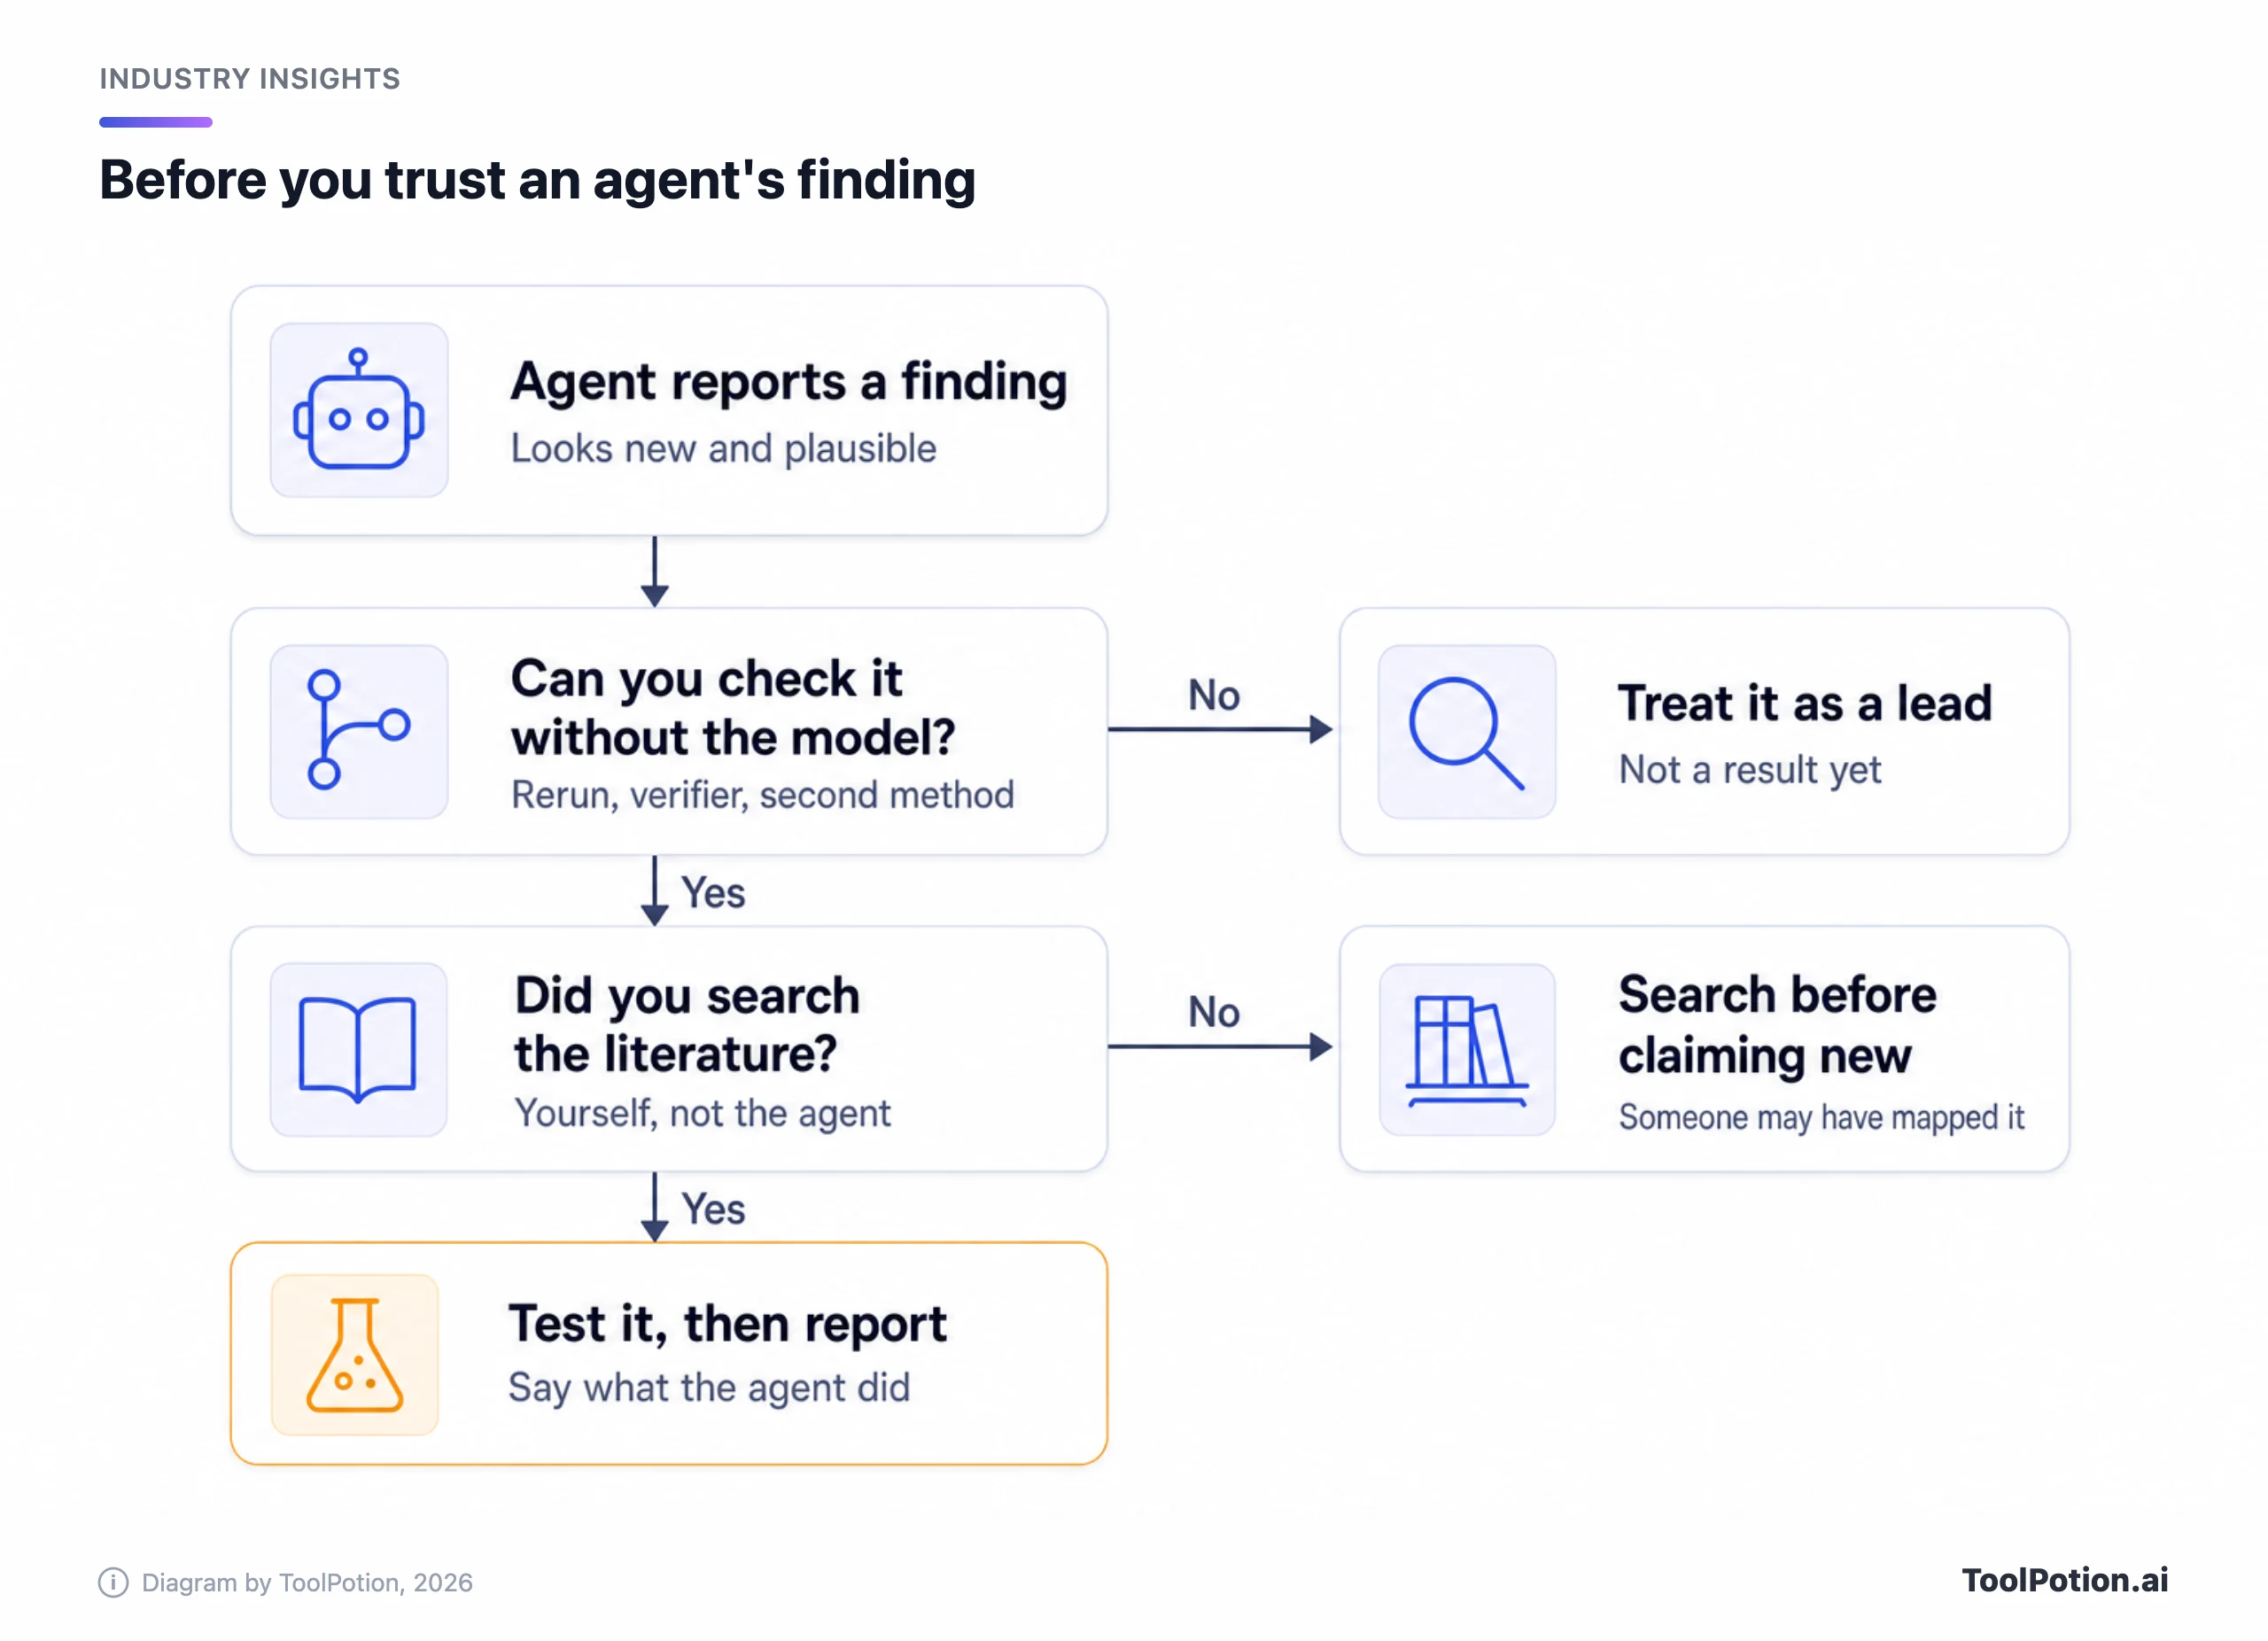
- أسندوا إلى الوكلاء عملًا تستطيعون التحقق من مخرجاته بأنفسكم: تحليل البيانات، ونقل الشيفرة بين اللغات، وفرز الأوراق أو الصور. Claude Code وClaude Cowork مصممان لهذا النوع من المهام، ويغطي مقارنتنا لوكلاء البرمجة عبر الطرفية الساحة كلها.
- قرروا قبل أن تبدؤوا ما الذي يُعد فحصًا ومن سيجريه. وليس النموذج نفسه. بل مدقق صوري، أو تحليل ثانٍ، أو تجربة مخبرية، أو زميل.
- حين يقول الوكيل إن شيئًا ما جديد، ابحثوا في الأدبيات بأنفسكم. أداة مخصصة مثل Elicit أو Consensus أو SciSpace أو ResearchRabbit تستغرق دقائق، وحالة المايا تُظهر ثمن تجاوز هذه الخطوة. وفي ترتيبنا لمساعدي البحث بالذكاء الاصطناعي قائمة أطول.
- أبقوا الخطوة المادية بشرية وموثّقة. فإذا اعتمدت نتيجة ما على قياس أو عينة أو زيارة موقع، فهناك تحديدًا تُختبر.
- اذكروا ما فعله الوكيل حين تكتبون البحث، وما تحققتم منه أنتم. Schwartz صريح في أن إسهام الإنسان لم يكن الكتابة على لوحة المفاتيح.
- للطلاب: ابنوا نماذجكم الأولى بأنفسكم. يكتب مؤلفو Tübingen أن «عملية البناء نفسها هي التي تمنح البصيرة». استخدموا الوكيل لينتقد نموذجكم، لا ليسلّمكم نموذجًا جاهزًا.
إن كنتم تريدون المثال الأقدم والأكثر اختبارًا على قيام الذكاء الاصطناعي بعمل في علم الأحياء، فما زال AlphaFold، الذي يتنبأ ببنى تختبرها المختبرات بعد ذلك. وللعمل على الأدبيات والبحث بأسلوب الوكلاء هناك أيضًا Edison Scientific، وScientific Agent Skills لتجهيز وكلائكم الخاصين، ولوحة أفضل 250 أداة ذكاء اصطناعي للباحثين. أما المساعدون العامون فيضع ChatGPT vs Claude vs Gemini أداة ChatGPT أمام منافسَيها الرئيسيين، بينما تصنّف لوحتا مساعدي البحث بالذكاء الاصطناعي ووكلاء الذكاء الاصطناعي الأدوات المتخصصة.
أين نستقر، وما الذي سيغيّر رأينا
الحقيقي: الوكلاء اليوم محللون ومهندسون مفيدون لا يكلّون. نماذج الإلكترونيات الأولية تعمل، والخيط الإنزيمي مثير للاهتمام، والبرهان الذي يفحصه Lean من نموذج نتيجة حقيقية، أيًّا كان من سيفهمه أولًا. وتكاملات Schwartz الخمسة عشر الجديدة نتائج حقيقية في مجال ضيق.
المبالغة: الاستقلالية، وكلمة «مُتحقَّق منه» حين تُستخدم بتساهل، وموجة قادمة من العلماء الآليين. فتقريبًا كل نتيجة مبهرة أعلاه فيها إنسان في الحلقة يؤدي الجزء الذي يحسم صحتها، والبشر أنفسهم يقولون ذلك. ونود كذلك أن تطبع المختبرات التكلفة بالدولار بجانب درجة المعيار. فالأرصدة وعدد الـ token يخفيان ما يكلفه الاكتشاف، و210 ملايين token لبحث إنزيمي واحد رقم يهتم به أي مختبر يدير ميزانية.
أمران قد يغيّران موقفنا. الأول أن يقرأ رياضيون من خارج لجنة OpenAI شيفرة Lean الخاصة بمسألة يانغ–ميلز ويبلّغوا بأنهم فهموها. والثاني نسخة محكَّمة من العمل الإنزيمي تذكر ما الذي يفعله النظام. وإلى ذلك الحين نعدّ كليهما واعدًا وغير مكتمل.