跳转到主要内容
ToolPotion
AI 顾问
提交(免费)

WeVisOne-VL

WeVisOne-VL 是腾讯公司微信视觉团队开发的统一视觉语言模型。它集成了对象级和像素级感知,适用于对象检测和图像抠图等任务,旨在用于研究目的。

访问URL
分享
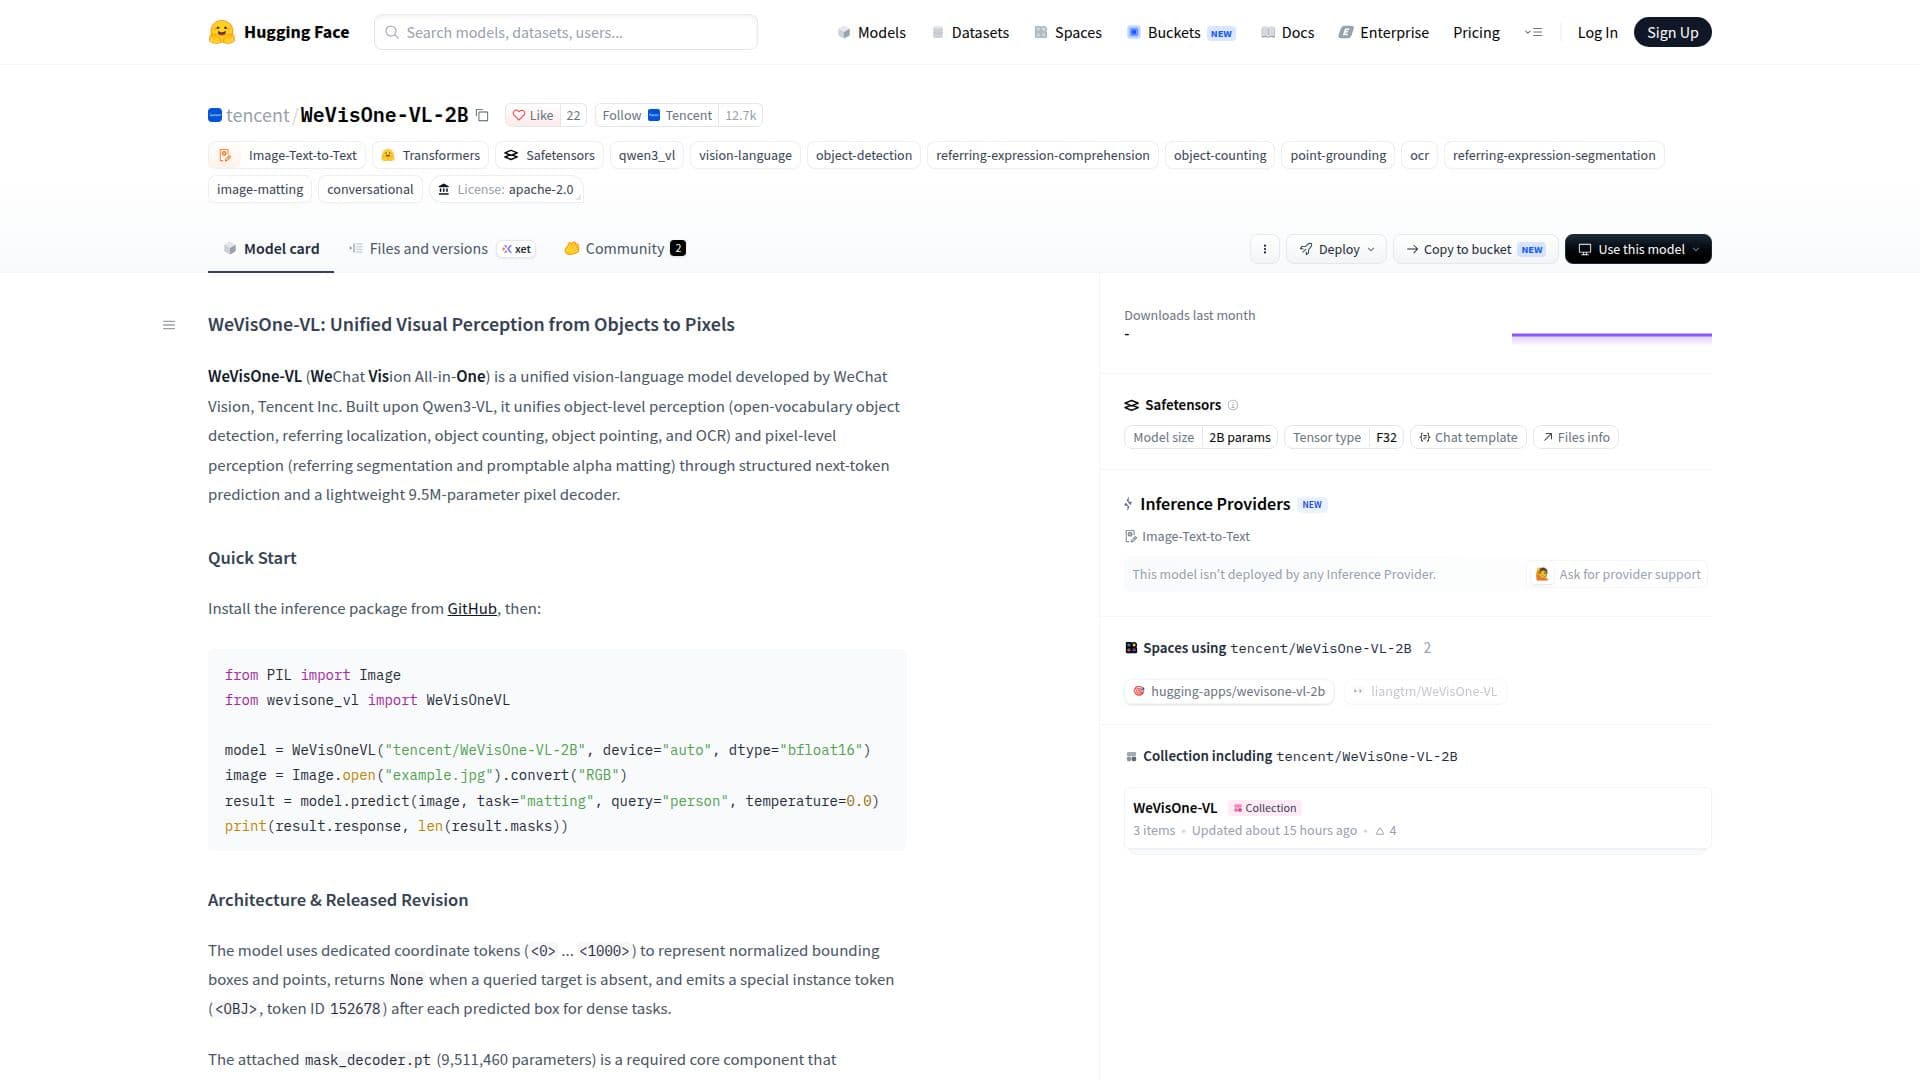
WeVisOne-VL 截图
WeVisOne-VL 截图

WeVisOne-VL 是腾讯公司微信视觉团队开发的复杂视觉语言模型。该模型基于 Qwen3-VL 框架构建,旨在统一对象级和像素级感知任务。它能够处理开放词汇的对象检测、引用定位、对象计数、对象指向和光学字符识别(OCR)。此外,它还支持像素级任务,如引用分割和可提示的 alpha 抠图。

阅读更多

该模型采用结构化的下一个标记预测,并具有 950 万参数的轻量级像素解码器。WeVisOne-VL 的一个关键组件是 mask_decoder.pt,它集成了视觉特征适配器、框引导查询解码器和实例条件密集预测头。这些组件共同工作,以优化预测并输出高分辨率的 alpha 抠图。

WeVisOne-VL 旨在用于视觉基础、定位、指向、计数、OCR、分割和图像抠图等研究应用。它并不设计用于自主决策或个体识别。该模型针对单轮图像感知进行了优化,不支持视频网格。

该模型根据 Apache 许可证 2.0 发布,第三方组件保留其原始许可证。鼓励用户查看源文件以获取具体的许可详情。

  • 类别计算机视觉工具
  • 定价模式开源
  • 部署云端
  • 平台网页版

  • 统一视觉语言模型

  • 对象级感知

  • 像素级感知

  • 开放词汇对象检测

  • 引用分割

  • 可提示的 alpha 抠图

  • 结构化下一个标记预测

  • 轻量级像素解码器

  1. 访问模型页面:访问 Hugging Face 模型页面

  2. 身份验证:登录到您的 Hugging Face 账户

  3. 配置:设置模型及必要参数

  4. 发送提示:输入您的视觉数据进行处理

  5. 微调:调整模型设置以适应特定任务

  • 视觉基础
  • 对象检测
  • 图像抠图
  • OCR 定位
  • 引用分割

与 WeVisOne-VL 类似的热门AI工具

Qwen2-VL-7B-Instruct 是一个先进的人工智能模型,旨在实现视觉理解和多语言支持。它在处理图像和视频方面表现出色,在各种基准测试中提供了最先进的性能。该模型支持与设备的集成,以便根据视觉和文本输入进行自动化操作。

计算机视觉工具
查看工具

先进的人工智能模型,旨在实现视觉理解和多语言支持。它在处理图像和视频方面表现出色,在各种基准测试中提供了最先进的性能。该模型支持与设备的集成,以便根据视觉和文本输入进行自动化操作。Qwen2-VL-7B-Instruct 是一个先进的人工智能模型,旨在实现视觉理解和多语言支持。它在处理图像和视频方面表现出色,在各种基准测试中提供了最先进的性能。该模型支持与设备的集成,以便根据视觉和文本输入进行自动化操作。

计算机视觉工具
查看 AI 模型 Top 5

CLIP ViT-B/32

AI 模型

OpenAI 的 clip-vit-base-patch32 模型旨在进行零样本图像分类任务。它利用视觉变换器架构增强计算机视觉的鲁棒性和泛化能力,是 AI 研究人员的重要资源。

计算机视觉工具
查看工具

AI 模型

OpenAI 的 clip-vit-base-patch32 模型旨在进行零样本图像分类任务。它利用视觉变换器架构增强计算机视觉的鲁棒性和泛化能力,是 AI 研究人员的重要资源。

精选计算机视觉工具
查看 AI 模型 Top 5

Florence-2 是微软开发的先进视觉基础模型,旨在处理各种视觉和视觉语言任务。它采用基于提示的方法来处理诸如图像描述和物体检测等任务,利用庞大的数据集进行多任务学习。

AI 模型与大语言模型
查看工具

微软开发的先进视觉基础模型,旨在处理各种视觉和视觉语言任务。它采用基于提示的方法来处理诸如图像描述和物体检测等任务,利用庞大的数据集进行多任务学习。Florence-2 是微软开发的先进视觉基础模型,旨在处理各种视觉和视觉语言任务。它采用基于提示的方法来处理诸如图像描述和物体检测等任务,利用庞大的数据集进行多任务学习。

AI 模型与大语言模型
查看 AI 模型 Top 5

Qwen-VL

AI GitHub 仓库

Qwen-VL 是由阿里云开发的大型视觉语言模型。它为聊天和视觉任务提供了先进的能力,为这些领域的 AI 应用提供了强大的平台。

AI 模型与大语言模型
查看工具

AI GitHub 仓库

由阿里云开发的大型视觉语言模型。它为聊天和视觉任务提供了先进的能力,为这些领域的 AI 应用提供了强大的平台。Qwen-VL 是由阿里云开发的大型视觉语言模型。它为聊天和视觉任务提供了先进的能力,为这些领域的 AI 应用提供了强大的平台。

AI 模型与大语言模型
查看 AI GitHub 仓库 Top 250

计算机视觉工具箱提供用于设计和测试计算机视觉系统的算法和应用,包括视觉检查、物体检测和特征匹配。它支持诸如卷积神经网络(CNN)和视觉变换器等人工智能技术,用于图像分类和分割等任务。

计算机视觉工具
查看工具

提供用于设计和测试计算机视觉系统的算法和应用,包括视觉检查、物体检测和特征匹配。它支持诸如卷积神经网络(CNN)和视觉变换器等人工智能技术,用于图像分类和分割等任务。计算机视觉工具箱提供用于设计和测试计算机视觉系统的算法和应用,包括视觉检查、物体检测和特征匹配。它支持诸如卷积神经网络(CNN)和视觉变换器等人工智能技术,用于图像分类和分割等任务。

计算机视觉工具
查看 AI 应用 Top 250

Ultralytics YOLO

AI GitHub 仓库

Ultralytics YOLO 包含 YOLO26、YOLO11 和 YOLOv8,提供目标检测、实例分割、语义分割、图像分类、姿态估计和目标跟踪的能力。它专为计算机视觉领域的开发者和研究人员设计。

计算机视觉工具

AI GitHub 仓库 排名第 18 位

查看工具

AI GitHub 仓库

Ultralytics YOLO 包含 YOLO26、YOLO11 和 YOLOv8,提供目标检测、实例分割、语义分割、图像分类、姿态估计和目标跟踪的能力。它专为计算机视觉领域的开发者和研究人员设计。

精选计算机视觉工具
AI GitHub 仓库 排名第 18 位

Qwen2-VL-72B-Instruct 是一个先进的 AI 模型,旨在实现最先进的视觉理解和多语言支持。它在处理图像、视频和复杂推理任务方面表现出色,适用于 AI 驱动环境中的多种应用。

AI 模型与大语言模型
查看工具

先进的 AI 模型,旨在实现最先进的视觉理解和多语言支持。它在处理图像、视频和复杂推理任务方面表现出色,适用于 AI 驱动环境中的多种应用。Qwen2-VL-72B-Instruct 是一个先进的 AI 模型,旨在实现最先进的视觉理解和多语言支持。它在处理图像、视频和复杂推理任务方面表现出色,适用于 AI 驱动环境中的多种应用。

AI 模型与大语言模型
查看 AI 模型 Top 5

Ultralytics

AI 应用

一个端到端的计算机视觉平台,用于标注数据、训练YOLO模型并在全球范围内部署,基于广泛采用的Ultralytics YOLO开源框架构建。

计算机视觉工具制造与工业

制造与工业 排名第 6 位

查看工具

AI 应用

一个端到端的计算机视觉平台,用于标注数据、训练YOLO模型并在全球范围内部署,基于广泛采用的Ultralytics YOLO开源框架构建。

精选计算机视觉工具制造与工业
制造与工业 排名第 6 位
1/8