描述
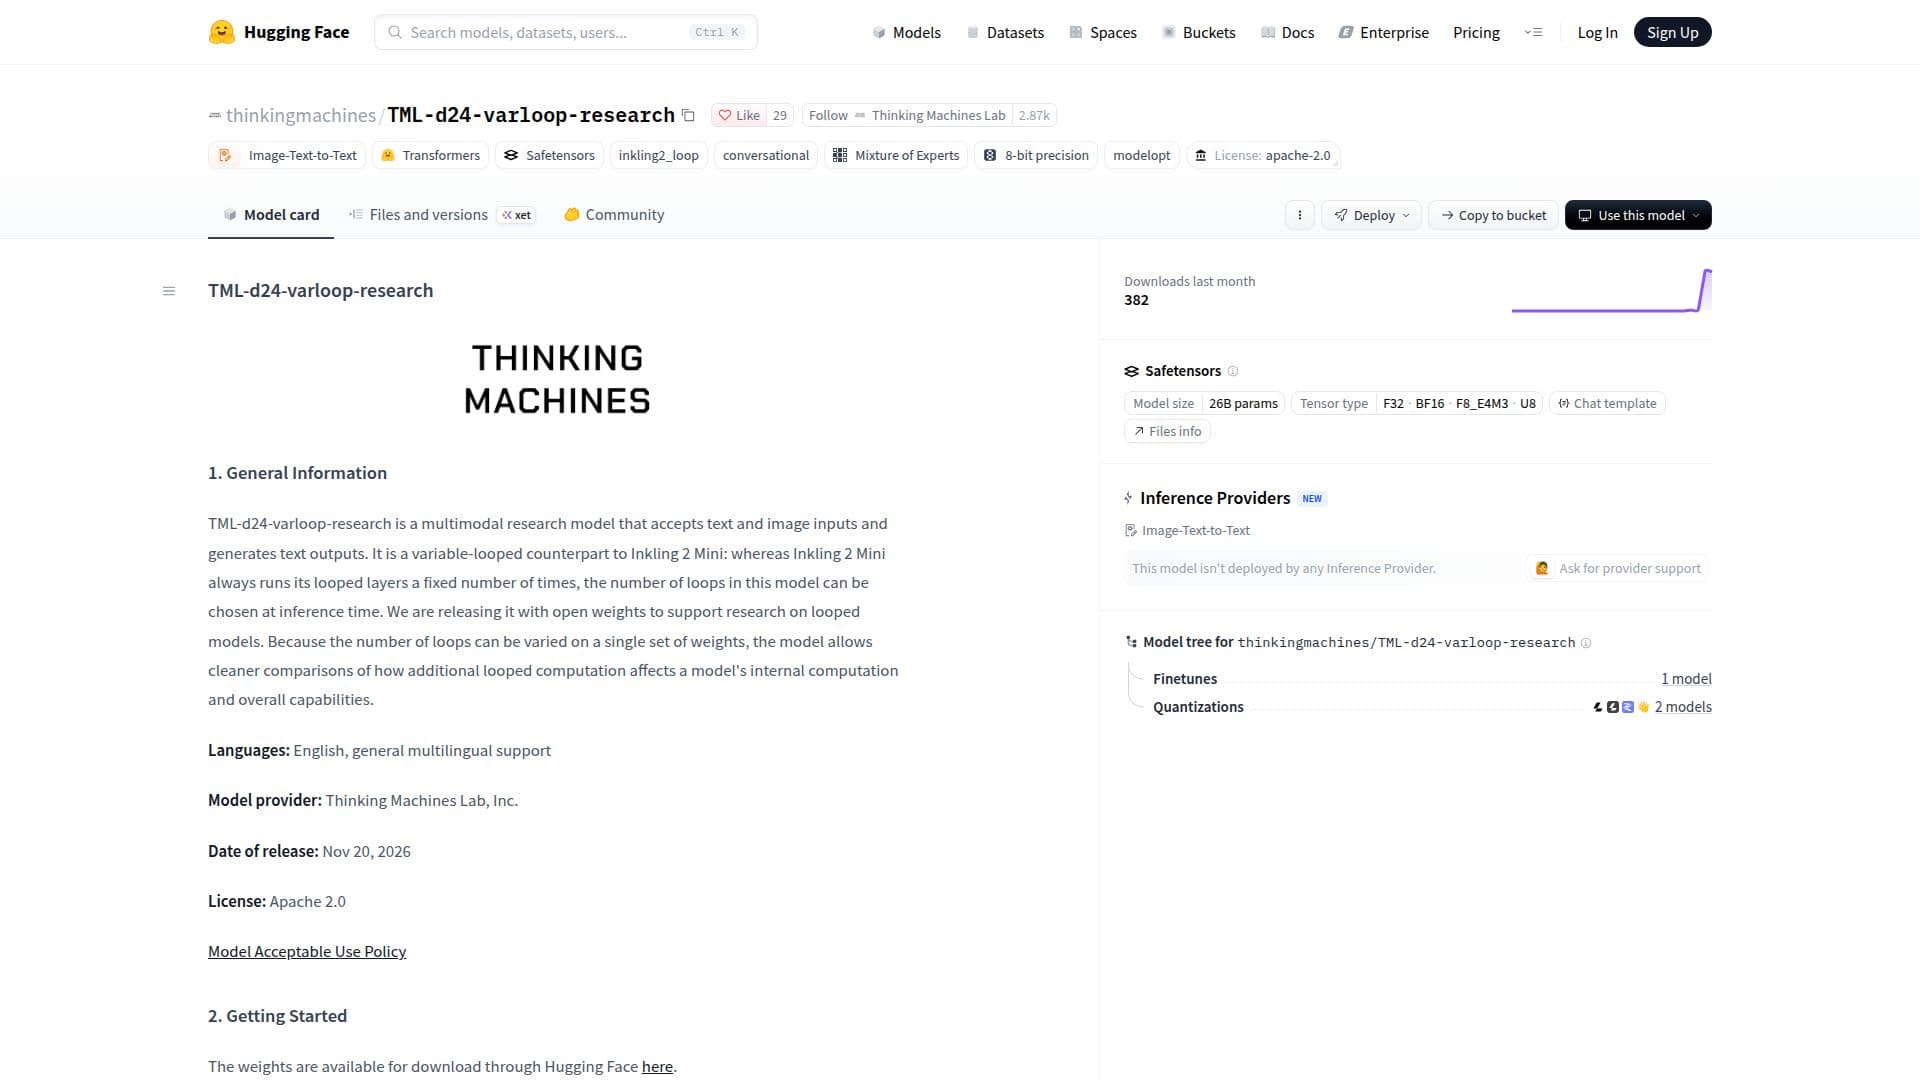
TML-d24-varloop-research 是由 Thinking Machines Lab, Inc. 开发的多模态研究模型,旨在处理文本和图像输入并生成文本输出。该模型于 2026 年 11 月 20 日在 Apache 2.0 许可证下发布,是循环模型领域的重要贡献,提供了一种与其固定循环对应物 Inkling 2 Mini 不同的可变循环架构。研究人员可以在推理过程中动态调整循环的数量,从而更清晰地比较额外计算对模型内部过程和整体能力的影响。
阅读更多
该模型通过 Hugging Face 以开放权重分发,单个检查点大小约为 20GB。它需要至少 32GB GPU 或统一内存的机器,兼容 NVIDIA DGX Spark、NVIDIA GPU(例如 GeForce RTX 5090 或 RTX PRO 6000 Blackwell)或 Apple silicon Mac 等配置。TML-d24-varloop-research 支持使用多种框架进行本地推理,包括 Hugging Face、SGLang、vLLM、TokenSpeed、NVIDIA Dynamo、Unsloth、llama.cpp、Llama App、Ollama 和 Exo Labs。它还支持与 Miles 和 SkyRL 的后训练。
在架构上,TML-d24-varloop-research 是一个 24 层的仅解码器变换器,具有稀疏的专家混合(MoE)前馈层。中间 12 层可以运行可变次数,共享权重,并经过 1 到 5 次的训练。每层将标记路由到 128 个专家中的 8 个,注意力是局部和全局层的混合。该模型本质上是多模态的,通过视觉变换器编码图像,并与文本在共享的隐藏空间中共同处理。它具有 264 亿个参数(在 1 次传递时活跃 34 亿个参数),并支持 NVFP4 和 MXFP8 数值。它处理 UTF-8 编码的文本和基于像素的图像输入(每个维度 40px 到 4096px),上下文窗口最大支持 100 万个标记。
TML-d24-varloop-research 的训练数据包括来自公开可用来源、第三方收购和内部/合成生成数据的各种内容类型。数据策划涉及清理、去重和过滤,以确保质量和安全。该模型与 Inkling 2 Mini 共享其预训练和中期训练的第一阶段,但在后期阶段分歧,特别是在其可变循环训练中,样本为 1 到 5 次。虽然评估显示与 Inkling 2 Mini 在 Agentic Coding、Vision Interpretation 和 Reasoning 等基准上的表现有所不同,但它主要作为研究文物,因其在不同传递计数下可能出现不可预测的行为以及基础模型普遍存在的局限性(如幻觉和训练数据的偏见),不建议用于生产。
- 类别AI 模型与大语言模型
- 定价模式开源
- 部署本地运行
- 平台网页版
TML-d24-varloop-research亮点
多模态输入:接受文本和图像输入
文本输出:根据输入生成文本
可变循环:推理时可以选择循环层的数量
开放权重:可下载以支持研究
264 亿参数:大规模模型,在 1 次传递时有 34 亿活跃参数
多语言支持:对多种语言的一般支持
Apache 2.0 许可证:开放源代码许可用于使用和修改
本地推理支持:兼容 Hugging Face、SGLang、vLLM、TokenSpeed、NVIDIA Dynamo、Unsloth、llama.cpp、Llama App、Ollama 和 Exo Labs
后训练支持:可以与 Miles 和 SkyRL 进行后训练
稀疏专家混合(MoE):利用 MoE 前馈层
混合注意力:结合局部和全局注意力层
原生多模态性:通过视觉变换器编码图像并与文本共同处理
高上下文窗口:支持最多 100 万个标记
混合精度数值:支持 NVFP4 和 MXFP8
TML-d24-varloop-research入门
下载权重:通过 Hugging Face 访问模型权重。
准备硬件:确保有一台至少 32GB GPU 或统一内存的机器可用。
安装软件:设置所需的推理框架,如 Hugging Face、SGLang 或 vLLM 及其依赖项。
配置模型:将 20GB 检查点加载到所选框架中。
设置循环传递:选择推理所需的循环层数量。
提供输入:向模型提供 UTF-8 编码的文本和基于像素的图像(40px-4096px 尺寸)。
生成输出:根据提供的输入从模型接收文本输出。
TML-d24-varloop-research的使用案例
- 多模态研究
- 循环模型研究
- 从图像生成文本
- 多语言文本处理
- 开放权重模型开发
- 本地推理部署
- 模型微调