描述
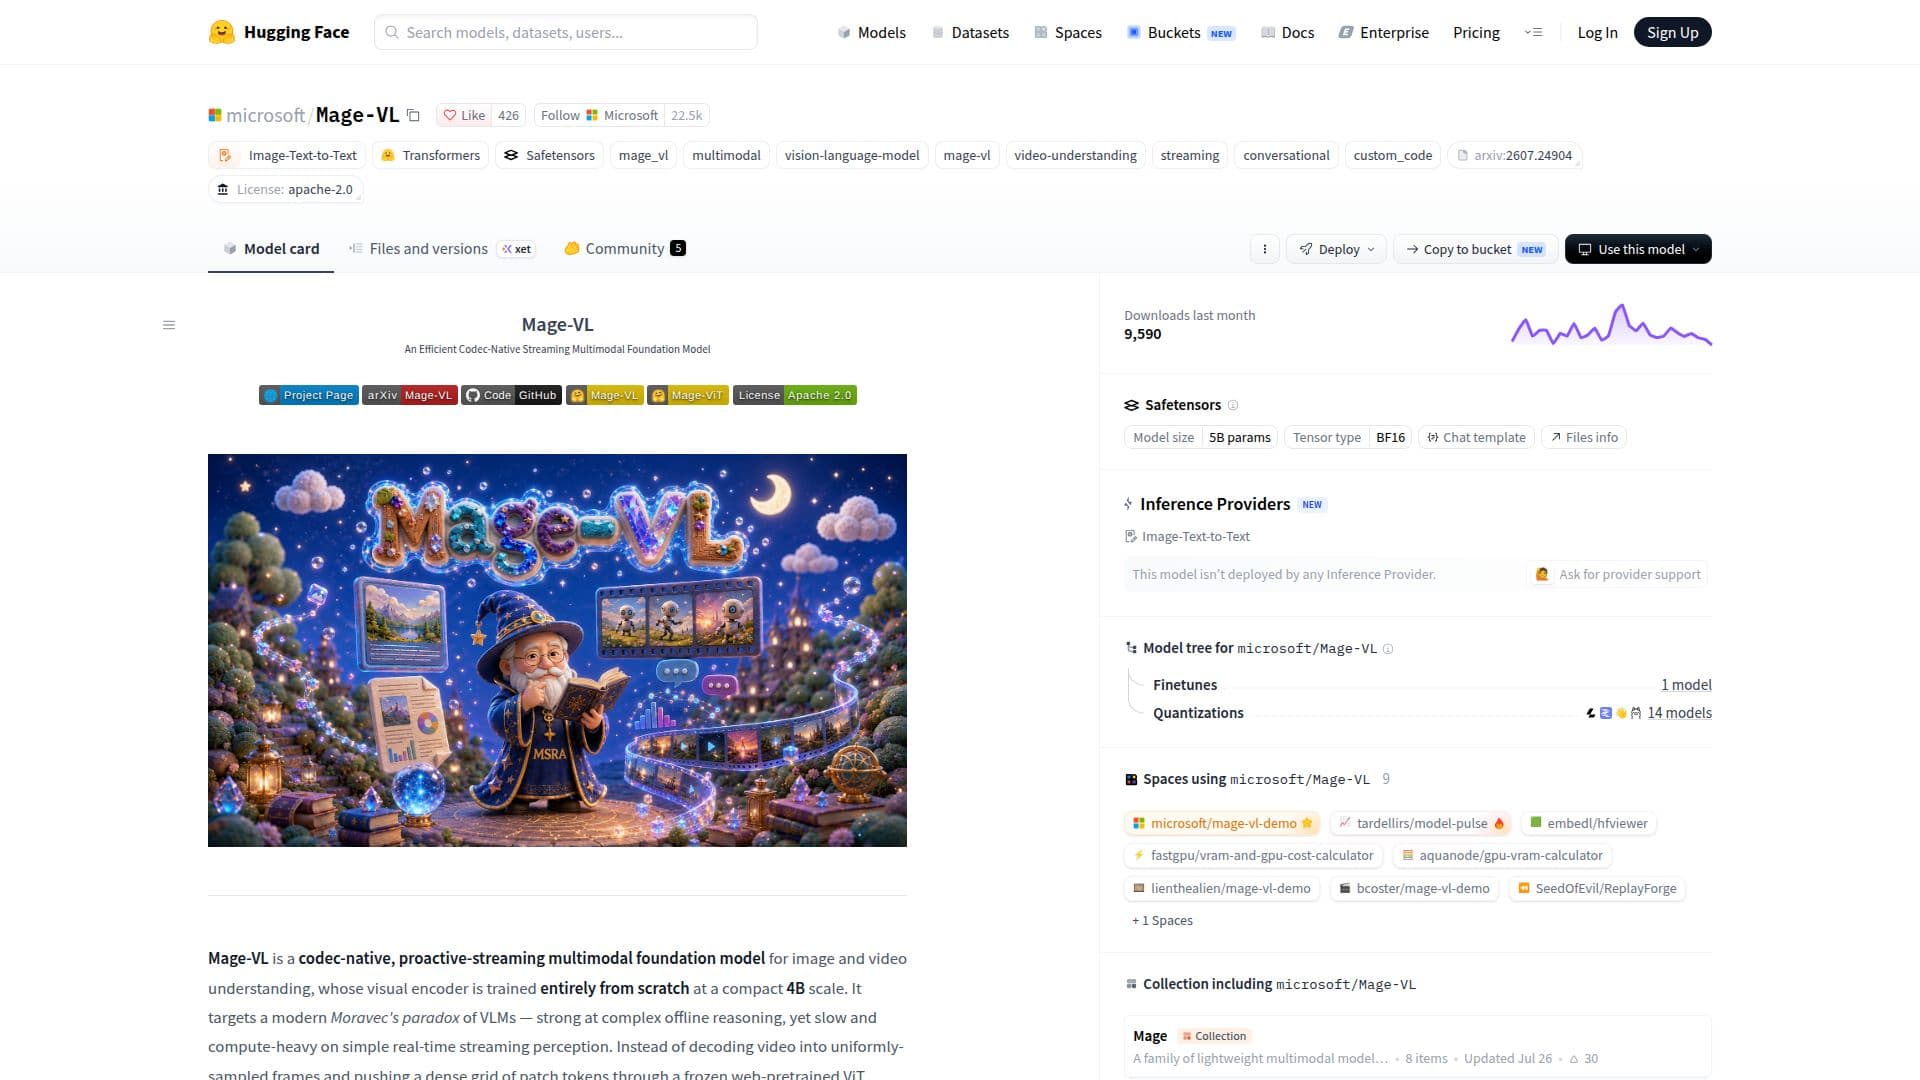
Mage-VL 是一个创新的多模态基础模型,旨在解决图像和视频理解的挑战。它被设计为一个编解码器原生的主动流媒体模型,能够高效处理视觉数据。该模型的视觉编码器 Mage-ViT 从零开始训练,并在紧凑的 4B 规模上运行。这个编码器的独特之处在于它能够根据编解码器派生的时空重要性分配令牌,使其在相同的计算预算下处理的视频长度可达八倍。
阅读更多
Mage-VL 的架构包括一个 Qwen3-4B 因果解码器,这是唯一的预训练组件。该解码器与 Mage-ViT 协同工作,以处理可变长度的令牌流,支持图像和视频的统一接口。该模型的双重处理设计包含一个认知门,能够通过监控内容并仅在必要时激活完整的视觉语言模型来实现主动流媒体。
该模型的编解码器原生方法显著减少了视觉令牌的消耗,超过 75%,与传统方法相比,推理速度提升了 3.5 倍。这种效率是在不妥协准确性的情况下实现的,使 Mage-VL 成为实时视频分析和理解的强大工具。
Mage-VL 在视频理解和空间智能方面表现尤为出色,在多个基准测试中超越了可比模型。其主动流媒体能力通过在 SoccerNet 流媒体任务中的表现得以体现,提供低延迟的事件门控评论。
总体而言,Mage-VL 代表了多模态 AI 模型的重大进步,为复杂视觉任务提供了数据高效的解决方案。其开源特性和全面的能力使其成为人工智能领域开发者和研究人员的宝贵资源。
- 类别AI 模型与大语言模型
- 定价模式开源
- 部署云端
- 平台网页版
Mage-VL亮点
编解码器原生视觉编码器
主动流媒体门
Qwen3-4B 因果解码器
3.5× 推理加速
数据高效的令牌器
可变分辨率预训练
图像和视频的统一模型
事件门控评论
Mage-VL入门
访问模型页面:访问 Hugging Face 仓库
身份验证:使用您的 Hugging Face 账户凭据
配置:设置模型参数和环境
发送提示:输入您的图像或视频数据进行处理
微调:调整模型设置以适应特定任务
Mage-VL的使用案例
- 实时视频分析
- 空间智能
- 事件门控评论
- 图像理解
- 主动流媒体