描述
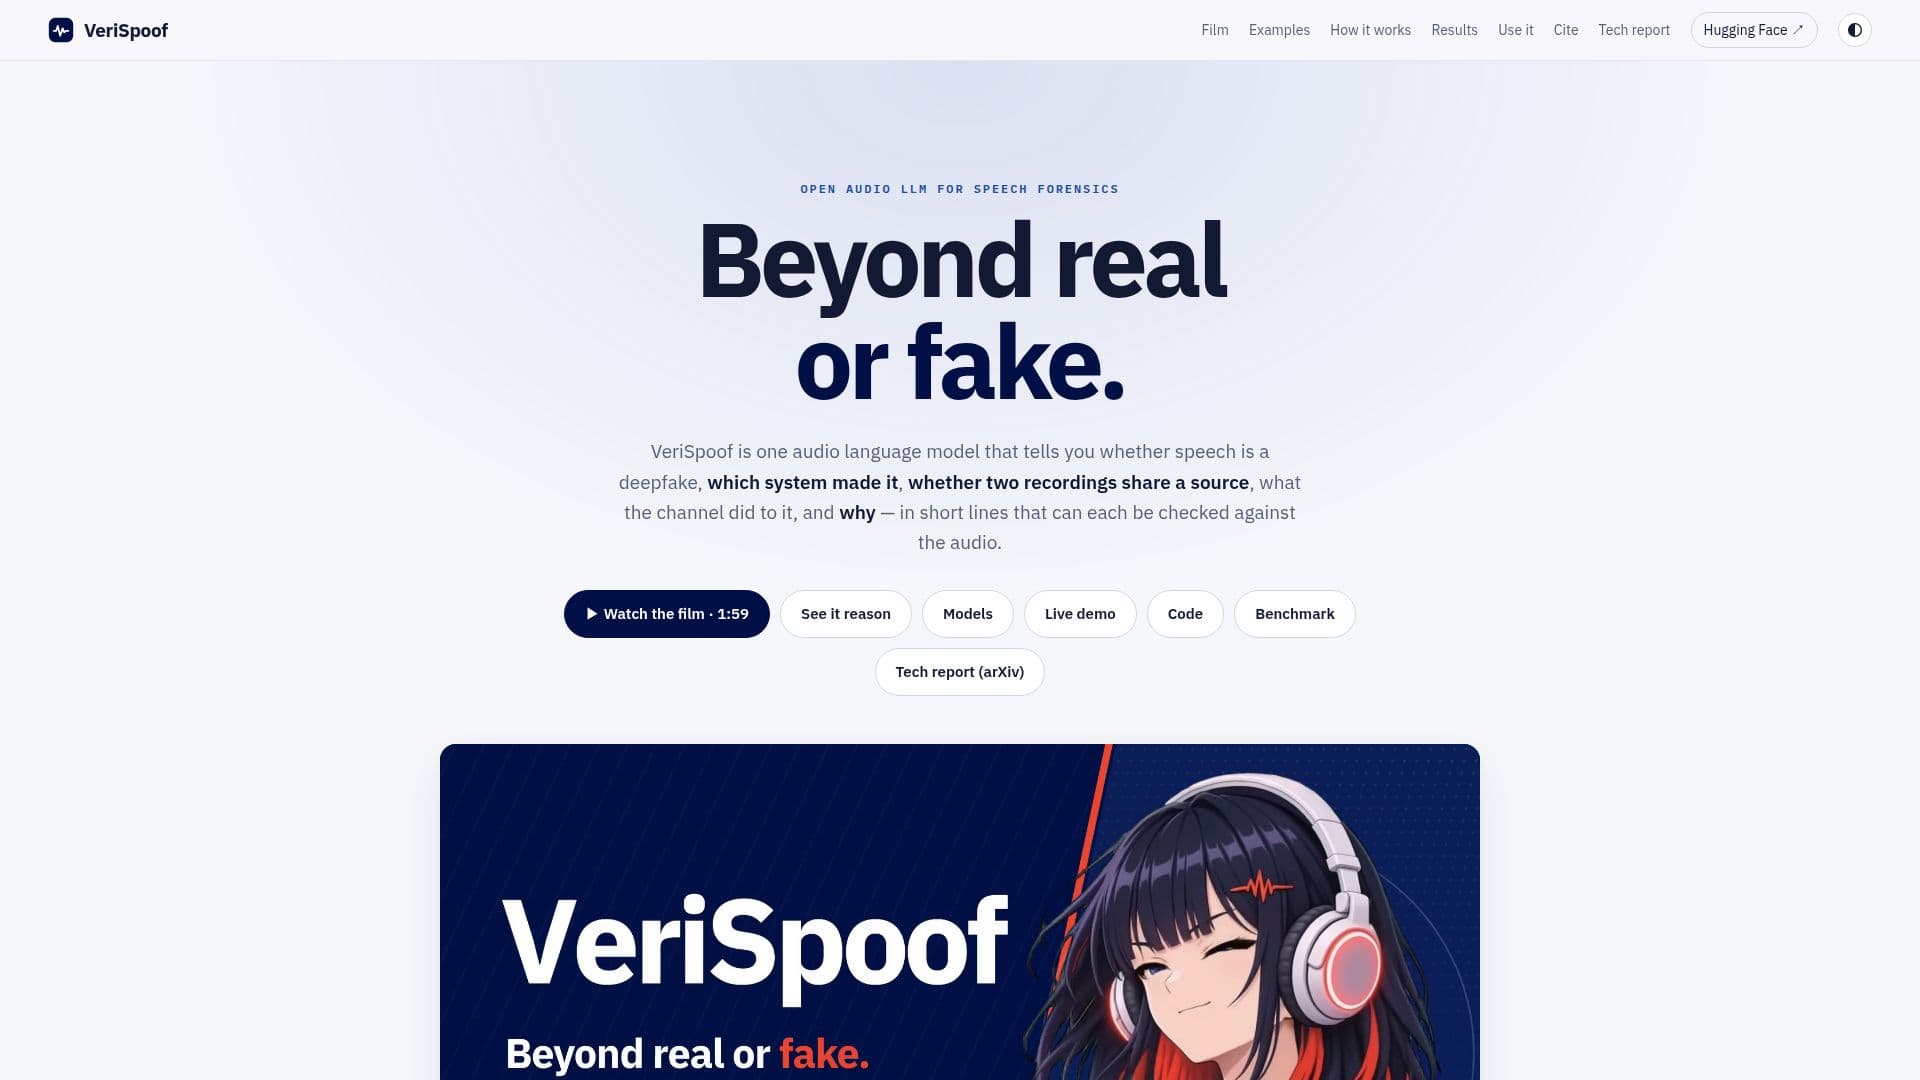
VeriSpoof 是一个开创性的音频语言模型,专为先进的语音深度伪造取证而开发。它提供了一个全面的解决方案,用于确定语音是否为深度伪造,识别生成它的系统,评估两个录音是否共享相同的来源,分析通道效应,并以透明、可验证的方式解释其结论。
阅读更多
该模型表现出色,在 14 个 Speech-DF-Arena 数据集上实现了 2.14% 的汇总等错误率(EER),使其成为排名第一的开放权重检测器。其架构围绕一个音频 LLM(大型语言模型)构建,将录音处理为发声和帧标记,然后由带有 LoRA 的 MiniCPM5-2B 模型读取。与传统系统不同,VeriSpoof 不依赖于单独的任务头;相反,每个答案都是一个句子,其可能性直接作为分数,从而允许在任何操作点灵活设定阈值。
VeriSpoof 的基础是其核心优势,每一条推理都独立检查与波形测量、记录条件、标记范围和生成器元数据的对应关系。这确保了观察结果、通道状态、合成片段的定位和来源档案得到了严格验证。该系统还结合了反事实训练,即使在故意反转定位的情况下,决策也经过训练以遵循所述证据,从而确保了稳健且逻辑一致的推理。
VeriSpoof 主要用于深度伪造检测、来源追踪和可解释取证的研究,提供了审计音频裁决的强大工具。建议将其分数与其他证据和人工审查结合,以做出最终的取证决策。该项目包括基础模型和增强模型,VeriSpoof-Plus 在各种评估指标和数据集上表现优越。VeriSpoof 的权重和代码在 CC BY-NC 4.0 许可下发布,而其基础模型 MiniCPM5-2B 和 Qwen3-ASR-1.7B 则在 Apache-2.0 下运行。
- 类别AI内容检测工具
- 定价模式Free (Open-Weight)
- 部署Local (Inference Package)
- 平台Windows, macOS, Linux
VeriSpoof的核心功能
语音深度伪造检测:识别语音是否为深度伪造。
来源验证:确定哪个系统生成了深度伪造。
来源归属:确认两个录音是否来自同一生成器。
通道描述:分析并描述通道对音频的影响。
可解释的决策:提供简短、可验证的语句解释其结论。
扎实的推理:每个声明都与波形测量和数据集标签进行核对。
高准确性:在 Speech-DF-Arena 上实现了 2.14% 的汇总 EER,排名第一。
统一音频 LLM:一个模型处理所有取证问题,无需单独的任务头。
基于分数的答案:答案是句子,其可能性作为分数。
反事实测试:允许替换所述定位以重新评估决策。
离线推理:支持离线运行真实测试录音。
开放权重模型:可用于研究和开发。
多语言字幕:电影演示包括中文和英文字幕。
研究导向:旨在进行深度伪造检测、来源追踪和可解释取证研究。
可审计的裁决:四条线索构成的裁决可以被审计。
如何使用 VeriSpoof?
输入音频:向模型提供单个音频录音或一对录音。
使用 LLM 处理:音频组件将输入转换为发声和帧标记供 LLM 使用。
接收一步答案:立即获得有关深度伪造状态或来源相似性的答案。
审查扎实的推理:检查模型决策的详细逐行解释。
验证声明:检查推理中的每个声明与波形测量和数据集标签的对应关系。
进行反事实测试:可选地,修改定位等参数并重新运行模型以观察决策变化。
VeriSpoof的使用案例
- 深度伪造检测研究
- 音频来源追踪
- 可解释取证
- 音频通道分析
- 合成语音分析
- 深度伪造检测器基准测试