描述
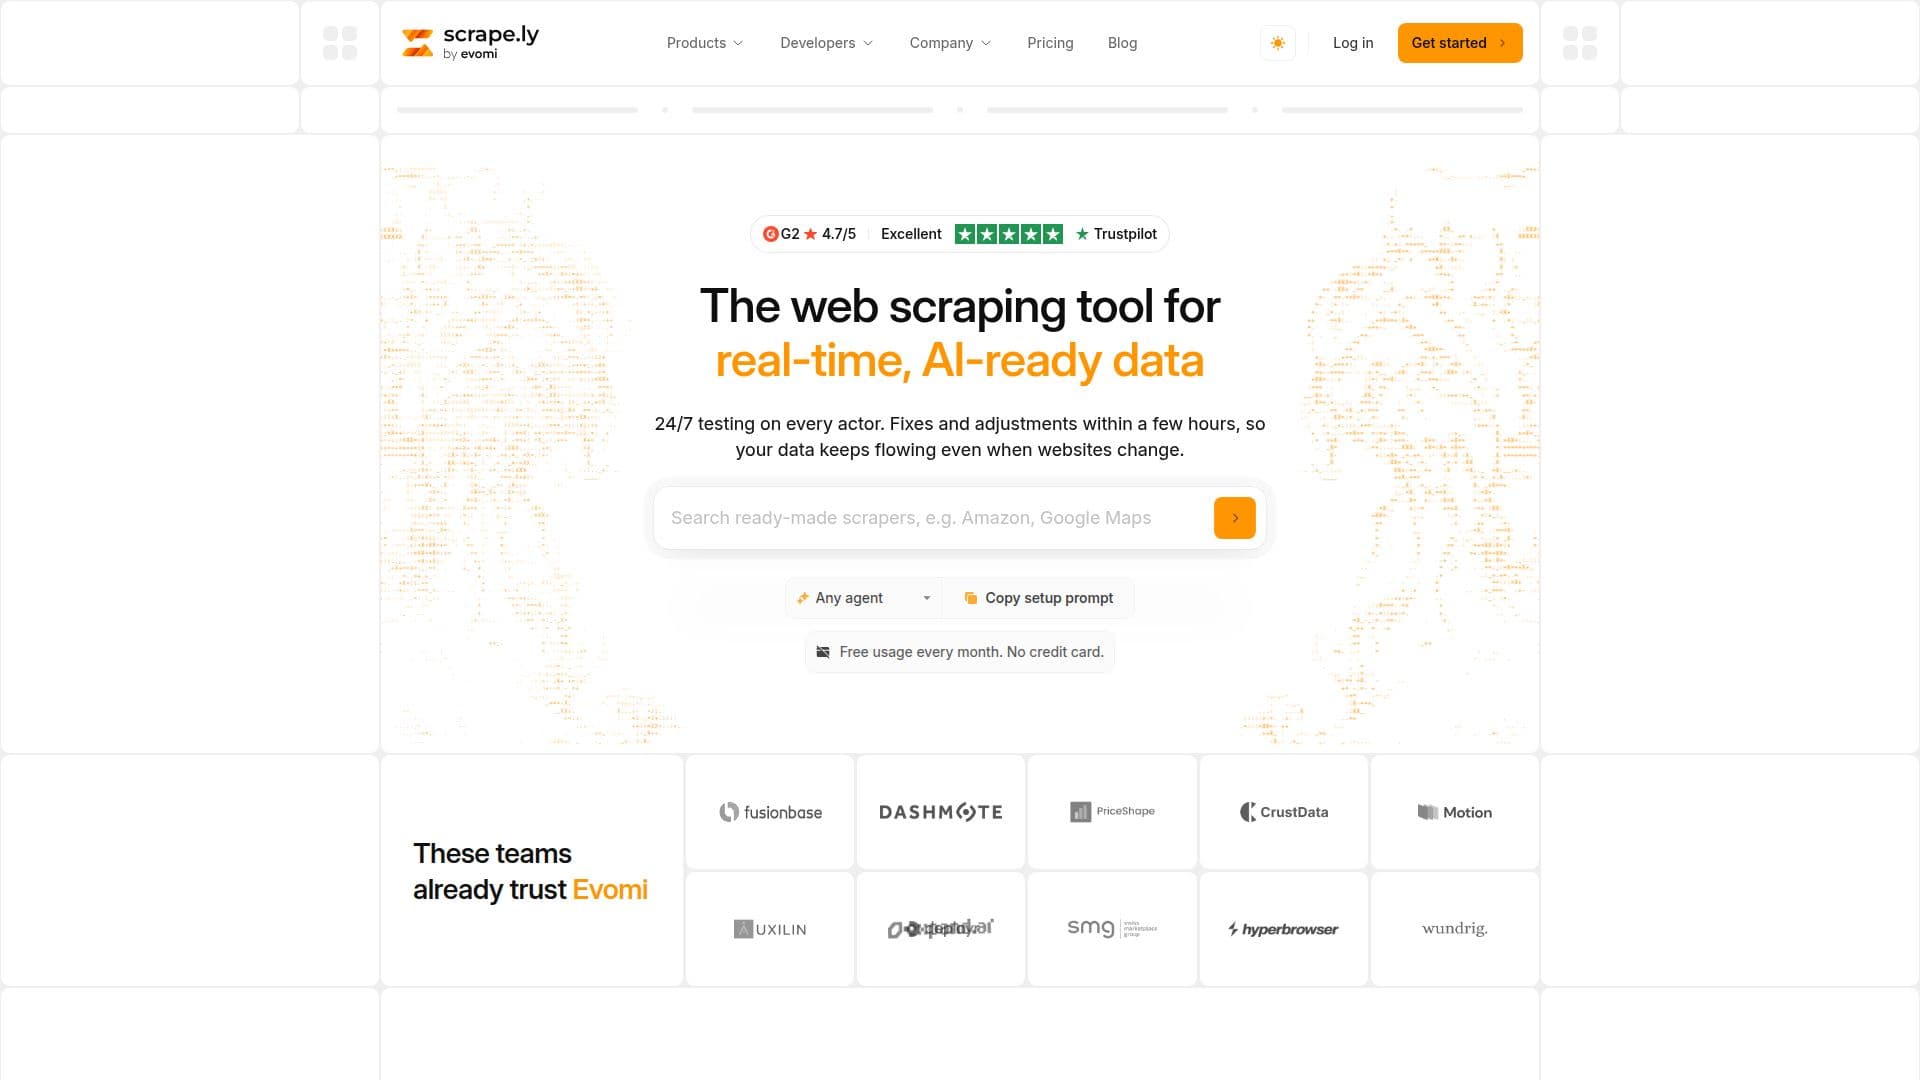
Scrape.ly 提供了一种全面的网络爬虫工具和平台,旨在提供实时、适合 AI 的数据。它提供了一个庞大的库,包含超过 600 个现成的爬虫,适用于 Google Maps、Amazon、LinkedIn、TikTok 和 YouTube 等主要平台,涵盖社交媒体、电子商务、地图、新闻和金融。这些爬虫可以一键运行,无需编写代码,提取的数据可以通过 API 或 MCP 以 JSON、CSV、Excel 和其他格式获取。
阅读更多
对于有独特数据提取需求的用户,Scrape.ly 提供了一个云环境,用于构建、测试和部署定制的爬虫管道。该完全托管的服务按需扩展,消除了基础设施管理的负担。此外,Scrape.ly 的数据工程团队可以为客户规划、构建和维护定制提取工作流,使他们的团队能够专注于利用数据,而不是获取数据。
该平台通过对每个 Actor 进行 24/7 测试和在网站更改后几小时内快速修复,确保数据流的连续性。它支持高级数据管道集成,允许将抓取的数据 POST 到 URL,触发其他 Actors,或在完成后启动保存的任务。AI 代理还可以通过 MCP 服务器运行 Actors,从而增强自动化能力。
Scrape.ly 支持使用 JavaScript 或 TypeScript 的开源开发,提供用于从自定义代码运行 Store Actors 的 API 客户端。该平台还设有一个市场,开发者可以免费发布他们的 Actors,按事件收费,并获得用户支付的 80% 收入,Scrape.ly 通过加密货币、PayPal 或银行转账管理账单和支付。
定价采用预付余额系统,免费层提供每月信用和对所有核心功能的访问。付费计划增加限制并提供额外信用,选项包括并发运行、内存和存储保留。Scrape.ly 与众多工具集成,包括通过 MCP 的 AI 代理如 Claude、ChatGPT 和 Cursor,以及 Google Sheets、Airtable、HubSpot、Salesforce、Notion、Dropbox、OneDrive、Amazon S3、Azure Blob Storage、OpenAI Vector Store、BigQuery、Snowflake 和 Postgres 进行数据导出。它还支持 Webhook、计划、GitHub 集成以及各种开发者工具,如 REST API、JavaScript/Python 客户端、SDK 和 CLI。
- 类别网页抓取与数据提取
- 定价模式免费增值
- 部署云端
- 平台网页版
Scrape.ly的核心功能
600+ 个现成的爬虫:浏览并运行适用于 Google Maps、Amazon、LinkedIn、TikTok 和 YouTube 等主要平台的预构建爬虫。
定制爬虫开发:在完全托管的云环境中构建、测试和部署定制爬虫管道。
托管数据工程服务:Scrape.ly 的团队可以构建和维护定制提取工作流。
实时数据交付:通过 24/7 测试和对网站更改的快速调整,确保数据流的连续性。
灵活的数据输出格式:以 JSON、CSV、Excel、JSONL、XML、RSS、HTML 或 PDF 格式获取数据。
API 访问:通过 REST API 程序化运行爬虫、管理作业并获取结构化结果。
开发者客户端:官方 JavaScript/TypeScript 和 Python 客户端,以及用于集成到自定义代码中的 CLI。
托管代理池:利用住宅和数据中心 IP 减少封锁并避免速率限制。
云基础设施:处理扩展、代理管理、正常运行时间和存储,以确保可靠操作。
开源工具:使用 JavaScript 或 TypeScript 的 Crawlee 模板开始。
Actor 市场:发布和货币化定制爬虫,赚取用户支付的 80%。
预付费计费模式:仅为您运行的内容付费,无意外账单,并能够限制运行成本。
免费层可用:每个账户都以免费每月信用和对核心功能的访问开始。
AI 代理集成:与 Claude、ChatGPT、Cursor 和其他 MCP 客户端连接以获取实时网络数据。
广泛的集成:将结果推送到 Google Sheets、Airtable、HubSpot、Salesforce、Notion、Dropbox、OneDrive、S3、Azure Blob Storage、OpenAI Vector Store、BigQuery、Snowflake 和 Postgres。
如何使用 Scrape.ly?
创建账户:注册一个免费的 Scrape.ly 账户,以开始使用每月的使用信用。
选择爬虫:浏览现成爬虫的库,或为您的特定需求开发一个定制爬虫。
配置输入:提供所选爬虫所需的输入参数,例如 URL 或搜索查询。
运行爬虫:通过单击或通过 API/CLI 在云中执行爬虫。
监控进度:跟踪您的爬虫作业状态,并在完成时接收警报。
获取结果:以您喜欢的格式(JSON、CSV、Excel 等)下载结构化数据,或将其推送到集成平台。
自动化工作流:设置计划、Webhook 或链式 Actors 以自动化数据管道。
Scrape.ly的使用案例
- 市场研究
- 潜在客户生成
- 内容聚合
- 价格监控
- AI 模型训练数据
- 房地产数据收集
- 学术研究
- 商业智能
- 社交媒体监控
- 自动化数据管道