跳转到主要内容
ToolPotion
AI 顾问
提交(免费)

Redditapis

AI 应用网页抓取与数据提取按通话计费 · 网页版

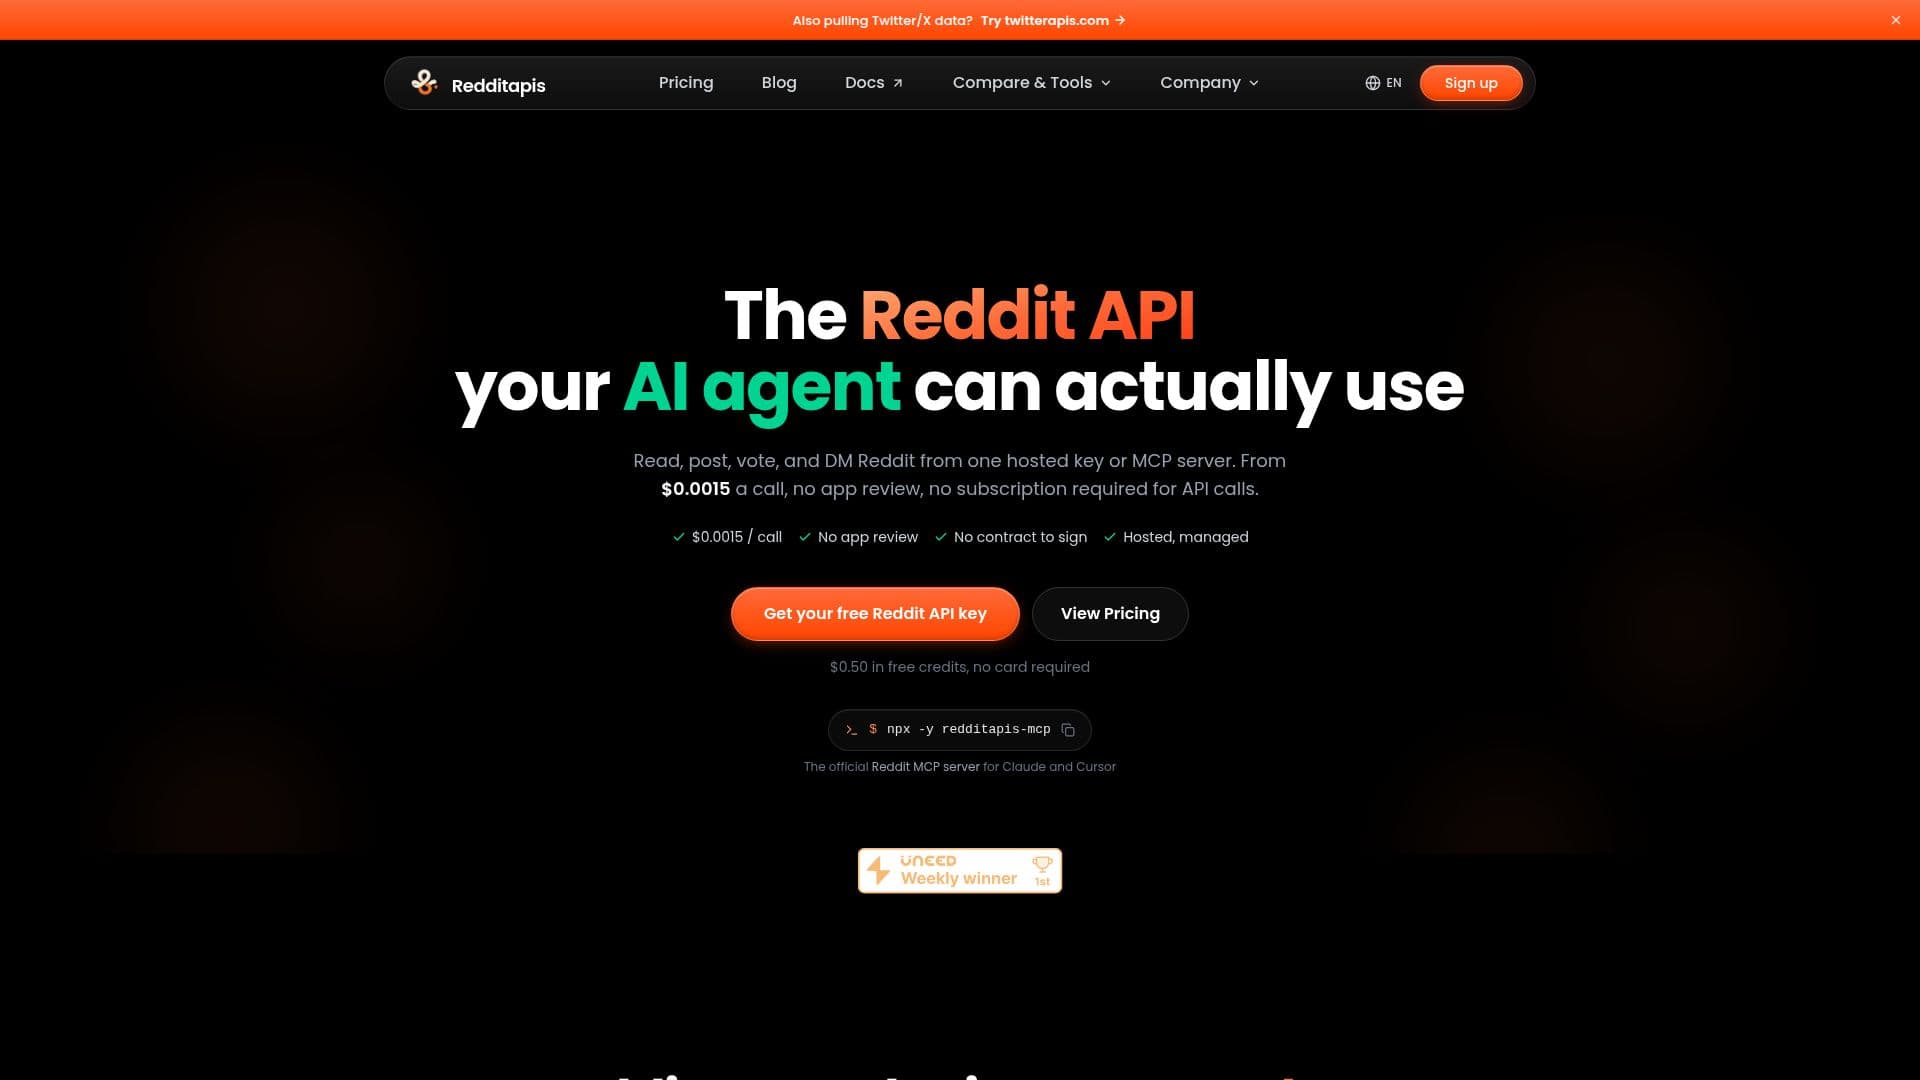
Redditapis 提供按调用计费的 API,用于访问 Reddit 数据,包括帖子、评论、投票和私信。无需订阅或应用审核,灵活定价从每次调用 $0.0015 起。

访问URL
分享
Redditapis 截图
Redditapis 截图

Redditapis 是一个第三方 API 服务,提供对 Reddit 数据和操作的程序化访问。它允许用户读取帖子、评论和用户资料,以及执行写入操作,如发布评论、投票和发送私信。该服务按调用计费,定价从每次读取 $0.0015、每次投票 $0.005、每次写入 $0.012 和每次私信 $0.025 起。新账户可获得 $0.50 的免费积分,允许在任何付款之前进行最多 333 次读取。

阅读更多

Redditapis 旨在绕过 Reddit 官方 API 的限制,该 API 要求进行应用审核和批准以供商业使用。它提供简单的设置流程,允许用户在几分钟内生成 API 密钥并开始发起请求。该服务支持广泛的端点,为各种用例提供全面覆盖,包括数据管道、AI 训练数据集和机器人自动化。

API 的定价模型灵活,无需每月订阅或最低消费。用户可以根据需要充值积分,最小套餐从 $10 起。积分永不过期,使其成为低量和高量数据工作负载的经济高效解决方案。此外,Redditapis 为希望固定每月价格的用户提供可选的每月读取计划。

Redditapis 与 Reddit Inc. 没有关联,独立运营。它执行可接受使用政策,以防止对其写入和私信端点的滥用,确保负责任的使用。该服务由一个小型开发团队维护,提供可靠的 Reddit 数据访问,无需企业合同或批准队列。

  • 类别网页抓取与数据提取
  • 定价模式按通话计费
  • 部署云端
  • 平台网页版

  • 按调用计费的定价模型

  • 无需应用审核

  • 即时生成 API 密钥

  • 全面的端点覆盖

  • 灵活的积分充值选项

  • 注册时提供免费积分

  • 无需订阅

  • 独立于 Reddit Inc.

  • 负责任的使用政策

  1. 注册:在 Redditapis 上创建账户

  2. 生成:立即获取您的 API 密钥

  3. 配置:设置您的 API 请求

  4. 使用:访问 Reddit 数据并执行操作

  5. 优化:监控使用情况并管理积分

  • 数据管道
  • AI 训练数据集
  • 机器人自动化
  • 情感分析
  • 品牌监测

Redditapis 评价

加载中...

与 Redditapis 类似的热门AI工具

TwitterAPIs

AI 应用

TwitterAPIs 提供了一种经济实惠的按调用计费的 API,用于访问 Twitter 和 X 数据。无需订阅或开发者账户,用户可以以每次调用 $0.0008 的价格获取推文、个人资料等信息。

网页抓取与数据提取
查看工具

AI 应用

提供了一种经济实惠的按调用计费的 API,用于访问 Twitter 和 X 数据。无需订阅或开发者账户,用户可以以每次调用 $0.0008 的价格获取推文、个人资料等信息。TwitterAPIs 提供了一种经济实惠的按调用计费的 API,用于访问 Twitter 和 X 数据。无需订阅或开发者账户,用户可以以每次调用 $0.0008 的价格获取推文、个人资料等信息。

网页抓取与数据提取
查看 AI 应用 Top 250

LurkAPI

AI 应用

LurkAPI 提供来自公共社交媒体页面的干净数据,只需一次请求即可获取。它与 Facebook、Reddit 和 YouTube 等平台集成,并可以通过 MCP 在 Claude 内使用。用户可以在无需注册的情况下免费试用。

网页抓取与数据提取
查看工具

AI 应用

提供来自公共社交媒体页面的干净数据,只需一次请求即可获取。它与 Facebook、Reddit 和 YouTube 等平台集成,并可以通过 MCP 在 Claude 内使用。用户可以在无需注册的情况下免费试用。LurkAPI 提供来自公共社交媒体页面的干净数据,只需一次请求即可获取。它与 Facebook、Reddit 和 YouTube 等平台集成,并可以通过 MCP 在 Claude 内使用。用户可以在无需注册的情况下免费试用。

网页抓取与数据提取
查看 AI 应用 Top 250

ScraperAPI

AI 应用

ScraperAPI 是一个网络爬虫 API,允许用户从任何公共网站收集数据,而无需管理代理、浏览器或验证码的麻烦。它提供 5,000 次免费的 API 调用以供入门。

网页抓取与数据提取
查看工具

AI 应用

网络爬虫 API,允许用户从任何公共网站收集数据,而无需管理代理、浏览器或验证码的麻烦。它提供 5,000 次免费的 API 调用以供入门。ScraperAPI 是一个网络爬虫 API,允许用户从任何公共网站收集数据,而无需管理代理、浏览器或验证码的麻烦。它提供 5,000 次免费的 API 调用以供入门。

网页抓取与数据提取
查看 AI 应用 Top 250

Nyata AI API

AI 应用

Nyata AI API通过单一的REST端点提供超本地社区知识。它提供有关食品银行、免费餐食、支持服务和社区活动的信息。开发者可以使用适用于多种编程环境的入门工具包将这些数据集成到他们的应用程序中。

网页抓取与数据提取
查看工具

AI 应用

通过单一的REST端点提供超本地社区知识。它提供有关食品银行、免费餐食、支持服务和社区活动的信息。开发者可以使用适用于多种编程环境的入门工具包将这些数据集成到他们的应用程序中。Nyata AI API通过单一的REST端点提供超本地社区知识。它提供有关食品银行、免费餐食、支持服务和社区活动的信息。开发者可以使用适用于多种编程环境的入门工具包将这些数据集成到他们的应用程序中。

网页抓取与数据提取
查看 AI 应用 Top 250

Scrapingdog

AI 应用

Scrapingdog 是一个全方位的网页抓取 API,能够为您管理代理和无头浏览器。它提供 40 多个专用端点,用于一般抓取、谷歌、社交媒体和电子商务数据,按信用系统计费。

网页抓取与数据提取
查看工具

AI 应用

全方位的网页抓取 API,能够为您管理代理和无头浏览器。它提供 40 多个专用端点,用于一般抓取、谷歌、社交媒体和电子商务数据,按信用系统计费。Scrapingdog 是一个全方位的网页抓取 API,能够为您管理代理和无头浏览器。它提供 40 多个专用端点,用于一般抓取、谷歌、社交媒体和电子商务数据,按信用系统计费。

网页抓取与数据提取
查看 AI 应用 Top 250

Scrape.do 提供强大的网络爬虫工具包,具有无与伦比的速度和不可战胜的价格。它通过先进的代理轮换和反机器人绕过技术,提供对公共数据的无阻访问,确保可靠和可扩展的数据收集。

网页抓取与数据提取
查看工具

提供强大的网络爬虫工具包,具有无与伦比的速度和不可战胜的价格。它通过先进的代理轮换和反机器人绕过技术,提供对公共数据的无阻访问,确保可靠和可扩展的数据收集。Scrape.do 提供强大的网络爬虫工具包,具有无与伦比的速度和不可战胜的价格。它通过先进的代理轮换和反机器人绕过技术,提供对公共数据的无阻访问,确保可靠和可扩展的数据收集。

网页抓取与数据提取
查看 AI 应用 Top 250

Context.dev

AI 应用

Context.dev 是一个为 AI 代理设计的网络数据 API,使用户能够将 URL 抓取为 Markdown,搜索网络,爬取网站,并使用单一的 REST API 提取结构化数据。它提供每月 1,000 个 API 积分的免费套餐,并支持多种定价计划以满足不同需求。

网页抓取与数据提取

网页抓取与数据提取 排名第 16 位

查看工具

AI 应用

为 AI 代理设计的网络数据 API,使用户能够将 URL 抓取为 Markdown,搜索网络,爬取网站,并使用单一的 REST API 提取结构化数据。它提供每月 1,000 个 API 积分的免费套餐,并支持多种定价计划以满足不同需求。Context.dev 是一个为 AI 代理设计的网络数据 API,使用户能够将 URL 抓取为 Markdown,搜索网络,爬取网站,并使用单一的 REST API 提取结构化数据。它提供每月 1,000 个 API 积分的免费套餐,并支持多种定价计划以满足不同需求。

网页抓取与数据提取
网页抓取与数据提取 排名第 16 位

ScrapingBee

AI 应用

ScrapingBee 是一个网络爬虫 API,通过管理代理和无头浏览器简化数据提取,使用户能够高效地专注于收集所需数据。

网页抓取与数据提取
查看工具

AI 应用

网络爬虫 API,通过管理代理和无头浏览器简化数据提取,使用户能够高效地专注于收集所需数据。ScrapingBee 是一个网络爬虫 API,通过管理代理和无头浏览器简化数据提取,使用户能够高效地专注于收集所需数据。

网页抓取与数据提取
查看 AI 应用 Top 250
1/8