描述
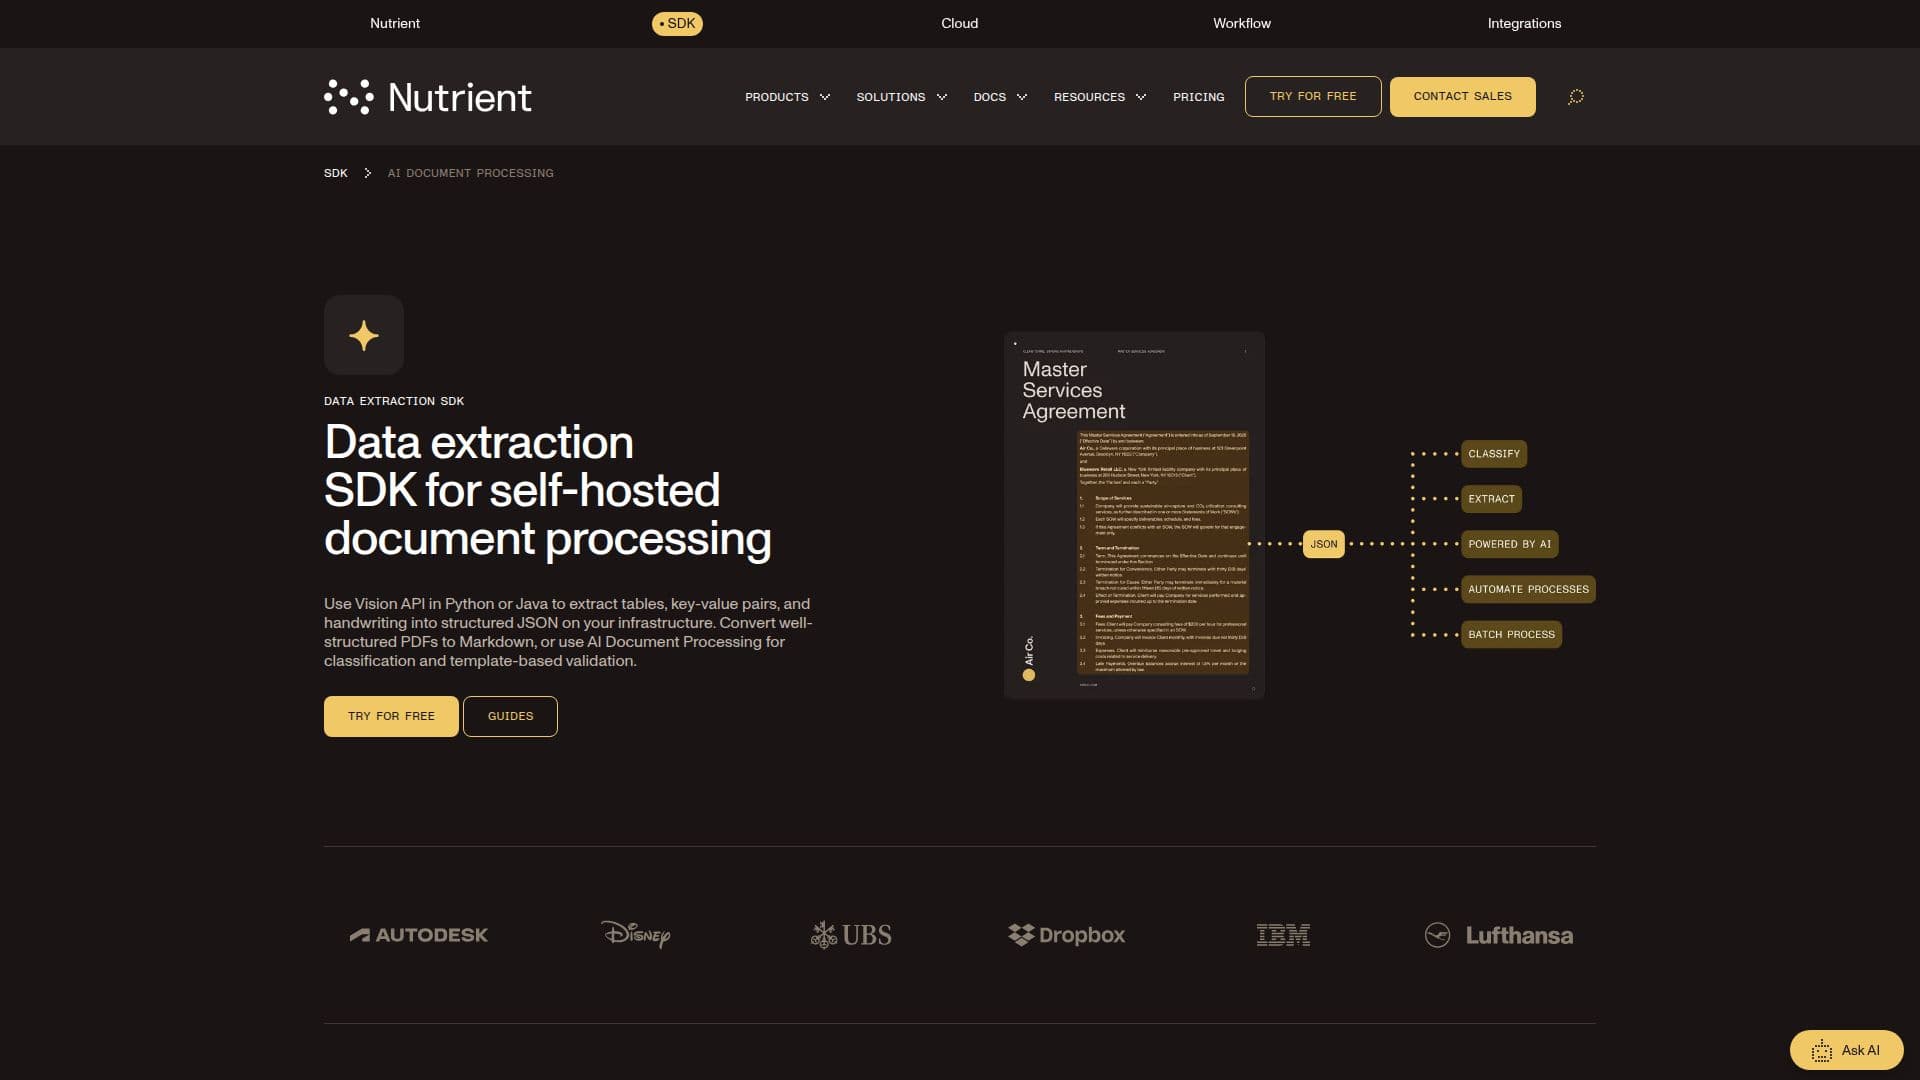
营养AI文档处理是一个文档数据提取SDK,之前以XtractFlow的名义由营养公司(前身为PSPDFKit)出售。它作为营养公司的Python和Java SDK的一部分运行,旨在在公司的基础设施上处理发票、采购订单、身份证明文件、简历和收据,而不是通过第三方云服务。
阅读更多
一个LLM识别文档类型并将其路由到匹配的提取模板;十个现成的模板可供使用,涵盖发票、护照、身份证和收据等文档,并且可以通过用通用语言描述所需字段来构建自定义模板,而无需编写规则或正则表达式。提取的值由十一种内置验证器检查,包括IBAN、增值税ID、信用卡号、邮政地址、电子邮件和电话号码;任何未通过检查的值都会被标记为需要验证,而不是默默接受。
同一产品页面还涵盖了营养公司的低级数据提取SDK,该SDK使用OCR、内部AI模型进行布局和手写识别(ICR),或可以与Qwen本地运行或连接到云提供商(如Claude或OpenAI)的视觉语言模型,返回带有元素坐标、阅读顺序和置信度分数的结构化JSON。它可以读取超过100种文件类型,包括扫描的PDF、Office文档、CAD文件和40多种相机RAW格式,并处理多列布局、混合语言和倾斜扫描。一个单独的PDF到Markdown模式将已经数字化的PDF转换为干净的Markdown,而无需运行任何AI模型。
AI文档处理需要连接LLM提供商(OpenAI或Azure OpenAI);OCR、ICR和PDF到Markdown模式完全在本地运行,无需网络访问。数据提取今天已在Python(3.8+)和Java(8+)中可用,.NET和DWS处理器API计划很快推出;提供免费试用,无需支付信息。
这是一个开发者SDK,而不是一个托管的无代码工具,旨在为构建发票处理、身份证验证或文档接收管道的工程团队提供服务,他们需要控制文档和数据的去向。AI文档处理的跨平台支持在当前可用性之外被列为即将推出,而不是今天就可以使用。
- 类别网页抓取与数据提取
- 定价模式基于组件
- 部署本地部署, 云端
- 平台Python, Java
营养AI文档处理的核心功能
基于LLM的文档分类,将每个文档路由到匹配的提取模板
十个现成的模板,适用于发票、护照、身份证、收据等
以通用语言定义的自定义提取模板,无需正则表达式或规则引擎
十一种内置验证器(IBAN、增值税ID、信用卡、邮政地址、电子邮件、电话号码等)
三个提取引擎(OCR、ICR和VLM)合并为带有坐标和置信度分数的结构化JSON
每个引擎的本地处理,包括视觉语言模型,仅在选择时连接云提供商
支持超过100种文件类型,包括扫描的PDF、Office文档和CAD文件
数字化PDF到Markdown转换,无需AI模型或网络访问
今天可用的Python和Java SDK,计划推出.NET和DWS处理器API
如何使用 营养AI文档处理?
安装SDK:将营养Python或Java SDK添加到您的项目中。
选择提取模式:选择PDF到Markdown以处理干净的数字PDF,或选择数据提取(OCR、ICR或VLM)以处理扫描和复杂布局。
连接LLM(可选):对于AI文档处理,配置OpenAI或Azure OpenAI密钥以启用分类和模板。
运行提取:处理文档并接收带有坐标、置信度分数和阅读顺序的结构化JSON。
验证字段:内置验证器标记未通过格式检查的值,例如IBAN或增值税ID。
在您的基础设施上部署:自托管运行SDK,因为文档数据保留在您的网络上,除非您连接云提供商。
营养AI文档处理的使用案例
- 发票处理
- 身份证和护照验证
- 扫描文档数字化
- 自托管数据管道