描述
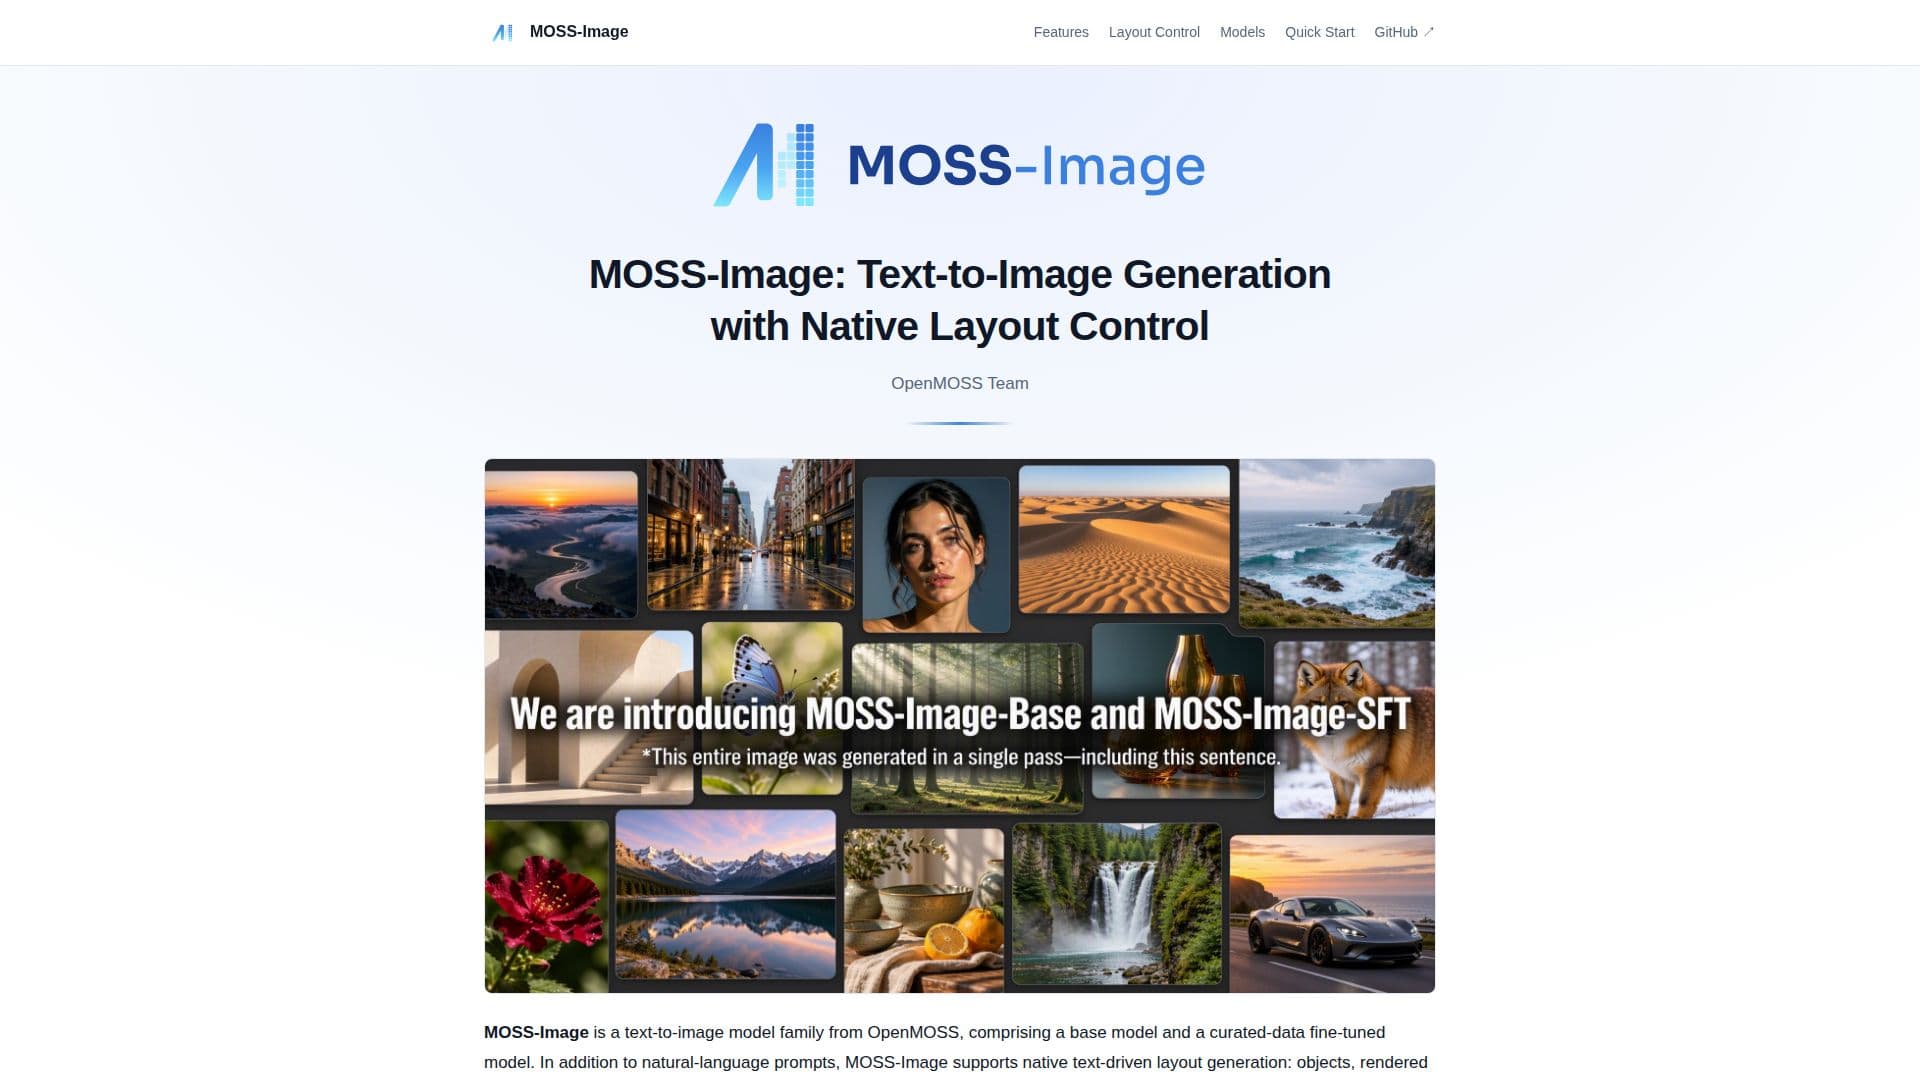
MOSS-Image是OpenMOSS开发的一款复杂的文本到图像模型,旨在将自然语言描述转化为详细的图像。该模型系列包括一个基础模型和一个经过精细调优的版本MOSS-Image-SFT,后者使用经过筛选的数据进行了优化。MOSS-Image的一个突出特点是其原生的文本驱动布局控制,允许用户通过结构化的JSON提示来指定场景、对象和文本位置。这一能力使得用户能够精确控制图像中元素的空间排列。
阅读更多
该模型基于紧凑的5B骨干网络构建,支持最多4,000个标记的提示,并能够渲染动漫和照片写实风格。它旨在高效生成和在各种任务和领域中进行微调。MOSS-Image利用共享的Diffusers管道,通过Python和Gradio接口访问,使其对开发者和研究人员具有多样性。
MOSS-Image支持布局到图像的生成,允许用户编辑文本、元素描述和边界框,以调整图像内容和构图。此功能在视觉设计、插图和摄影等应用中尤为有用。该模型的权重在Apache-2.0许可证下提供,确保了进一步开发和研究的开放访问。
该工具与ComfyUI无缝集成,提供对模型加载和工作流管理的原生支持。用户可以安装MOSS-Image插件以增强其图像生成工作流。此外,MOSS-Image提示增强器技能可用于帮助创建详细的标题和空间布局提示,进一步扩展了该工具的实用性。
总体而言,MOSS-Image是一个强大的工具,适合任何希望从文本描述中生成图像并实现精确布局控制的人,满足广泛的创意和专业应用需求。
- 类别AI 图像生成器
- 定价模式开源
- 部署云端
- 平台网页版
MOSS-Image的核心功能
文本到图像生成
原生布局控制
紧凑的5B骨干网络
动漫和照片写实风格
4K标记支持
Python和Gradio接口
开源模型权重
ComfyUI集成
提示增强器技能
如何使用 MOSS-Image?
安装:设置Python 3.10+和兼容的PyTorch
配置:加载模型权重并设置参数
生成:使用Gradio或Python接口创建图像
优化:调整布局和提示以获得所需输出
MOSS-Image的使用案例
- 视觉设计
- 插图
- 摄影
- 创意项目
- 研究