描述
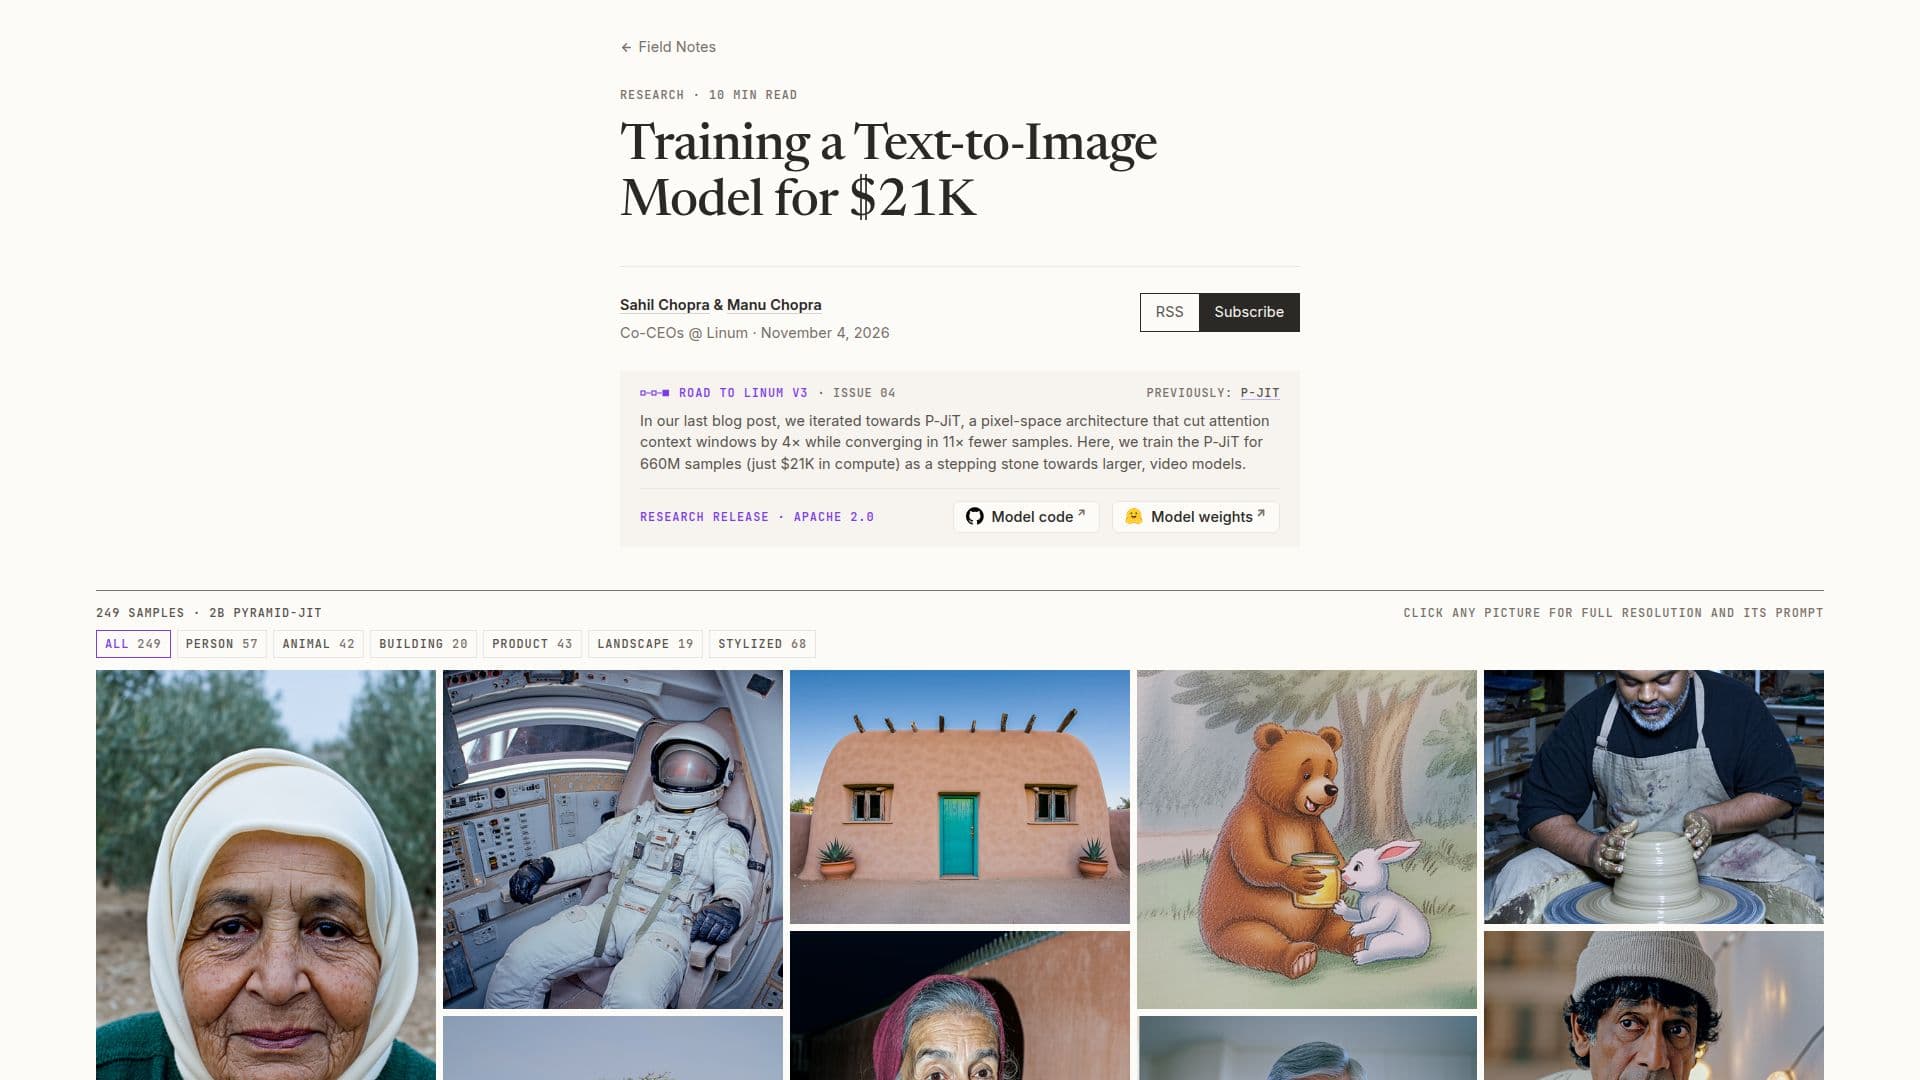
Linum P-JiT 是由 Linum 开发的实验性文本到图像模型,Linum 是一个致力于从零开始训练生成视频模型的两人研究实验室。这个特定模型是一个 2B 参数的 Pyramid-JiT(P-JiT),作为他们正在进行的研究的概念验证,旨在通过经济高效和可控的生成工具实现动画的民主化。该模型的训练成本约为 21,038 美元,展示了在相对较低的计算开销下获得高质量结果的潜力。
阅读更多
P-JiT 的核心创新在于其通过消除传统的变分自编码器(VAE)来实现更激进的压缩和更快的学习,从而改变了扩散模型架构。相反,扩散模型学习一个专门为其用例构建的潜在空间,从而实现更大的压缩和改进的生成。该像素空间模型在比 Linum v2 少 11 倍的样本中收敛,并提供了四倍更激进的令牌减少,代表了一个 512x512 的图像,使用的令牌数量与之前用于 256x256 图像的相同。这意味着注意力上下文窗口减少了四倍,显著降低了训练和推理成本。
P-JiT 架构包含一个文本和图像处理管道,每种模态在合并到 22 个相同的 DiT 块流之前,都会经过单模态的 "精炼" DiT 块。文本表示来自一个冻结的 Qwen3.5-4B 模型,而图像被分割成 32x32 的补丁并压缩到一个 1024 维空间。该模型还具有与 DINOv3-L 对齐的 PixelREPA 读出,以及沿主干的额外线性读出头,以通过预测最终图像的低分辨率版本来加速收敛。
训练分为几个阶段进行,首先在 512x512 分辨率下进行 610 万个样本的训练,然后过渡到 1024x1024 分辨率进行 500 万个样本的训练。采用了噪声调度的课程,最初集中在高噪声上以学习基本结构,然后扩大分布以获取细粒度细节。训练后涉及有限差分流优化(FDFO)的变体,结合 JEV-Image 和人类参与的评审。尽管该模型显示出良好的结果,但在全身生成、多个实体、多个人交互和世界知识方面存在局限性,这些都是其规模模型的常见问题。它没有使用渲染文本的图像进行训练,因此无法生成文本或海报。
- 类别AI 模型与大语言模型
- 定价模式开源
- 部署云端
- 平台网页版
Linum P-JiT的核心功能
Pyramid-JiT(P-JiT)架构:新颖的像素空间模型,实现高效生成
2B 参数 DiT:核心扩散变换器模型大小
4B 文本编码器:利用冻结的 Qwen3.5-4B 模型进行文本表示
无 VAE 设计:消除 VAE,实现更激进的压缩和更快的学习
4 倍令牌减少:以比 Linum v2 少 4 倍的令牌表示 512x512 图像
11 倍更快收敛:以显著更少的训练样本获得结果
多阶段训练:从 512x512 进展到 1024x1024 分辨率
课程噪声调度:调整噪声分布以学习结构和细节
PixelREPA 读出:将潜在空间与 DINOv3-L 对齐,以改善细节学习
线性读出头:在四分之一和二分之一分辨率下预测清晰图像,以加速收敛
有限差分流优化(FDFO):用于训练后精炼
Apache 2.0 许可证:权重在开源许可证下发布
经济高效的训练:以约 21K 美元实现高质量结果
专注于生成视频研究:朝着未来视频模型迈出的一步
如何使用 Linum P-JiT?
理解架构:查看 P-JiT 架构的详细信息,包括文本和图像处理流程。
检查训练方案:了解多阶段训练过程、噪声调度和分辨率过渡。
探索模型局限性:理解当前在全身生成、多个实体和文本生成方面的局限性。
访问训练设置:参考附录 A 获取详细的训练参数和配置。
审查成本细目:查看训练前和训练后的计算成本细目。
分析示例失败:研究提供的模型失败示例,以掌握当前能力和改进领域。
Linum P-JiT的使用案例
- 文本到图像生成研究
- 经济高效的模型训练
- 生成视频模型开发
- 架构创新测试
- 开源 AI 实验