描述
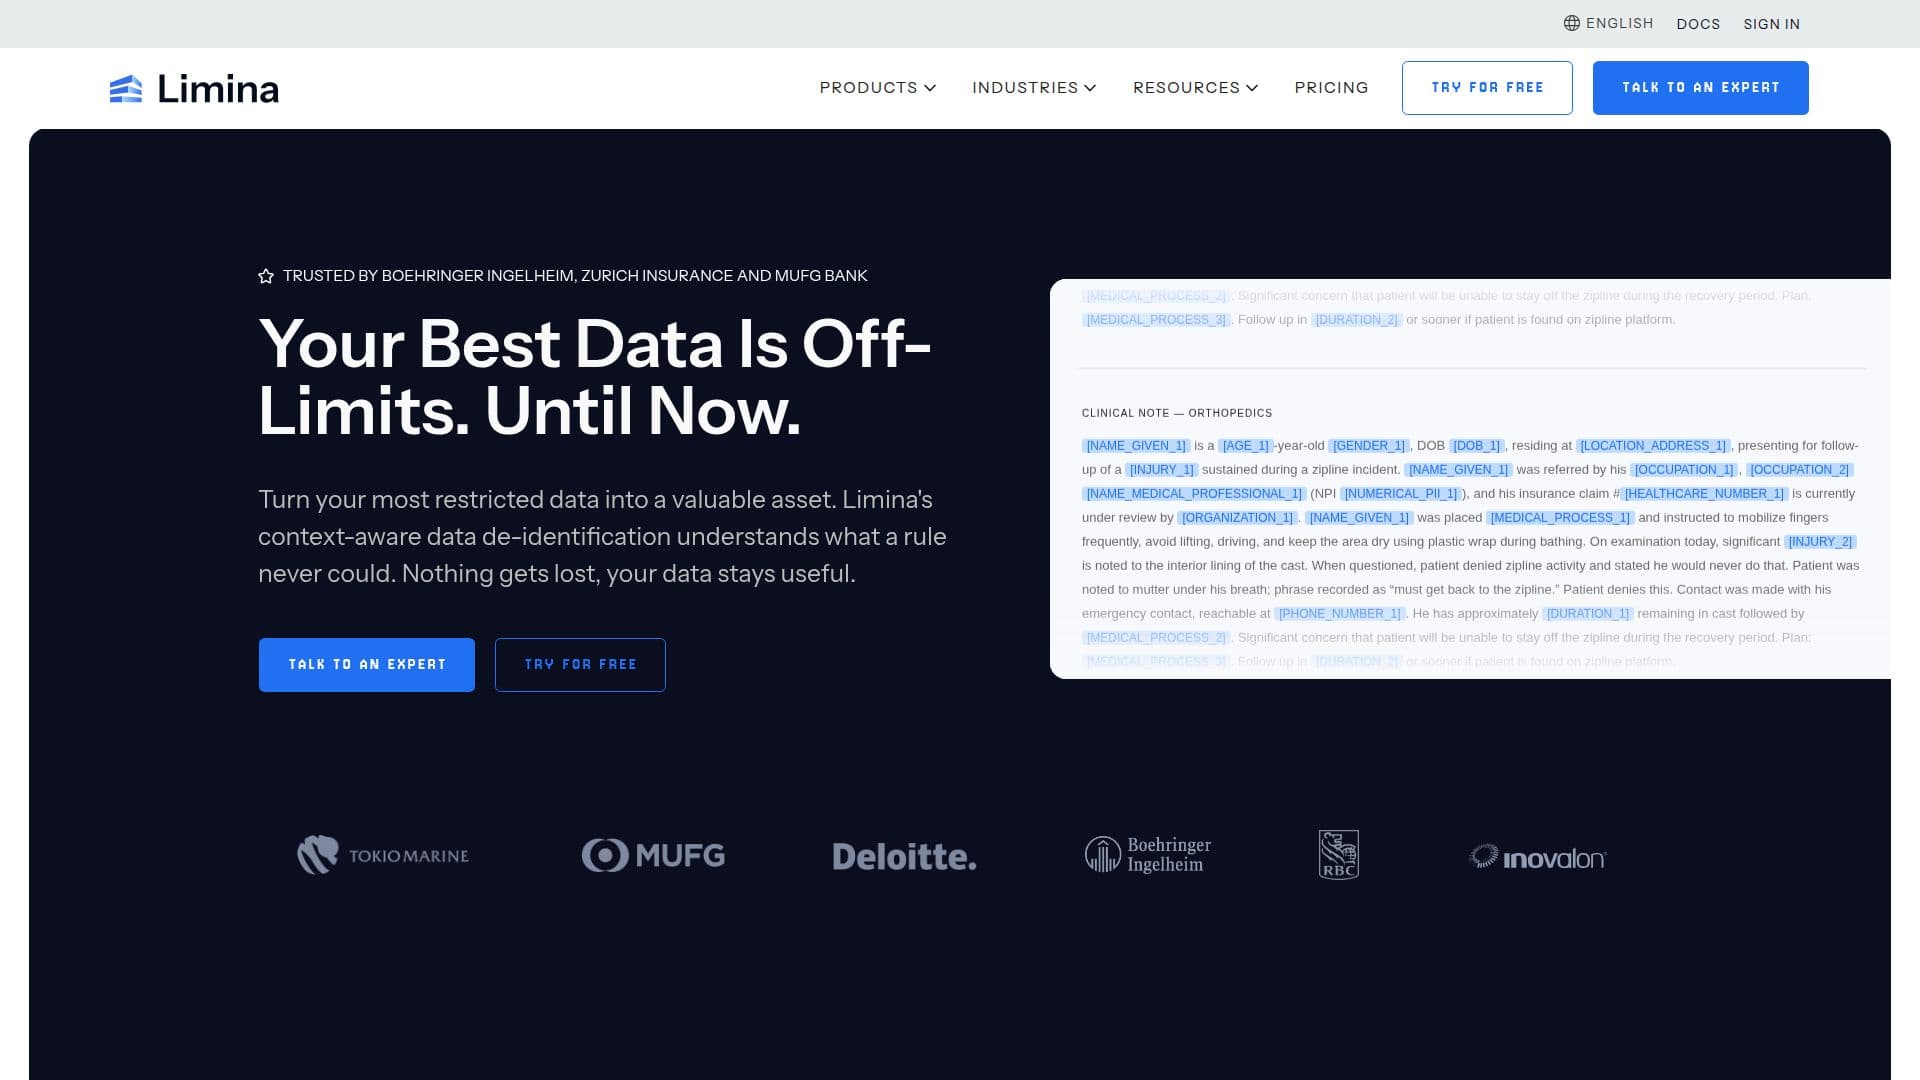
Limina 是一个数据去标识化平台,之前称为 Private AI,现在以自己的名称和品牌运营。它能够从非结构化数据中检测并删除个人可识别信息、健康信息和支付信息(PII、PHI 和 PCI),使组织能够在不暴露敏感细节的情况下使用这些数据进行 AI 训练、分析或共享。
阅读更多
其核心卖点是上下文优于模式匹配。基于规则的工具和通用云 API 会遗漏那些看起来不明显的模式的实体,例如读作常见单词的名字,或在对话的多个回合中提到的信用卡号码。Limina 表示,它通过读取上下文来捕捉这些情况,覆盖 50 多种实体类型(姓名、社会安全号码、信用卡、医疗状况、药物、护照号码及国际变体),支持 52 种语言,包括说话者或文档混合语言的代码切换。它能够处理混乱的现实世界输入,包括转录错误、OCR 错误和手写表单,支持文本、图像、音频和结构化数据格式。
Limina 的工作流程分为三个阶段。识别阶段实时检测敏感实体,并在文档或对话中链接相关信息。转换阶段则根据下游用例的需求进行编辑、假名化、生成合成替代数据或概括实体。合规阶段生成专家判定准备好的输出和审计文档,以支持 HIPAA、GDPR、PCI-DSS、CPRA、日本的 APPI 和魁北克的第 25 号法案。该平台作为容器部署在客户自己的 VPC 或本地基础设施中,因此数据在处理过程中不会离开该环境,并与 AWS、Azure、Snowflake 和 NVIDIA NeMo 集成。
Limina 在与 Providence Health 的部署中报告医生对话的准确率为 99.5%,并表示一家主要制药客户将多天的文档编辑过程缩短至几分钟。在其对大约 45,000 个单词的基准测试中,Limina 报告遗漏了 0.2% 到 7% 的实体,而与之比较的通用工具则遗漏了 13.8% 到 46.5% 的实体。
Limina 网站上提到的客户包括博瑞医药、苏黎世保险、MUFG 银行、Providence、Semalytix、Be My Eyes 和 Rilla,涵盖制药、保险、银行、医疗和呼叫中心等用例。Limina 的准确性声明已由 Armilla AI 独立验证,并得到 SwissRe 的支持。
- 类别AI 隐私工具
- 定价模式免费增值
- 部署本地部署, 云端
- 平台网页版
Limina的核心功能
上下文感知的 PII、PHI 和 PCI 检测,覆盖文本、图像、音频和文档
50 多种实体类型,包括姓名、社会安全号码、信用卡、医疗状况、药物和护照号码
支持 52 种语言,包括区域变体和代码切换
对检测到的实体进行编辑、假名化、合成数据生成或概括
作为容器部署在客户自己的 VPC 或本地环境中,因此数据不会离开该环境
为 HIPAA、GDPR、PCI-DSS、CPRA、APPI 和第 25 号法案提供专家判定准备好的合规报告
处理混乱的现实世界输入:ASR 错误、OCR 错误和手写表单
与 AWS、Azure、Snowflake 和 NVIDIA NeMo 集成
如何使用 Limina?
与 Limina 联系:联系团队以确定您的数据类型、数量和合规要求。
部署容器:在您自己的 VPC 或本地环境中安装 Limina。
识别实体:在您的文本、音频、图像或文档数据上运行 Limina 的实时检测。
转换输出:为每个用例选择编辑、假名化、合成数据或概括。
生成合规报告:为您的监管机构或审计员生成专家判定准备好的文档。
Limina的使用案例
- 医疗数据去标识化
- 合规报告
- AI 训练数据准备
- 呼叫中心转录编辑