描述
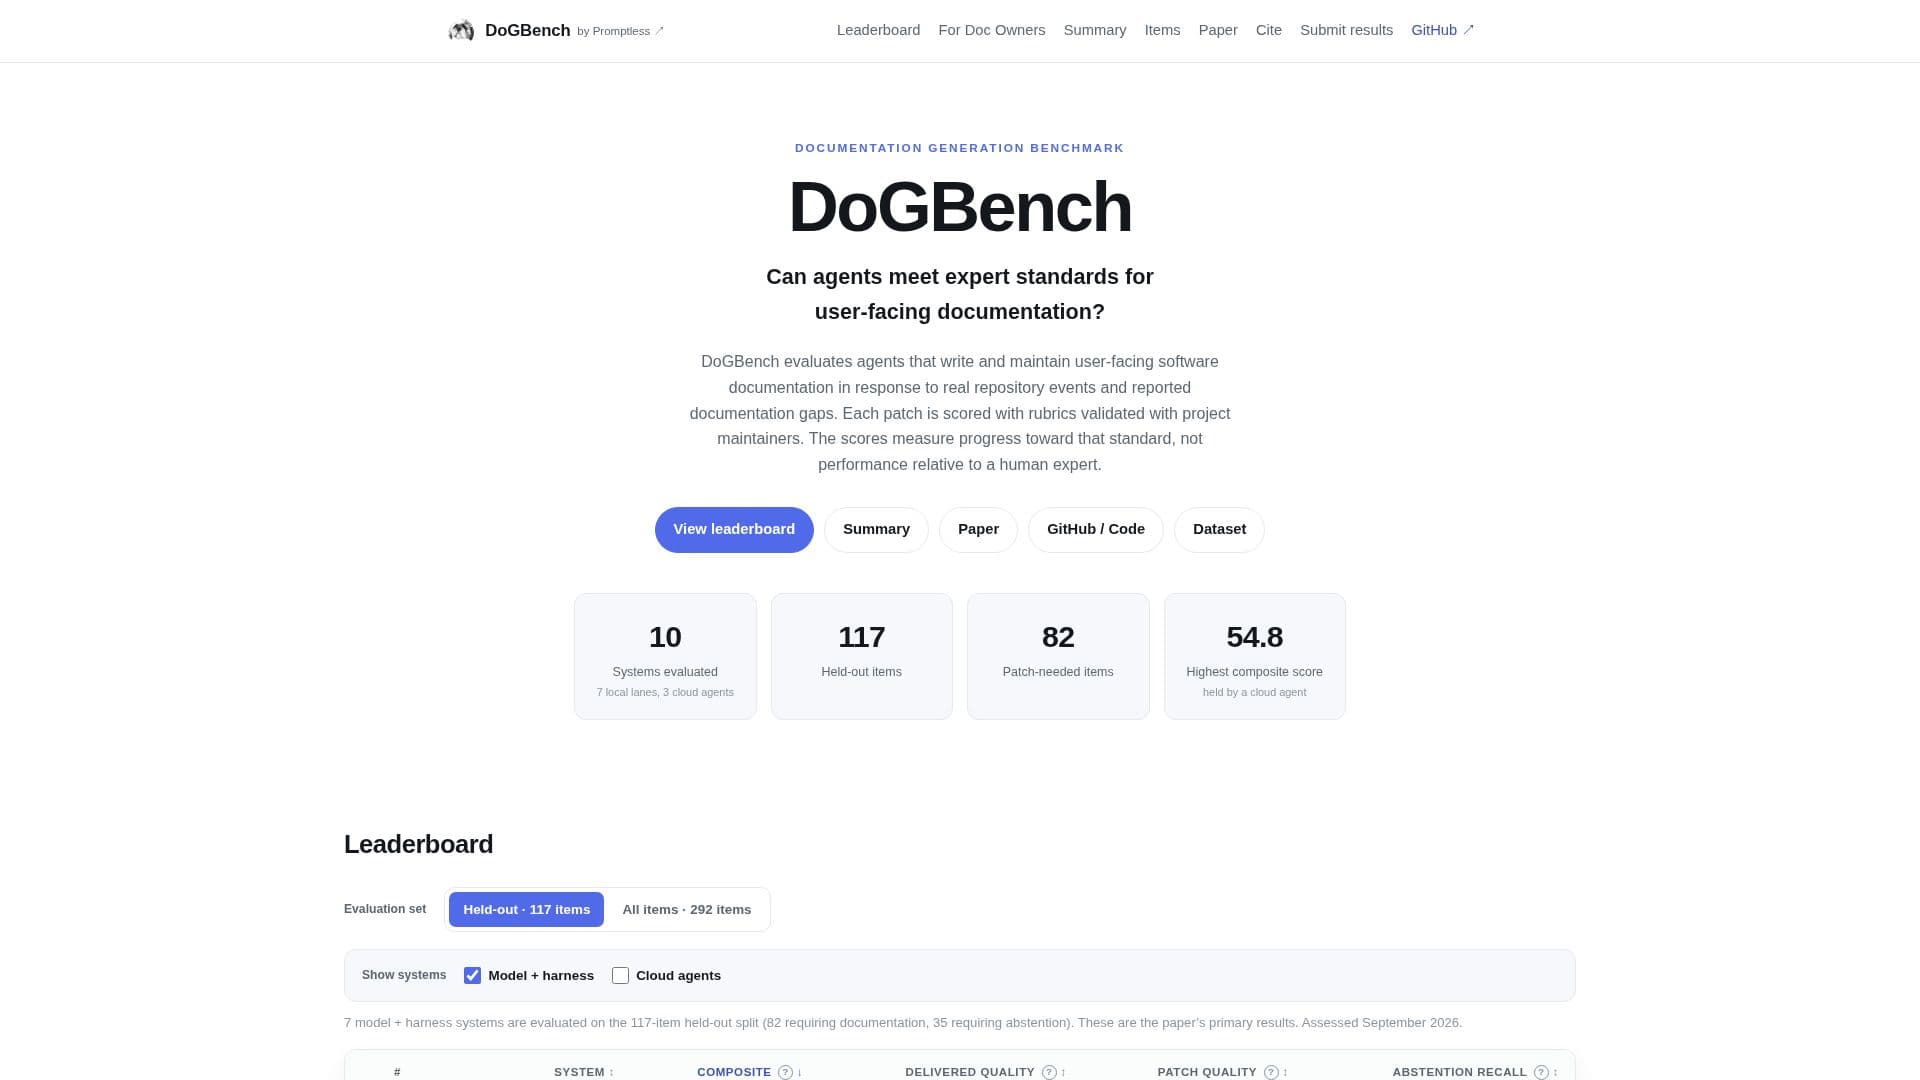
DoGBench 是一个基准工具,旨在评估 AI 代理在编写和维护用户面向软件文档方面的能力。该工具评估代理是否能够识别文档何时需要更新,并生成符合专家审查标准的补丁。每个补丁的评分使用经过项目维护者验证的评分标准,重点关注向专家标准的进展,而不是相对于人类专家的表现。
阅读更多
该基准包括来自真实开源项目的 292 个任务,例如 Helm、PostHog、Mautic 和 Doc Detective。其中 205 个任务需要文档更改,而 87 个任务不需要更改。评估使用分层的 117 项保留分割,包含 82 个需要更新的任务和 35 个需要弃权的任务。
DoGBench 为更新决策和补丁质量报告单独的分数。评分规则同时捕捉交付的补丁质量和正确的弃权,使用调和平均数将它们结合起来。关键失败将补丁的分数限制在 100 分中的 60 分,每个评分标准的权重相等。
代理通常难以确定文档何时需要更新,有时记录内部更改而不影响用户,或者由于缺乏现有覆盖而错过必要的更新。尽管写作流畅,代理可能会遗漏重要步骤或将补丁放置在读者不太可能找到的页面上。
该工具对希望与团队或领导讨论技术写作挑战的文档所有者非常有价值。它提供了关于 AI 代理不足之处的见解,并强调专家审查在确保文档准确性和完整性方面的重要性。
- 类别AI 代码审查与测试
- 部署云端
- 平台网页版
DoGBench的核心功能
评估 AI 代理的文档更新能力
使用经过项目维护者验证的评分标准
根据专家标准对补丁进行评分
包括来自开源项目的 292 个任务
为更新决策和补丁质量分开评分
解决任务完成差距和技术不准确性
为文档所有者提供见解
强调专家审查的重要性
如何使用 DoGBench?
评估:评估代理的文档能力
评分:使用评分标准对补丁进行评分
分析:审查任务完成差距
讨论:与文档团队分享见解
DoGBench的使用案例
- 文档更新
- 专家审查
- 技术写作
- AI 评估
- 开源项目