描述
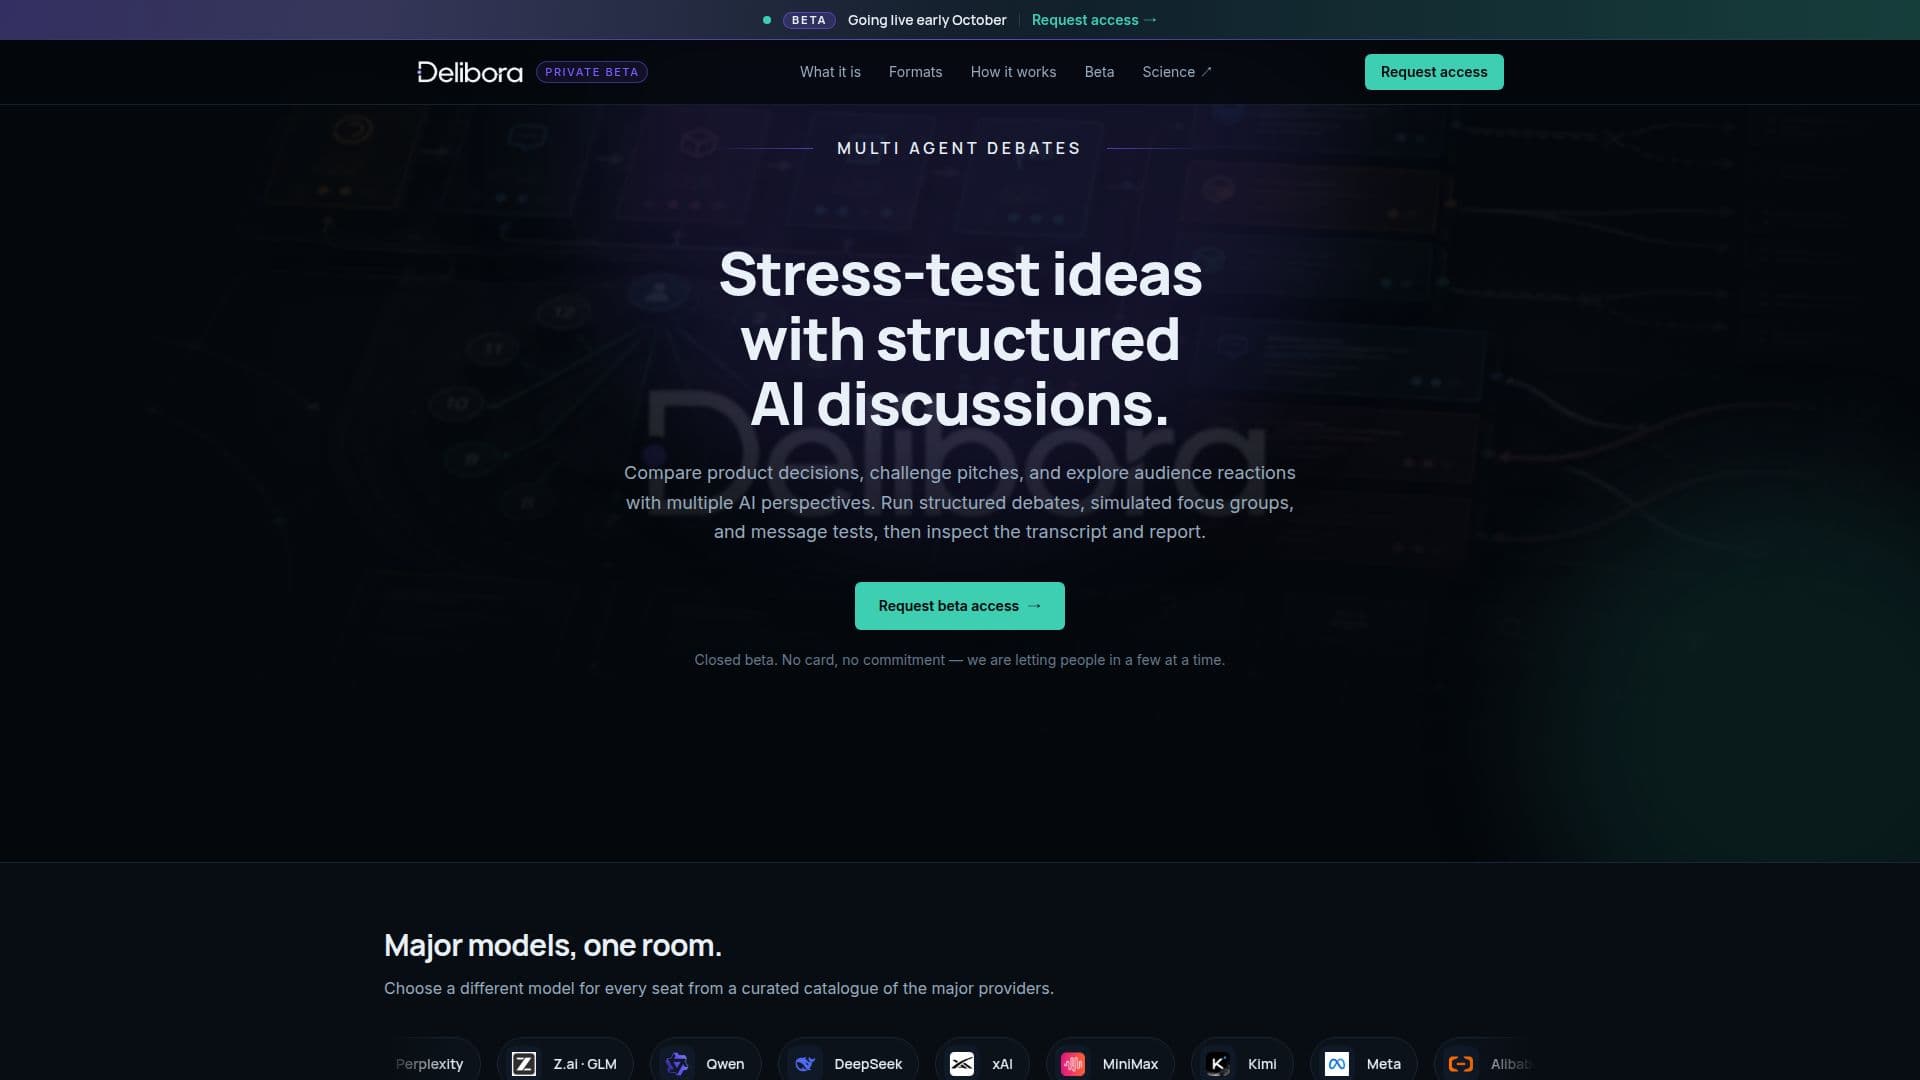
Delibora 提供一个独特的多代理 AI 讨论平台,使用户能够进行结构化的 AI 辩论、提案评审、焦点小组、观众模拟和创意锦标赛。该平台旨在通过模拟多个 AI 参与者之间的对话来对想法和决策进行压力测试,每个参与者都有自己的简报和私密背景。与询问单一模型不同,Delibora 进行结构化对话,其中协议规定了轮次顺序,确保观点的动态和多样化交流。
阅读更多
用户可以从主要提供商的策划目录中为每个参与者选择不同的 AI 模型,包括 Anthropic、OpenAI、Google Gemini、Perplexity 和 Meta 等。这种灵活性允许多样化的观点和更强有力的讨论。讨论中的每个轮次都会被记录,用户可以关闭标签页,稍后返回时发现讨论正好在他们离开时的地方。用户还可以排队自己的轮次,以引导讨论而无需重新开始。
该平台提供十二种不同的讨论格式,按其目的分组:评估和选择、探索观点和理解观众。像“决策压力测试”这样的格式将两个对立的代理对抗,以挑战假设,而“评判辩论”则涉及两个辩手和一个中立仲裁者来评分论点。“团队战斗”允许两个保存的团队捍卫对立立场,而“鲨鱼坦克”模拟提案评审,由“鲨鱼”小组独立评分。
为了探索观点,“专家小组”收集专家的见解而不作裁决,而“1:1 人类对话”模拟两个 AI 人物之间的私人聊天。为了理解观众,“焦点小组”进行有主持的会议,生成发现和引用,“部落思维”模拟合成观众中的意见运动,而“触达测试”在合成观众中筛选活动信息。“面试模拟器”允许用户测试面试指南与模拟参与者的互动。
Delibora 还具有“多格式”功能,允许将两个到五个讨论格式串联成一个工作流程。一个步骤的结果成为下一个步骤的简报,并可以进行检查以路由结果或暂停以供用户审查。这允许对想法和决策进行复杂的多阶段评估。该平台为每次运行提供可检查的记录和全面的报告,详细说明了决定、争议和结论背后的推理。它强调其模拟参与者并非真实人物,结果是方向性的,使其非常适合排练和在投入真实资源之前提出异议。
- 类别自动化与智能体
- 定价模式免费(测试版)
- 部署云端
- 平台网页版
Delibora的核心功能
多代理 AI 讨论平台
结构化 AI 辩论和模拟
可检查的记录和报告
可配置的 AI 参与者,具有独立简报
主要 AI 模型的策划目录(Anthropic、OpenAI、Google Gemini 等)
十二种讨论格式(例如,决策压力测试、评判辩论、焦点小组)
多格式工作流程,用于串联讨论
持久的逐轮对话记录
用户干预以引导讨论
决策压力测试以挑战假设
评判辩论与中立仲裁者评分
团队战斗与五维评分卡
鲨鱼坦克提案评审与引用评分卡
创意锦标赛用于排名概念与淘汰卡
焦点小组模拟以获取观众见解
如何使用 Delibora?
选择格式:从十二种结构化讨论格式中选择,如决策压力测试或焦点小组。
配置参与者:为每个参与者分配不同的 AI 模型并提供个别简报。
定义协议:设置 AI 讨论的轮次顺序和规则。
运行模拟:启动多代理讨论以对想法进行压力测试或收集见解。
检查记录:回顾逐轮对话的发生情况。
分析报告:检查生成的报告,了解决策、争议点和建议。
链式工作流程:使用多格式连接多个讨论格式,以进行复杂评估。
Delibora的使用案例
- 决策压力测试
- 提案评审模拟
- 观众反应模拟
- 创意锦标赛
- 专家小组见解
- 团队战斗策略
- 面试指南测试
- 工作流程链式