描述
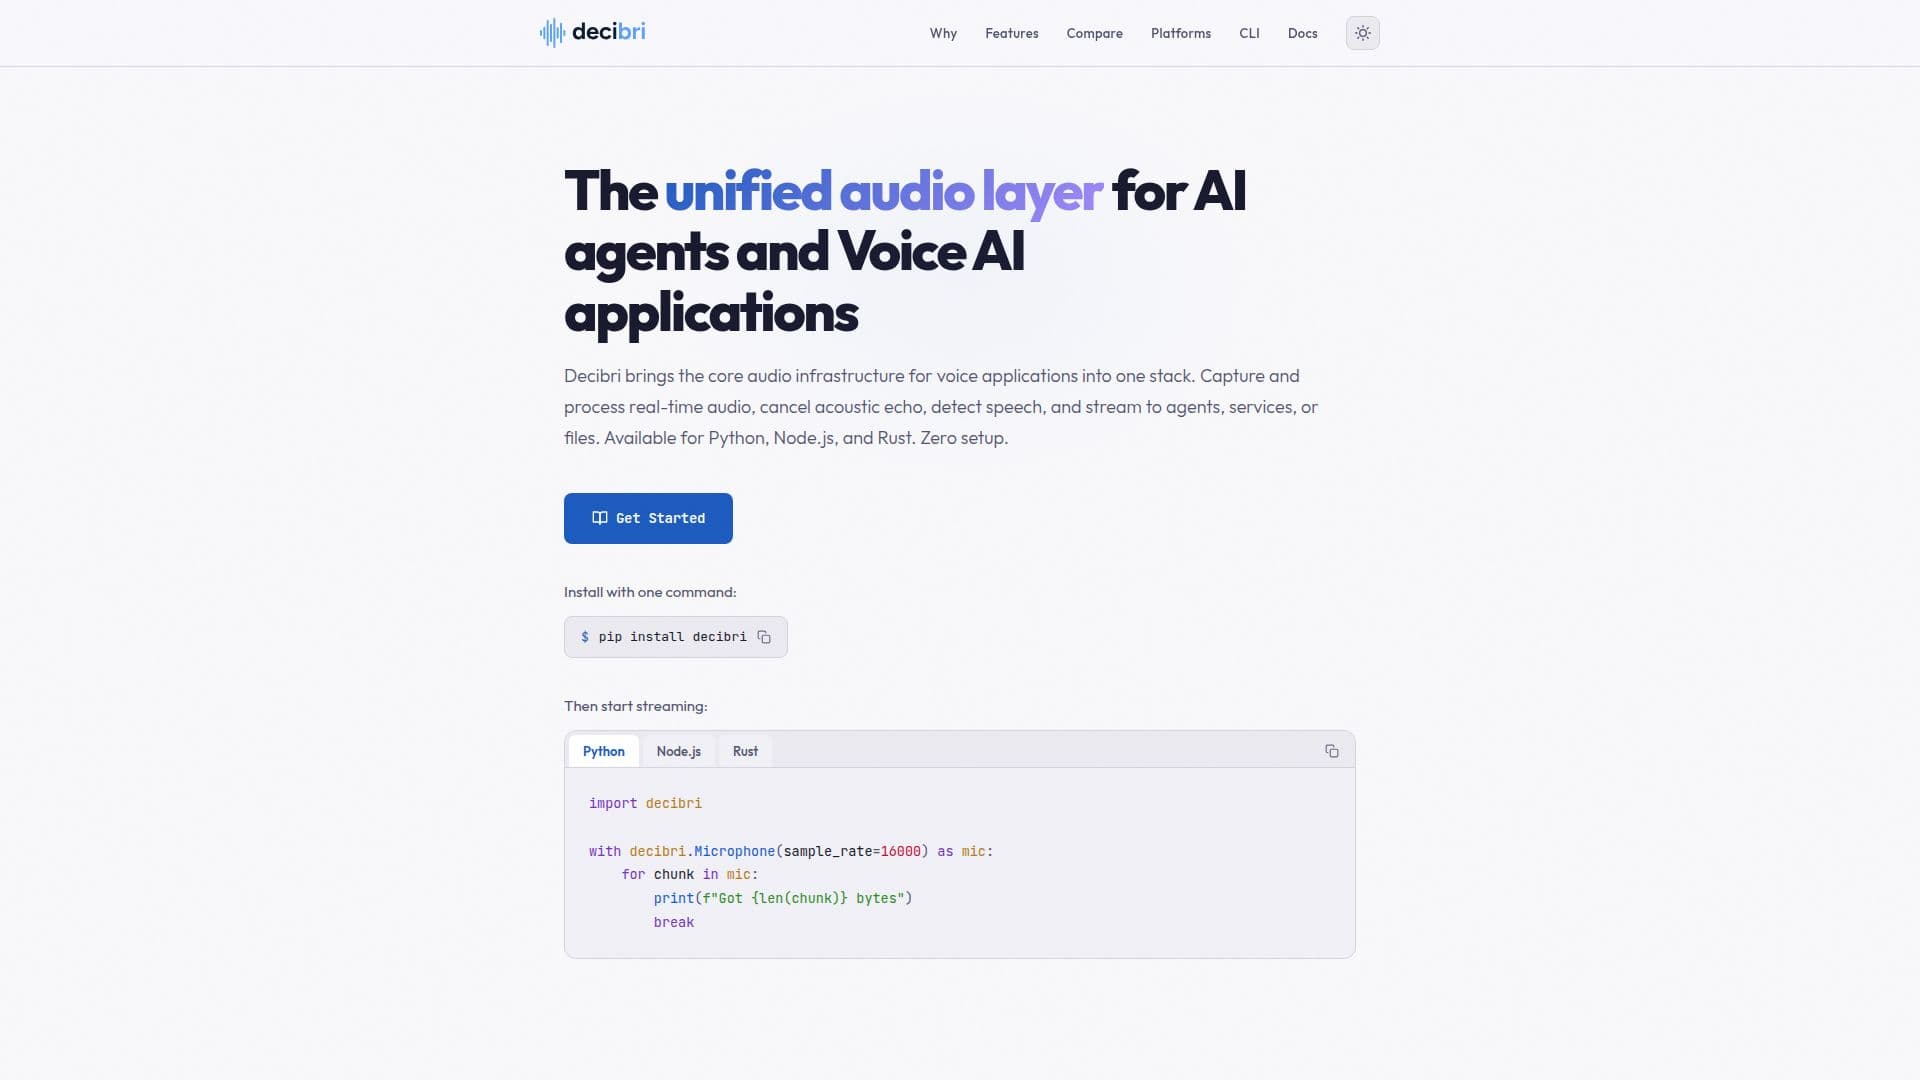
Decibri 作为一个统一音频层,专门为 AI 代理和语音 AI 应用程序设计。它提供基本的实时音频功能,包括麦克风捕获、扬声器输出和语音活动检测(VAD)。该平台支持多种编程语言,即 Python、Node.js 和 Rust,使其在各种开发环境中具有灵活性。
阅读更多
Decibri 的一个主要优势是其易于安装和跨平台兼容性。它为所有支持的平台(Windows、macOS、Linux)提供 Python 和 Node.js 的预构建二进制文件,消除了编译或复杂构建工具的需求。这种“零设置”方法确保开发人员可以快速将实时音频功能集成到他们的项目中。Rust 核心为 Python、Node.js 和 Rust 包提供支持,编译为本地代码,确保直接从操作系统的音频层提供可预测的低延迟音频。
Decibri 直接从操作系统音频层捕获音频,默认提供 100 毫秒音频块,采用 16 位有符号整数 PCM 格式,这是大多数语音和唤醒词引擎(如 Vosk、sherpa-onnx 和 whisper.cpp)所期望的标准格式。同时也提供 32 位浮点格式。它支持每种语言的流原生习惯,允许开发人员高效地将音频传输到文件、WebSockets 或语音代理。该平台还包括捆绑的 Silero VAD v6.2 模型,用于在嘈杂环境中准确检测语音,能够通过 ONNX Runtime 本地运行,无需云 API。
除了基本的捕获和播放功能外,Decibri 还通过其音频捕获引擎(ACE)提供高级音频处理功能,包括直流去除、去噪、高通滤波、自动增益控制和限制。它还提供声学回声消除(AEC),以去除扬声器声音对麦克风捕获的影响。对于离线处理,音频文件处理器(AFP)允许对录制或内存中的样本进行调节。Decibri 与众多语音转文本(STT)提供商集成,包括云端(AssemblyAI、AWS Transcribe、Azure AI Speech、Deepgram、Google Cloud Speech-to-Text、Mistral Voxtral、OpenAI Realtime API)和本地(Sherpa-ONNX、Whisper.cpp),以及本地文本转语音(TTS)与 Kokoro 模型和关键词检测(KWS)与 Sherpa-ONNX。
Decibri 专为实时系统构建,确保低延迟音频 I/O,无需外部音频工具或平台特定处理。它支持 Python 中的异步操作,使用 `asyncio`,并且可以在 Node.js 和浏览器环境中从单个包中工作。`decibri-cli` 工具提供音频捕获、播放和设备枚举的命令行功能,进一步扩展了其在脚本和 CI/CD 管道中的实用性。
- 类别AI 智能体构建工具
- 定价模式免费
- 部署本地
- 平台Windows, macOS, Linux, Browser
Decibri的核心功能
实时麦克风捕获
扬声器输出和播放
语音活动检测(VAD)
跨平台支持(Python、Node.js、Rust)
零设置的预构建二进制文件
直接访问操作系统音频层
16 位 PCM 和 32 位浮点音频输出
异步 API 支持(Python 的 asyncio)
浏览器兼容性(Node.js 包)
音频捕获引擎(直流去除、去噪、AGC)
声学回声消除(AEC)
本地机器学习语音检测(Silero VAD)
与云 STT 服务的集成
与本地 STT/TTS/KWS 模型的集成
命令行接口(decibri-cli)
如何使用 Decibri?
安装 Decibri:使用 `pip install decibri` 安装 Python 版本或 `npm install decibri` 安装 Node.js 版本以获取预构建的二进制文件。
打开麦克风:在 Python 中使用 `decibri.Microphone.open()` 或在 Node.js 中使用 `new Microphone()` 开始捕获音频。
流式音频:使用 Python 迭代器、Node.js 可读流或 Rust 通道读取音频块。
处理音频:应用内置的调节功能,如直流去除、去噪或声学回声消除。
检测语音:启用捆绑的 Silero VAD 模型进行本地语音活动检测。
与 AI 服务集成:将原始 PCM 音频传输到语音转文本服务、语音代理或其他 AI 模型。
播放音频:使用 Decibri 的扬声器 API 通过系统扬声器播放音频。
录制到文件:使用 `record_to_file()` 进行简单音频录制或对高级用例进行完整流控制。
Decibri的使用案例
- 实时语音 AI 代理
- 语音转文本集成
- 语音活动检测
- ASR 的音频录制
- 跨平台音频应用
- 服务器端语音后端
- 关键词检测
- 全双工音频通信