描述
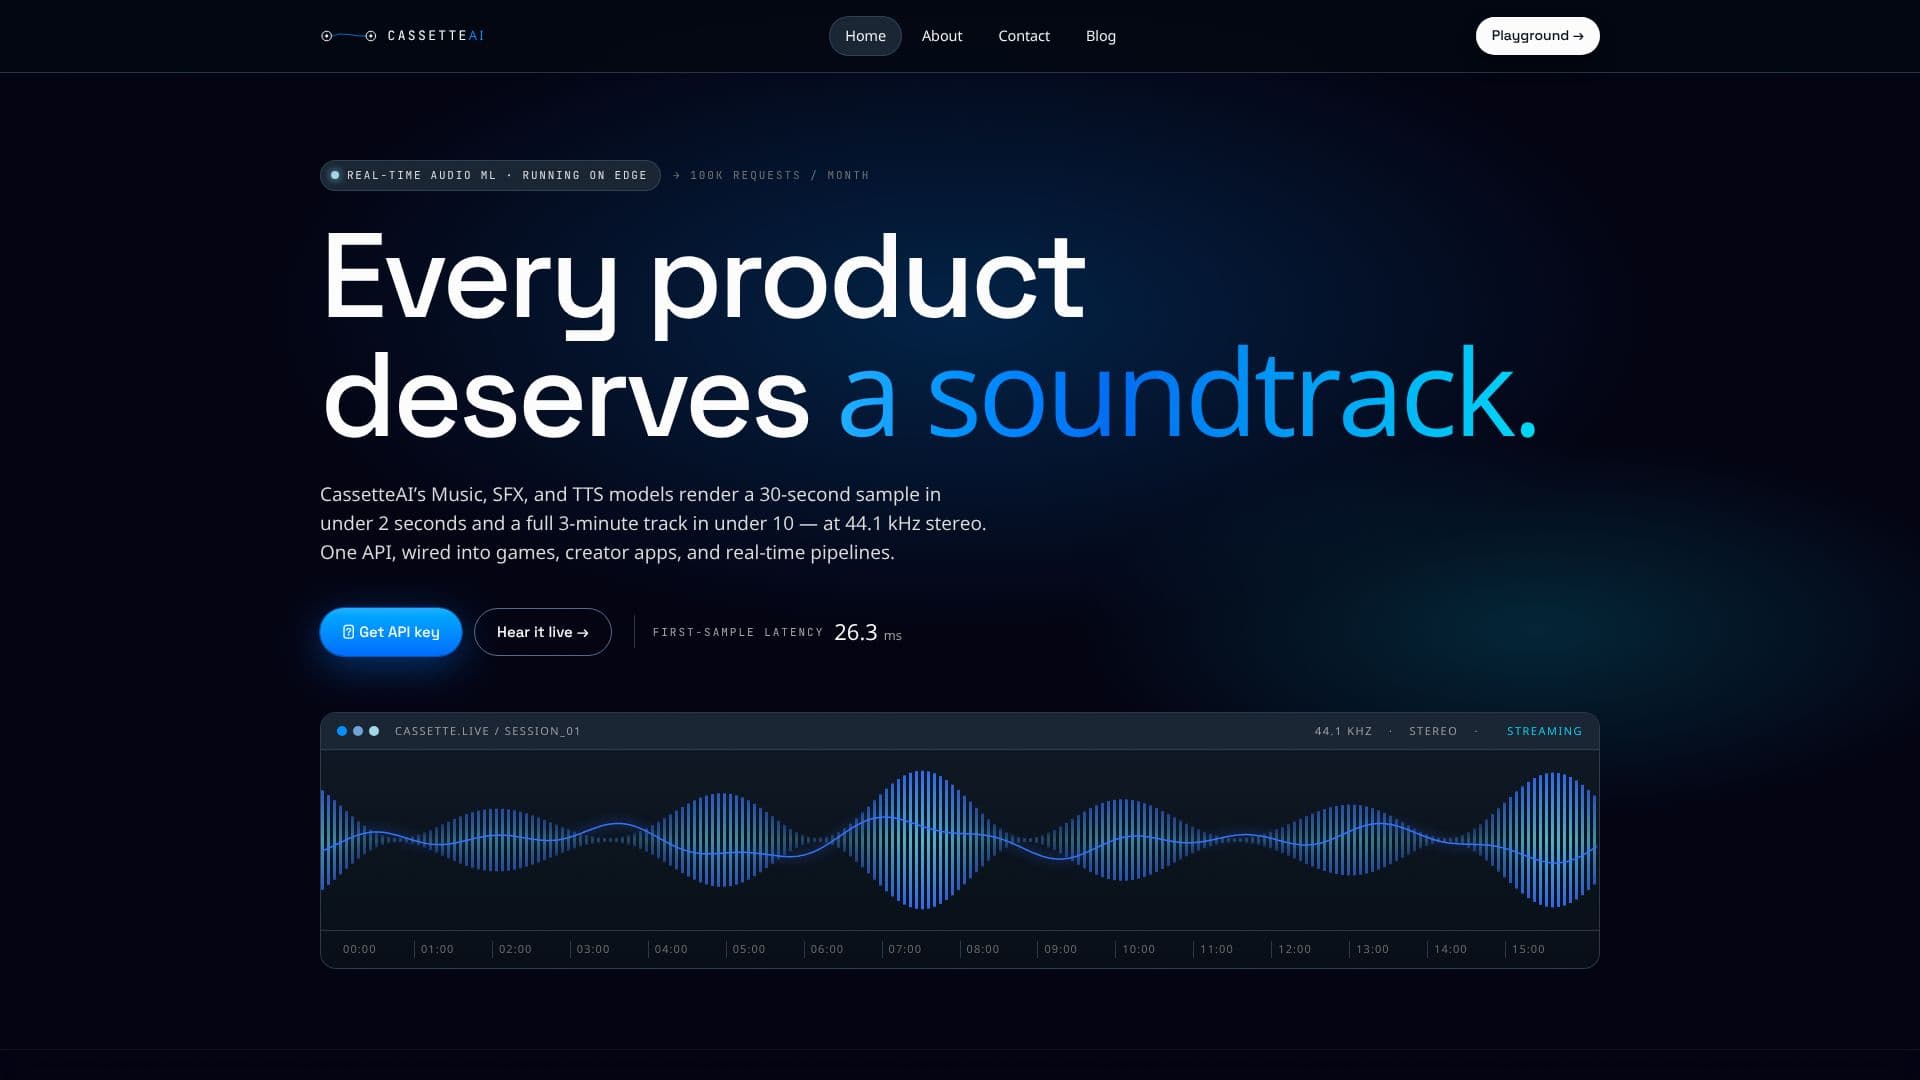
CassetteAI 直接在边缘硬件上提供实时生成音频,无需云服务器。其先进的 3 亿参数模型能够以惊人的速度和质量生成音乐、音效 (SFX) 和文本转语音 (TTS)。该系统在音效方面实现了低于 50 毫秒的首音频时间 (TTFA),并在 2 秒内渲染出 30 秒的音乐样本,完整的 3 分钟曲目可在 10 秒内完成,所有输出均为 44.1 kHz 立体声。
阅读更多
开发人员可以通过单一 SDK 集成 CassetteAI 的功能,支持三种不同的模式:基于提示(情绪、流派或参考)的自适应音乐生成;按需生成的文本描述音效,并支持每帧重新生成功能;以及即将推出的、能够从短音频样本进行零样本克隆的自然、富有表现力的 TTS。这种统一的方法简化了游戏、创作者应用和实时流水线的集成。
该平台通过一个无需注册即可立即测试的实时演示环境,强调易用性。其 API 可通过 JavaScript、Python 和 cURL 访问,允许开发人员在相同的 API 调用结构中切换音乐、音效或 TTS 的模型 ID。输出质量达到专业标准,提供 44.1 kHz 立体声、16 位保真度的 .wav 文件。
CassetteAI 采用按使用付费的定价模式,音乐按输出分钟收费(0.02 美元),音效按生成次数收费(0.01 美元),没有分级、席位或月度承诺。这种模式确保用户只需为消耗的音频付费,使其在各种应用中都具有成本效益。该公司还在开发一款具有流式输出和亚秒级首辅音延迟的 TTS 生成器,进一步扩展其实时音频生成能力。
- 类别AI 音频编辑器
- 定价模式按使用付费
- 部署本地设备
- 平台网页版
CassetteAI的核心功能
设备端实时生成音频
3 亿参数模型,支持音乐、音效和 TTS
低于 50 毫秒的首音频时间 (TTFA)
44.1 kHz 立体声音频输出
支持多种音频模式的单一 SDK
按需音效生成
自适应音乐生成
零样本 TTS 克隆(即将推出)
支持 JavaScript、Python、cURL 的 API
按使用付费定价模式
用于测试的实时演示环境
确定性种子,可复现结果
循环安全的音效输出
如何使用 CassetteAI?
访问 API:获取 API 密钥,将 CassetteAI 集成到您的应用程序中。
配置模型:通过 API 选择所需的音频模式(音乐、音效或 TTS)。
生成音频:向 API 发送提示或描述以创建音频内容。
集成输出:将生成的音频文件直接流式传输或下载到您的项目中。
优化性能:利用设备端处理实现低延迟和实时应用。
CassetteAI的使用案例
- 游戏音频
- 创作者工具
- 实时流水线
- 应用程序配乐
- 原型设计
- AR/VR 体验