描述
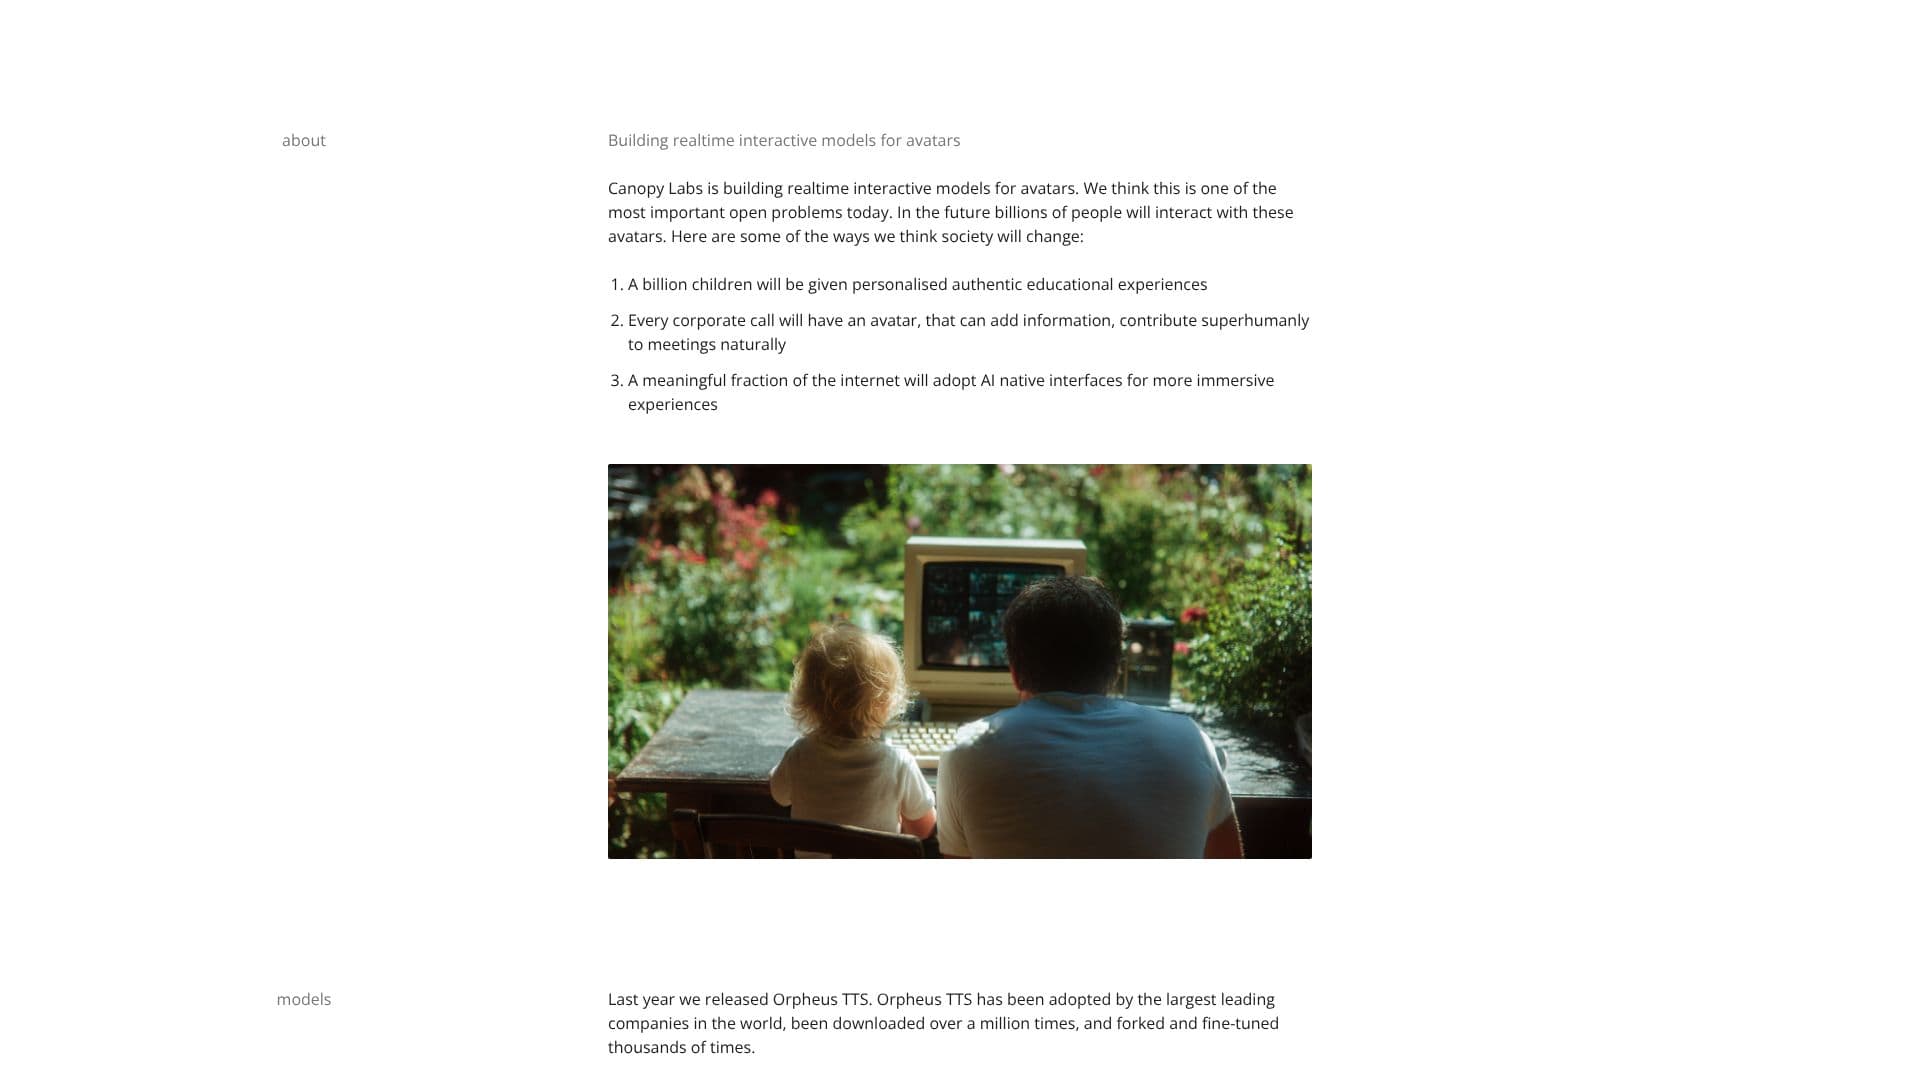
Canopy Labs将其工作描述为构建实时互动的虚拟人模型,明确表示其目标是开发与真实人类无法区分的数字人类。该公司将此视为一个开放的研究问题,预计将重塑人们与软件的互动方式,列举了个性化教育体验和参与企业会议的虚拟人等场景,作为其期望技术能够实现的方向;这些是公司自己声明的愿景,而非已发布的功能。
阅读更多
Canopy Labs之前发布了Orpheus TTS,称其已被多家公司采用,下载次数超过一百万次,并被分叉或微调了数千次(根据公司自己的数据)。自那时以来,Canopy Labs表示已筹集1700万美元,并正在开发尚未公开的进一步语音和虚拟人模型。
目前可用的产品是Orpheus v1,一个分为基础和闪电两个级别的文本转语音模型。它本地支持多种语言,包括英语、印地语、普通话、德语、日语、法语、意大利语、葡萄牙语、俄语、西班牙语和韩语,并支持在剧本中插入舞台指示,例如标记某一行的语调或情感,以塑造其表达方式。Canopy Labs表示该模型具有超低延迟,p99响应时间在基线的30毫秒内。语音库中包含超过30种预设语音,专业或一次性语音克隆可以从几小时的音频中构建自定义品牌语音。
对于企业客户,Orpheus可以在本地或私有云中部署,提供优先支持和服务水平协议,而不仅仅是通过托管API。在其网站上,Canopy Labs展示了该模型在多种预设交付风格下的表现,包括客户支持语音、自我反思语调、戏剧朗读、语言学习叙述和冥想教练语音,以展示同一模型处理不同语气的能力。Canopy Labs在其网站上未公布Orpheus的公开定价。
- 类别AI 头像生成器
- 部署云端
- 平台网页版
Canopy Labs的核心功能
文本转语音模型(Orpheus v1),分为基础和闪电两个级别
本地支持包括英语、印地语和普通话在内的十一种语言
支持插入舞台指示以控制台词的情感表达
提供专业和一次性语音克隆,可以从几小时的音频中构建自定义语音
提供超过30种预设语音的库
声称具有超低延迟,p99在基线的30毫秒内
支持带有服务水平协议的本地或私有云企业部署
研究超出已发布语音产品的实时互动虚拟人模型
如何使用 Canopy Labs?
选择模型级别:根据延迟和质量需求选择Orpheus v1基础或闪电。
选择或克隆语音:使用库中的语音或从样本音频中克隆自定义语音。
编写剧本:添加舞台指示以塑造表达方式,例如语调或情感。
选择部署方式:使用托管模型或安排本地或私有云部署。
集成输出:将生成的语音输入到产品、虚拟人或支持工作流程中。
Canopy Labs的使用案例
- 语音产品原型设计
- 客户支持语音
- 语言学习叙述
- 企业本地部署