Перейти к основному содержимому
ToolPotion
ИИ-советник
Отправить

WeMM-Video-35B-A3B

LLM#38ИИ-модели и LLMОткрытый код · Веб

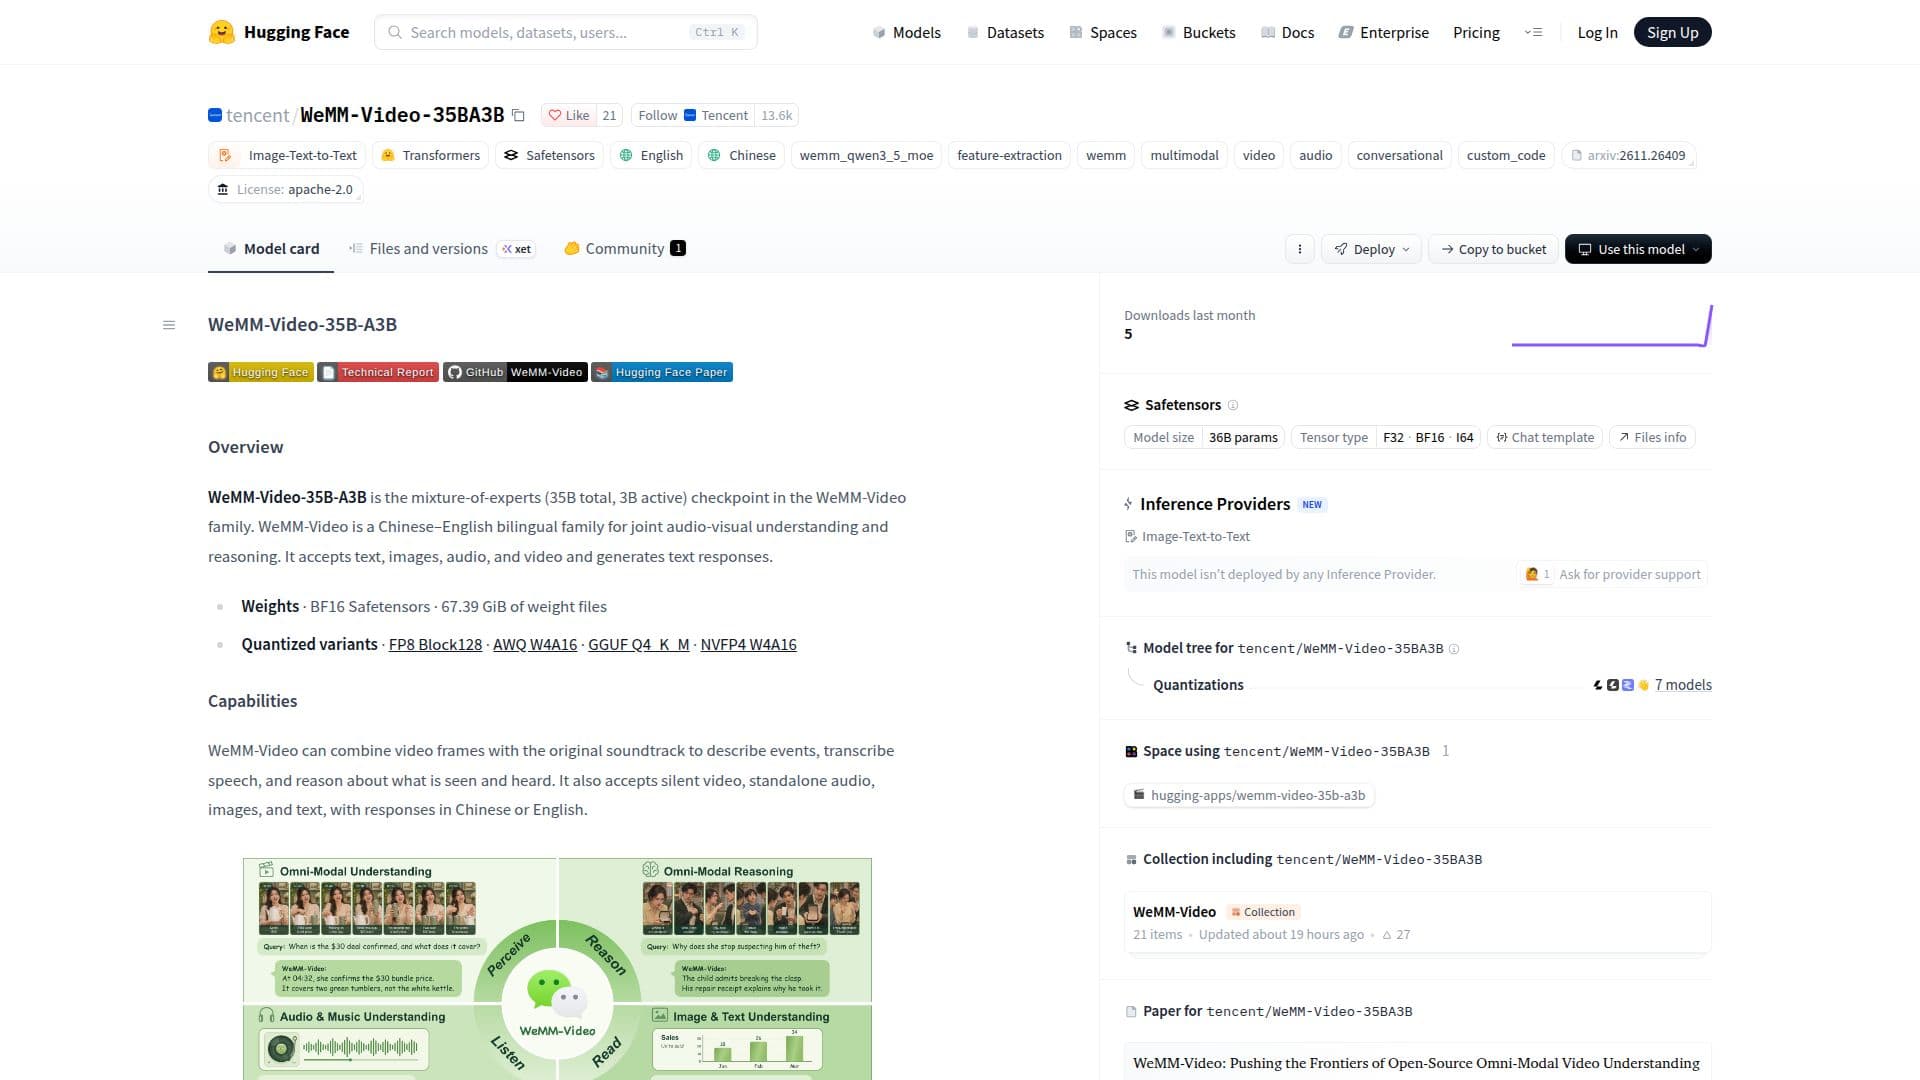
WeMM-Video-35B-A3B — это модель смешанных экспертов из семейства WeMM-Video, предназначенная для совместного аудиовизуального понимания и рассуждения. Эта двуязычная модель на китайском и английском языках принимает текстовые, изображенческие, аудио- и видеовходы для генерации текстовых ответов. Она может описывать события, транскрибировать речь и рассуждать о том, что видит и слышит, предлагая как прямые, так и рассуждающие режимы ответов.

Посетить URL
Поделиться
Скриншот WeMM-Video-35B-A3B

WeMM-Video-35B-A3B — это сложная модель смешанных экспертов, часть более широкой семьи WeMM-Video, разработанная для комплексного аудиовизуального понимания и рассуждения. С 35 миллиардами общих параметров и 3 миллиардами активных параметров, эта модель специально спроектирована для обработки и интерпретации мультимодальных входов, включая текст, изображения, аудио и видео, генерируя последовательные текстовые ответы на китайском или английском языках.

Читать далее

Основные возможности модели включают способность комбинировать видеокадры с их оригинальными звуковыми дорожками для описания событий, точно транскрибировать речь и выполнять задачи рассуждения на основе как визуальной, так и аудиальной информации. Она также достаточно универсальна, чтобы обрабатывать беззвучное видео, отдельное аудио, изображения и текстовые входы независимо. Это делает её подходящей для широкого спектра приложений, требующих глубокого контекстуального понимания различных типов медиа.

Архитектурно WeMM-Video-35B-A3B использует кодировщики видео и аудио для преобразования медиа-входов в токены, которые затем обрабатываются языковой моделью вместе с текстом. Видеокадры обогащаются временными метками для поддержания временного контекста. Семейство моделей прошло обширное предварительное обучение на примерно 1,2 триллиона мультимодальных токенов, за которым последовали продвинутые методы постобучения, такие как многопедагогический OPD, антиповторный MrDPO и специализированное обучение с подкреплением для повышения производительности и надежности.

Развертывание и интеграция упрощаются благодаря различным вариантам обслуживания. Пользователи могут настроить окружение Transformers и запускать примеры непосредственно из репозитория WeMM-Video. Модель поддерживает квантизированные варианты, такие как FP8 Block128, AWQ W4A16, GGUF Q4_K_M и NVFP4 W4A16. Для обслуживания она совместима с исправленными версиями vLLM (0.18.0 и 0.31.0) и SGLang (0.5.16 или 0.5.19), что позволяет эффективно выполнять вывод, включая тензорный параллелизм на нескольких GPU. Модель также предлагает различные режимы чата, включая режим по умолчанию «Инструкция» и «Режим размышлений» для ответов на рассуждения.

WeMM-Video-35B-A3B продемонстрировала высокую производительность, установив новый открытый стандарт. Она показала лучшие результаты по сравнению с проприетарными моделями, такими как Qwen3.5-Omni-Flash и Seed2.0-Mini-0428, значительно сократив разрыв в производительности с продвинутыми моделями, такими как Gemini-3.0-Flash. Модель выпущена под лицензией Apache 2.0, способствуя открытому доступу и сотрудничеству в сообществе ИИ.

  • КатегорияИИ-модели и LLM
  • Модель ценообразованияОткрытый код
  • РазвёртываниеОблако
  • ПлатформыВеб

  • Двуязычная обработка на китайском и английском языках

  • Совместное аудиовизуальное понимание и рассуждение

  • Принимает текстовые, изображенческие, аудио- и видеовходы

  • Генерирует текстовые ответы

  • Описывает события из видеокадров и звуковых дорожек

  • Транскрибирует речь из аудио

  • Рассуждает о визуальной и аудиальной информации

  • Поддерживает обработку беззвучного видео и отдельного аудио

  • Архитектура смешанных экспертов (35B всего, 3B активных параметров)

  • Предварительно обучена на 1,2 триллиона мультимодальных токенов

  • Постобучена с использованием многопедагогического OPD и MrDPO

  • Специализированное обучение с подкреплением для повышения производительности

  • Поддерживает различные квантизированные варианты (FP8, AWQ, GGUF, NVFP4)

  • Совместима с исправленными версиями vLLM и SGLang для обслуживания

  • Предлагает режимы чата Инструкция и Размышления

  1. Настройка окружения: Установите окружение Transformers и необходимые зависимости.

  2. Загрузка модели: Загрузите модель WeMM-Video-35B-A3B и процессор из Hugging Face Hub.

  3. Подготовка входов: Предоставьте медиа-входы, такие как MP4-видеофайлы, отдельное аудио, изображения или текст.

  4. Обработка медиа: Используйте скрипт для обработки видеокадров отдельно или с оригинальной звуковой дорожкой.

  5. Генерация ответов: Отправьте запросы к модели, указывая режим чата (Инструкция или Размышления) для генерации текста.

  6. Обслуживание модели (по желанию): Установите патч WeMM runtime и используйте исправленные версии vLLM или SGLang для API обслуживания.

  7. Отправка API-запросов: Используйте встроенный клиент запросов для отправки медиа встраиваемым образом в конечную точку чата, совместимую с OpenAI.

  • Анализ видеоконтента
  • Транскрипция речи
  • Мультимодальное рассуждение
  • Обработка двуязычного контента
  • Описание аудиовизуальных событий
  • Разработка ИИ моделей
  • Исследования и эксперименты
Популярные ИИ-инструменты, похожие на WeMM-Video-35B-A3B

Llama-3.2-11B-Vision-Instruct — это мультимодальная модель ИИ, предназначенная для визуального распознавания, логического анализа изображений и создания подписей. Разработанная…

ИИ-модели и LLM
Открыть инструмент

Мультимодальная модель ИИ, предназначенная для визуального распознавания, логического анализа изображений и создания подписей. Разработанная…Llama-3.2-11B-Vision-Instruct — это мультимодальная модель ИИ, предназначенная для визуального распознавания, логического анализа изображений и создания подписей. Разработанная…

ИИ-модели и LLM
Топ-5: AI-модели

Step 3.7 Flash — это разреженная модель смешанной экспертизы (Mixture-of-Experts) для обработки изображений и языка, предназначенная для высокочастотных производственных задач.…

ИИ-модели и LLM

№81 в LLM

Открыть инструмент

Разреженная модель смешанной экспертизы (Mixture-of-Experts) для обработки изображений и языка, предназначенная для высокочастотных производственных задач.…Step 3.7 Flash — это разреженная модель смешанной экспертизы (Mixture-of-Experts) для обработки изображений и языка, предназначенная для высокочастотных производственных задач.…

ИИ-модели и LLM
№81 в LLM

Apertus 1.5 — это семейство многоязычных, мультимодальных языковых моделей, разработанных для поддержки широкого спектра языков и контекстов. Оно предлагает открытый доступ и…

ИИ-модели и LLM

№72 в LLM

Открыть инструмент

Семейство многоязычных, мультимодальных языковых моделей, разработанных для поддержки широкого спектра языков и контекстов. Оно предлагает открытый доступ и…Apertus 1.5 — это семейство многоязычных, мультимодальных языковых моделей, разработанных для поддержки широкого спектра языков и контекстов. Оно предлагает открытый доступ и…

ИИ-модели и LLM
№72 в LLM

Llama-4 Maverick 17B-128E Instruct — это мультимодальная модель ИИ, разработанная компанией Meta, предназначенная для продвинутого понимания текста и изображений. Она использует…

ИИ-модели и LLM
Открыть инструмент

Мультимодальная модель ИИ, разработанная компанией Meta, предназначенная для продвинутого понимания текста и изображений. Она использует…Llama-4 Maverick 17B-128E Instruct — это мультимодальная модель ИИ, разработанная компанией Meta, предназначенная для продвинутого понимания текста и изображений. Она использует…

ИИ-модели и LLM
Топ-5: AI-модели

Nemotron-Labs-Audex-2B — это унифицированная модель большого языка, предназначенная для аудиозадач, таких как понимание, распознавание и перевод. Она поддерживает как режимы…

ИИ-модели и LLM

№33 в LLM

Открыть инструмент

Унифицированная модель большого языка, предназначенная для аудиозадач, таких как понимание, распознавание и перевод. Она поддерживает как режимы…Nemotron-Labs-Audex-2B — это унифицированная модель большого языка, предназначенная для аудиозадач, таких как понимание, распознавание и перевод. Она поддерживает как режимы…

ИИ-модели и LLM
№33 в LLM

Gemini 3.1 Pro — это продвинутая модель ИИ, разработанная для сложных задач и глубокого рассуждения. Она превосходно справляется с мультимодальным пониманием, предоставляя умные и…

ИИ-модели и LLM
Открыть инструмент

Продвинутая модель ИИ, разработанная для сложных задач и глубокого рассуждения. Она превосходно справляется с мультимодальным пониманием, предоставляя умные и…Gemini 3.1 Pro — это продвинутая модель ИИ, разработанная для сложных задач и глубокого рассуждения. Она превосходно справляется с мультимодальным пониманием, предоставляя умные и…

РекомендованоИИ-модели и LLM
Топ-5: AI-модели

Llama-4-Scout-17B-16E-Instruct — это мультимодальная модель ИИ, разработанная компанией Meta. Она использует архитектуру смешанных экспертов для обеспечения продвинутых…

ИИ-модели и LLM
Открыть инструмент

Мультимодальная модель ИИ, разработанная компанией Meta. Она использует архитектуру смешанных экспертов для обеспечения продвинутых…Llama-4-Scout-17B-16E-Instruct — это мультимодальная модель ИИ, разработанная компанией Meta. Она использует архитектуру смешанных экспертов для обеспечения продвинутых…

ИИ-модели и LLM
Топ-5: AI-модели

Qwen3-VL

AI-репозитории на GitHub

Qwen3-VL — это серия моделей, объединяющих визуальные и языковые возможности, разработанная командой Qwen компании Alibaba Cloud. Она представлена в размерах Dense и…

ИИ-модели и LLM
Открыть инструмент

AI-репозитории на GitHub

Серия моделей, объединяющих визуальные и языковые возможности, разработанная командой Qwen компании Alibaba Cloud. Она представлена в размерах Dense и…Qwen3-VL — это серия моделей, объединяющих визуальные и языковые возможности, разработанная командой Qwen компании Alibaba Cloud. Она представлена в размерах Dense и…

ИИ-модели и LLM
Топ-250: AI-репозитории на GitHub
1 из 8