Описание
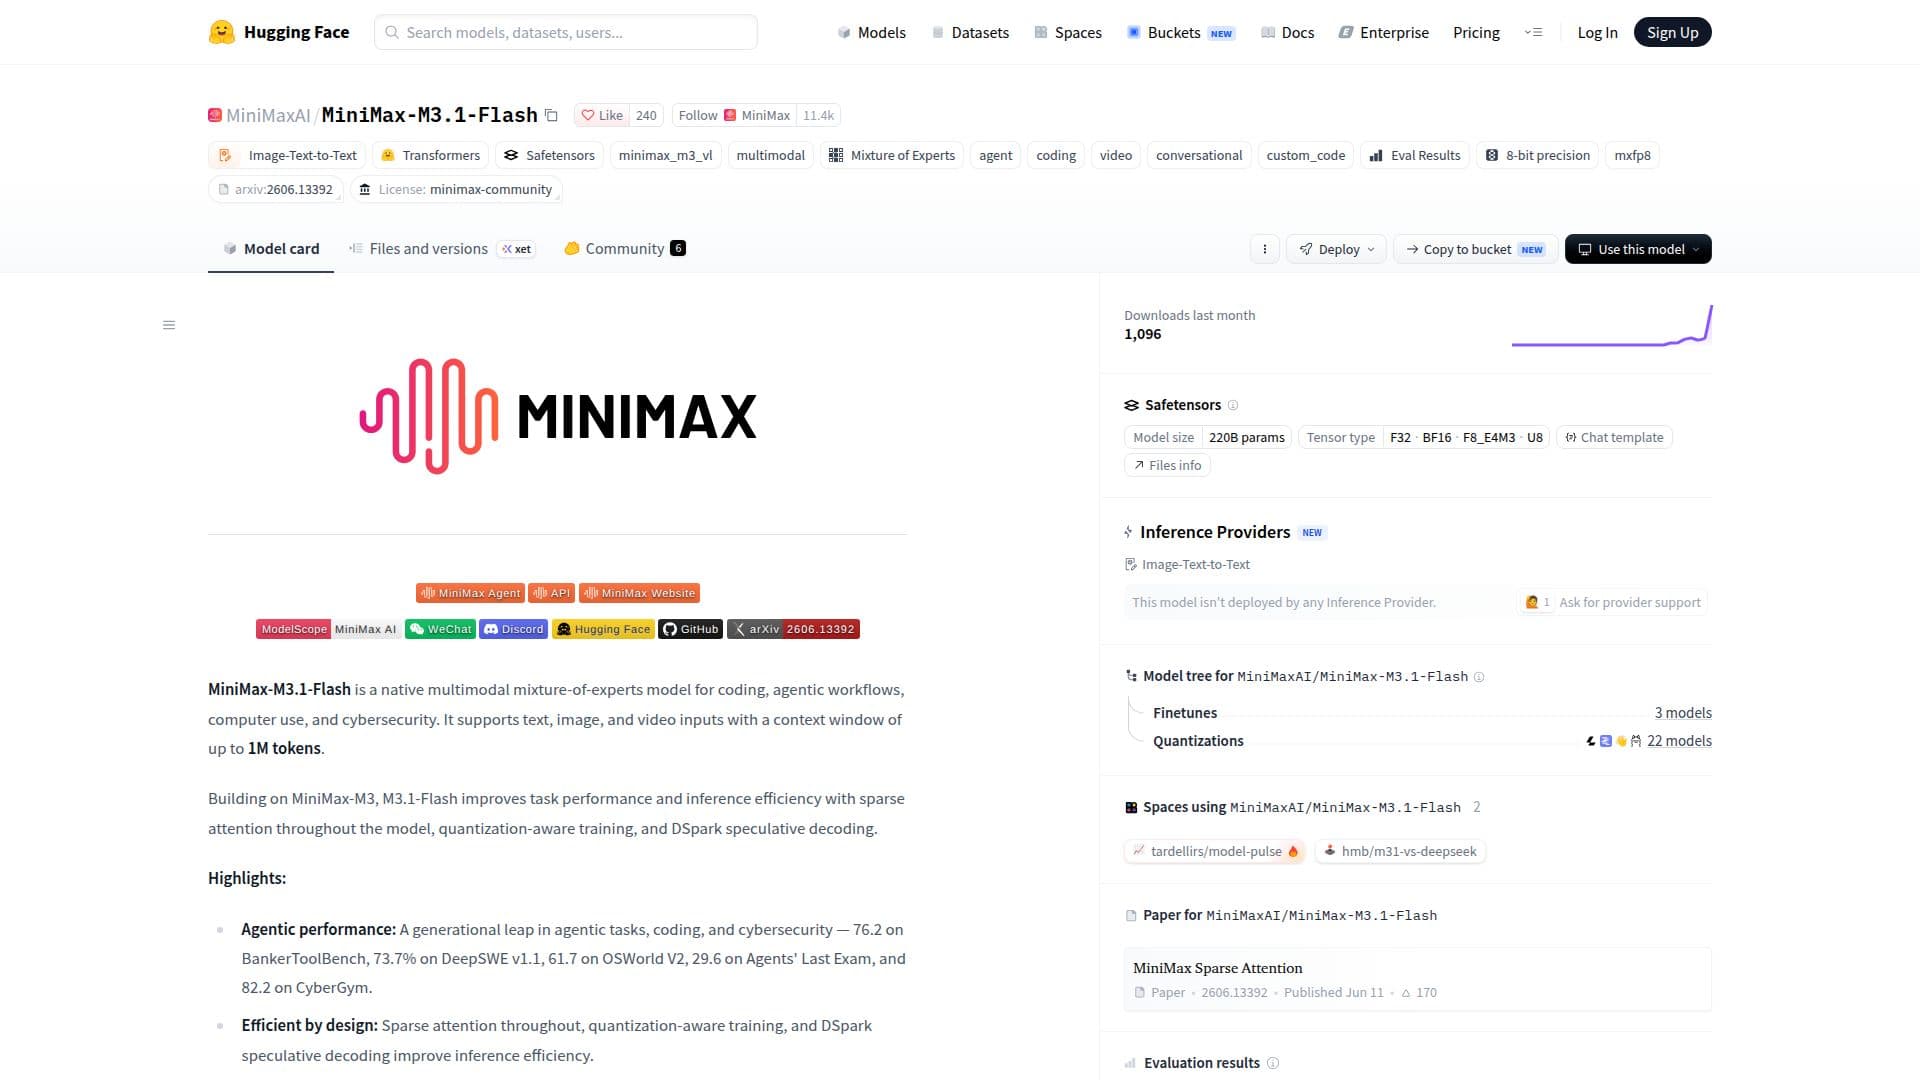
MiniMax-M3.1-Flash — это продвинутая многомодальная модель смешанных экспертов, разработанная для улучшения кодирования, агентных рабочих процессов, использования компьютеров и кибербезопасности. Эта модель поддерживает текстовые, графические и видеовходы, предоставляя контекстное окно до 1 миллиона токенов. Основываясь на архитектуре MiniMax-M3, M3.1-Flash вводит улучшения в производительности задач и эффективности вывода за счет использования разреженного внимания по всей модели, обучения с учетом квантования и спекулятивного декодирования DSpark.
Читать далее
Архитектура модели разработана для обработки широкого спектра входных и выходных данных, с примерно 428 миллиардами параметров, из которых 23 миллиарда активируются на токен. Это позволяет эффективно обрабатывать данные и достигать высокой производительности по различным бенчмаркам, включая 76.2 на BankerToolBench и 82.2 на CyberGym.
M3.1-Flash особенно отмечается за свою агентную производительность, предлагая качественный скачок в задачах, связанных с кодированием и кибербезопасностью. Она достигает высоких оценок по нескольким бенчмаркам, таким как 73.7% на DeepSWE v1.1 и 61.7 на OSWorld V2. Эффективность модели дополнительно повышается такими функциями, как разреженное внимание и обучение с учетом квантования, которые уменьшают объем памяти и улучшают эффективность обслуживания.
Для развертывания MiniMax-M3.1-Flash поддерживает различные фреймворки вывода, включая SGLang, vLLM и TokenSpeed, с дополнительными интеграциями в процессе. Модель разработана для многочипового развертывания, предлагая гибкость в конфигурациях обслуживания. Пользователи могут настраивать параметры вывода, такие как температура и top_p, для оптимизации производительности для конкретных задач.
В целом, MiniMax-M3.1-Flash — это мощный инструмент для разработчиков и исследователей, стремящихся использовать передовые возможности ИИ в многомодальных контекстах, обеспечивая надежную поддержку для сложных рабочих процессов и приложений в области кибербезопасности.
- КатегорияИИ-модели и LLM
- Модель ценообразованияОткрытый код
- РазвёртываниеОблако
- ПлатформыВеб
Главное о MiniMax-M3.1-Flash
Архитектура многомодальной модели смешанных экспертов
Поддержка текстовых, графических и видеовходов
Контекстное окно до 1 миллиона токенов
Разреженное внимание по всей модели
Обучение с учетом квантования
Спекулятивное декодирование DSpark
Приблизительно 428 миллиардов параметров
Высокая производительность по нескольким бенчмаркам
Начало работы с MiniMax-M3.1-Flash
Доступ к странице модели: посетите официальную страницу Hugging Face для MiniMax-M3.1-Flash
Аутентификация: убедитесь, что у вас есть необходимые учетные данные для доступа к модели
Настройка: настройте модель с вашим предпочтительным фреймворком вывода
Отправка запросов: введите текстовые, графические или видеоданные для обработки
Тонкая настройка: отрегулируйте параметры, такие как температура и top_p, для достижения оптимальных результатов
Варианты использования MiniMax-M3.1-Flash
- Помощь в кодировании
- Кибербезопасность
- Агентные рабочие процессы
- Многомодальная обработка
- Эффективность вывода