Перейти к основному содержимому
ToolPotion
ИИ-советник
Отправить

ERNIE-5.5-Flash-Base-BF16

ERNIE-5.5-Flash-Base-BF16 — это эффективная разреженная языковая модель Mixture-of-Experts (MoE) с 280 миллиардами параметров. Предобучена на 33,5 триллионах токенов, поддерживает дообучение и вывод с контекстом в 1 миллион токенов. Эта модель предназначена для различных приложений, включая адаптацию к домену, настройку инструкций и исследования в области обучения с подкреплением, обеспечивая высокую производительность по множеству бенчмарков.

Посетить URL
Поделиться
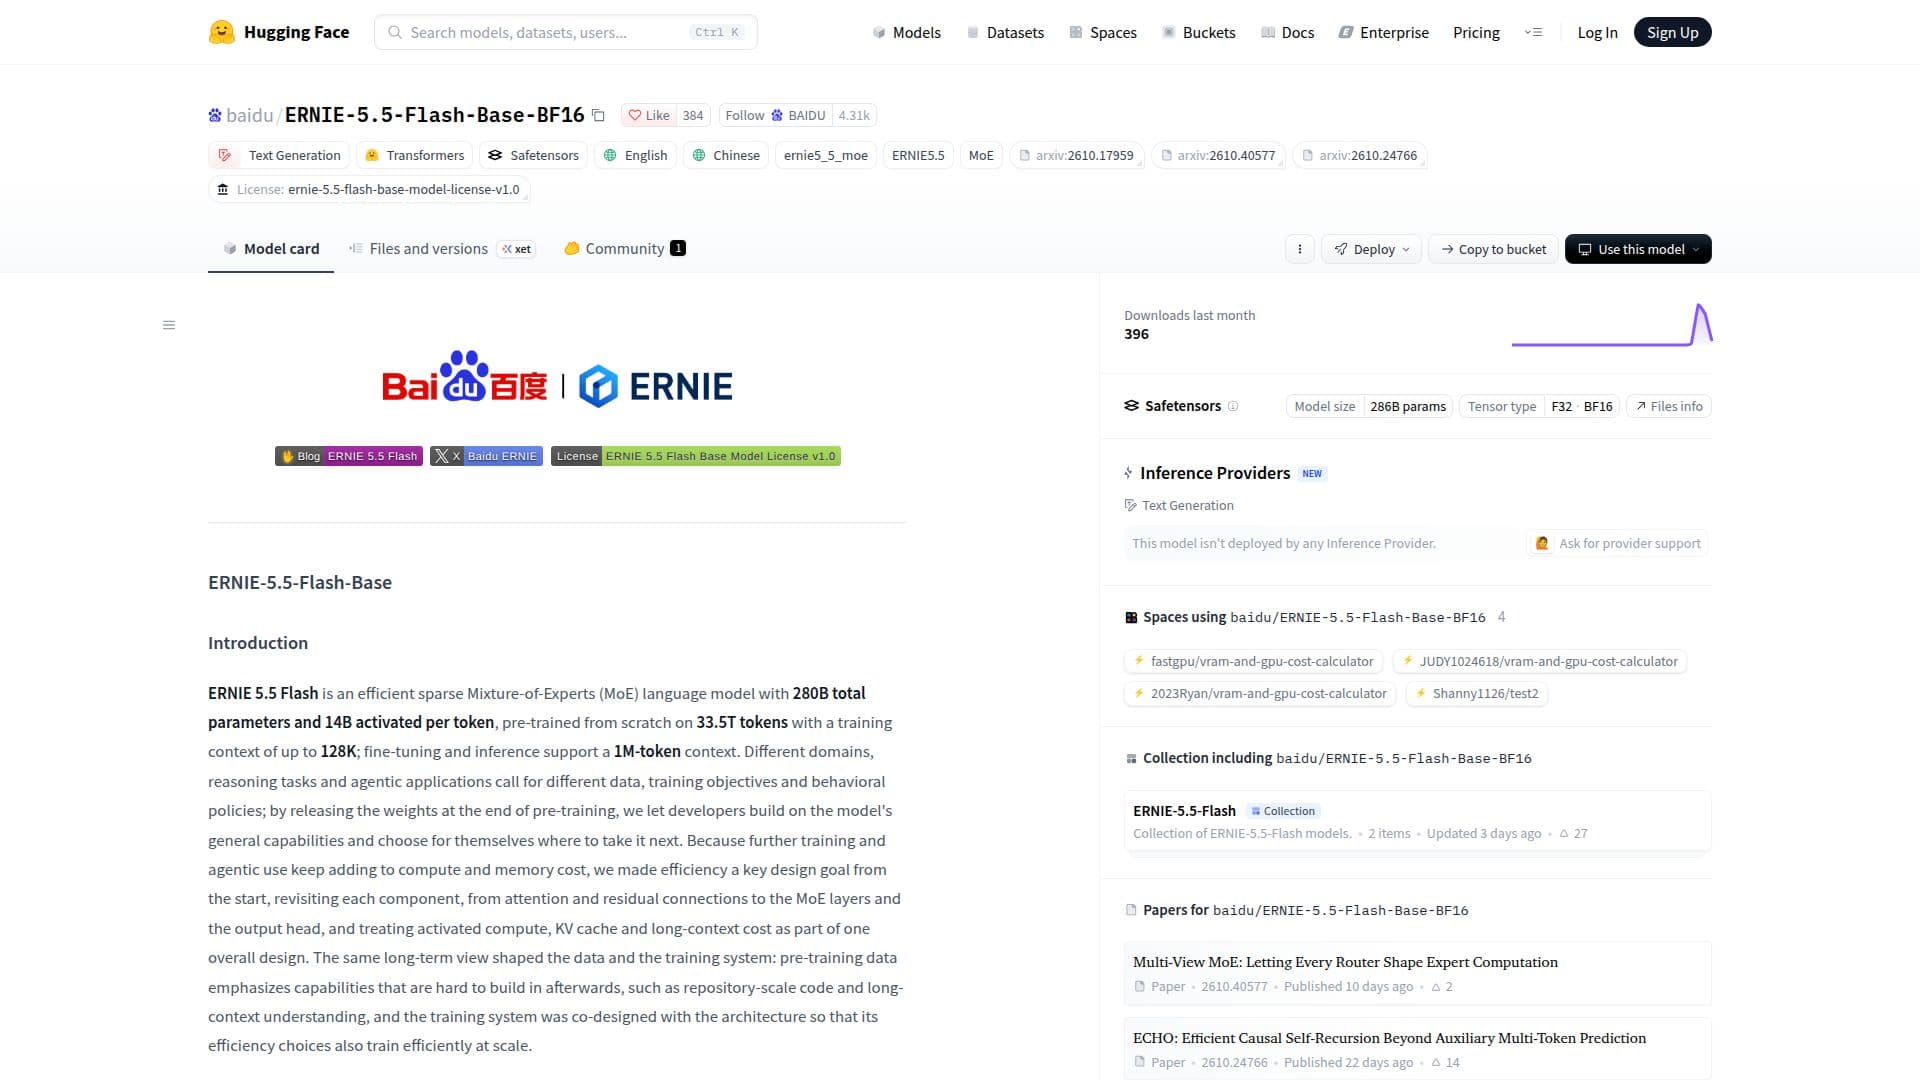
Скриншот ERNIE-5.5-Flash-Base-BF16

ERNIE-5.5-Flash-Base-BF16 — это сложная разреженная языковая модель Mixture-of-Experts (MoE), разработанная компанией Baidu. Она имеет значительное количество параметров — 280 миллиардов, из которых 14 миллиардов активируются на токен, что делает её высокоэффективной для сложных языковых задач. Модель была предобучена с нуля на обширном наборе данных из 33,5 триллионов токенов, используя контекст обучения до 128 000 токенов. Для дообучения и вывода она поддерживает впечатляющую длину контекста в 1 миллион токенов, что позволяет глубоко понимать и генерировать длинные тексты.

Читать далее

Разработанная с акцентом на эффективность, ERNIE 5.5 Flash пересматривает каждый компонент, начиная от механизмов внимания и остаточных соединений до слоев MoE и выходного узла. Этот целостный подход обеспечивает оптимальную производительность при управлении вычислениями, кэшированием KV и затратами на длинный контекст. Данные для предобучения акцентируют внимание на возможностях, критически важных для продвинутых приложений, таких как понимание кода на уровне репозитория и понимание длинного контекста, позволяя разработчикам строить на основе её общих возможностей для разнообразных случаев использования.

ERNIE-5.5-Flash-Base-BF16 представляет собой контрольную точку в конце предобучения, служащую основой перед любыми этапами промежуточного или постобучения. Это делает её идеальной отправной точкой для исследователей и разработчиков, занимающихся адаптацией к домену, настройкой инструкций и обучением с подкреплением. Модель продемонстрировала сильные результаты в единой оценочной системе, превосходя в бенчмарках, связанных с знаниями, рассуждениями, математикой, кодом, многоязычными задачами и пониманием длинного контекста.

Архитектура включает в себя гибридное внимание MoE 280B-A14B с 43 слоями, включая 1 плотный FFN и 42 слоя Multi-Router Latent MoE. Она содержит 37 слоев сильно сжатого внимания (HCA) и 6 слоев многоуровневого латентного внимания (MLA + DSA) с разреженным вниманием. Модель использует 512 маршрутизируемых экспертов (топ-10) плюс 1 общего эксперта на слой MoE. Инновации, такие как низкоранговое управляемое внимание, внимание виртуальной головы (VHA), многоуровневое латентное MoE, ECHO, гиперсвязи с ограничениями многообразия (mHC) и выходная голова MultiMax, способствуют её продвинутым возможностям и эффективности. Токенизатор поддерживает примерно 200 000 записей и токенизирует числа справа налево группами до трех цифр.

Развертывание поддерживается с помощью SGLang и vLLM, что позволяет производить обслуживание с длиной контекста до 1 048 576 токенов. Модель доступна по лицензии ERNIE 5.5 Flash Base Model License Agreement v1.0.

  • КатегорияИИ-модели и LLM
  • РазвёртываниеОблако
  • ПлатформыВеб

  • 280 миллиардов параметров

  • 14 миллиардов активированных параметров на токен

  • Предобучена на 33,5 триллионах токенов

  • Контекст обучения до 128 000 токенов

  • Поддержка дообучения и вывода с контекстом в 1 миллион токенов

  • Эффективная разреженная архитектура Mixture-of-Experts (MoE)

  • Гибридное внимание MoE с 43 слоями

  • 37 слоев сильно сжатого внимания (HCA)

  • 6 слоев многоуровневого латентного внимания (MLA + DSA)

  • 512 маршрутизируемых экспертов (топ-10) плюс 1 общий эксперт на слой MoE

  • Низкоранговое управляемое внимание и внимание виртуальной головы (VHA)

  • Многоуровневое латентное MoE для точного выбора экспертов

  • ECHO для многогранной потери и спекулятивного декодирования

  • Гиперсвязи с ограничениями многообразия (mHC) для распространения сигнала

  • Выходная голова MultiMax для уточненного распределения словаря

  • Приблизительно 200 000-записный токенизатор BPE

  • Поддержка SGLang и vLLM для производственного обслуживания

  1. Доступ к странице модели: Перейдите на страницу ERNIE-5.5-Flash-Base-BF16 на Hugging Face.

  2. Изучите файлы: Просмотрите файлы модели и документацию, доступные на странице.

  3. Скачайте модель: Скачайте контрольную точку модели ERNIE-5.5-Flash-Base-BF16.

  4. Установите vLLM и плагин: Установите vLLM и плагин ERNIE 5.5 для развертывания.

  5. Запустите сервер: Используйте SGLang или vLLM для запуска сервера модели.

  6. Отправьте запросы: Отправьте запросы на конечную точку завершений, используя такие инструменты, как curl, для вывода.

  • Генерация текста
  • Адаптация к домену
  • Настройка инструкций
  • Исследования в области обучения с подкреплением
  • Понимание кода
  • Понимание длинного контекста
  • Многоязычные приложения
  • Задачи рассуждения
  • Агентные приложения

От Baidu

Модель в Baidu Wenxin Assistant.

Отзывы о ERNIE-5.5-Flash-Base-BF16

Загрузка...

Популярные ИИ-инструменты, похожие на ERNIE-5.5-Flash-Base-BF16

ERNIE-5.5-Flash-Base — это эффективная разреженная языковая модель Mixture-of-Experts (MoE) с 280 миллиардами параметров, предназначенная для генерации текста. Предварительно…

ИИ-модели и LLM
Открыть инструмент

Эффективная разреженная языковая модель Mixture-of-Experts (MoE) с 280 миллиардами параметров, предназначенная для генерации текста. Предварительно…ERNIE-5.5-Flash-Base — это эффективная разреженная языковая модель Mixture-of-Experts (MoE) с 280 миллиардами параметров, предназначенная для генерации текста. Предварительно…

ИИ-модели и LLM
Топ-100: LLM

DeepSeek-V4-Pro — это продвинутая AI модель, разработанная для эффективного анализа контекста на миллионы токенов. Она имеет гибридную архитектуру внимания и предварительно…

ИИ-модели и LLM
Открыть инструмент

Продвинутая AI модель, разработанная для эффективного анализа контекста на миллионы токенов. Она имеет гибридную архитектуру внимания и предварительно…DeepSeek-V4-Pro — это продвинутая AI модель, разработанная для эффективного анализа контекста на миллионы токенов. Она имеет гибридную архитектуру внимания и предварительно…

РекомендованоИИ-модели и LLM
Топ-100: LLM

DeepSeek-V3 — это языковая модель Mixture-of-Experts с 671 миллиардом параметров, разработанная для эффективного вывода и экономичного обучения. Она демонстрирует отличные…

ИИ-модели и LLM

№42 в LLM

Открыть инструмент

Языковая модель Mixture-of-Experts с 671 миллиардом параметров, разработанная для эффективного вывода и экономичного обучения. Она демонстрирует отличные…DeepSeek-V3 — это языковая модель Mixture-of-Experts с 671 миллиардом параметров, разработанная для эффективного вывода и экономичного обучения. Она демонстрирует отличные…

РекомендованоИИ-модели и LLM
№42 в LLM

DeepSeek-V4-Pro-DSpark — это продвинутая языковая модель с гибридной архитектурой внимания и многообразно ограниченными гиперсвязями. Она поддерживает длину контекста в один…

ИИ-модели и LLM

№71 в LLM

Открыть инструмент

Продвинутая языковая модель с гибридной архитектурой внимания и многообразно ограниченными гиперсвязями. Она поддерживает длину контекста в один…DeepSeek-V4-Pro-DSpark — это продвинутая языковая модель с гибридной архитектурой внимания и многообразно ограниченными гиперсвязями. Она поддерживает длину контекста в один…

ИИ-модели и LLM
№71 в LLM

AliceAI-Foundation-80B-A3B-Base — это базовая языковая модель с гибридной архитектурой и слоями MoE, содержащая 80 миллиардов параметров. Она превосходно справляется с задачами…

ИИ-модели и LLM

№29 в LLM

Открыть инструмент

Базовая языковая модель с гибридной архитектурой и слоями MoE, содержащая 80 миллиардов параметров. Она превосходно справляется с задачами…AliceAI-Foundation-80B-A3B-Base — это базовая языковая модель с гибридной архитектурой и слоями MoE, содержащая 80 миллиардов параметров. Она превосходно справляется с задачами…

ИИ-модели и LLM
№29 в LLM

Ling-3.0-flash — это модель гибридного рассуждения следующего поколения, разработанная для эффективности и производительности. С 124 миллиардами параметров она превосходно…

ИИ-модели и LLM

№65 в LLM

Открыть инструмент

Модель гибридного рассуждения следующего поколения, разработанная для эффективности и производительности. С 124 миллиардами параметров она превосходно…Ling-3.0-flash — это модель гибридного рассуждения следующего поколения, разработанная для эффективности и производительности. С 124 миллиардами параметров она превосходно…

ИИ-модели и LLM
№65 в LLM

DeepSeek-V3

AI-репозитории на GitHub

DeepSeek-V3 — это языковая модель Mixture-of-Experts с открытыми весами от DeepSeek, содержащая 671 миллиард параметров и 37 миллиардов активированных на токен. Предварительно…

ИИ-модели и LLM
Открыть инструмент

AI-репозитории на GitHub

Языковая модель Mixture-of-Experts с открытыми весами от DeepSeek, содержащая 671 миллиард параметров и 37 миллиардов активированных на токен. Предварительно…DeepSeek-V3 — это языковая модель Mixture-of-Experts с открытыми весами от DeepSeek, содержащая 671 миллиард параметров и 37 миллиардов активированных на токен. Предварительно…

ИИ-модели и LLM
Топ-250: AI-репозитории на GitHub

Kimi-K2-Instruct — это современная языковая модель с использованием смеси экспертов, предназначенная для сложных задач ИИ. Она превосходно справляется с рассуждениями,…

ИИ-модели и LLM

№51 в LLM

Открыть инструмент

Kimi-K2-Instruct — это современная языковая модель с использованием смеси экспертов, предназначенная для сложных задач ИИ. Она превосходно справляется с рассуждениями,…

ИИ-модели и LLM
№51 в LLM
1 из 8