Перейти к основному содержимому
ToolPotion
ИИ-советник
Отправить

ERNIE-5.5-Flash-Base

LLMИИ-модели и LLMОткрытый код · Веб

ERNIE-5.5-Flash-Base — это эффективная разреженная языковая модель Mixture-of-Experts (MoE) с 280 миллиардами параметров, предназначенная для генерации текста. Предварительно обученная на 33,5 триллионах токенов, она поддерживает дообучение и вывод с контекстом в 1 миллион токенов. Эта модель служит надежной отправной точкой для адаптации к домену, настройки инструкций и исследований в области обучения с подкреплением, демонстрируя высокую производительность по различным бенчмаркам.

Посетить URL
Поделиться
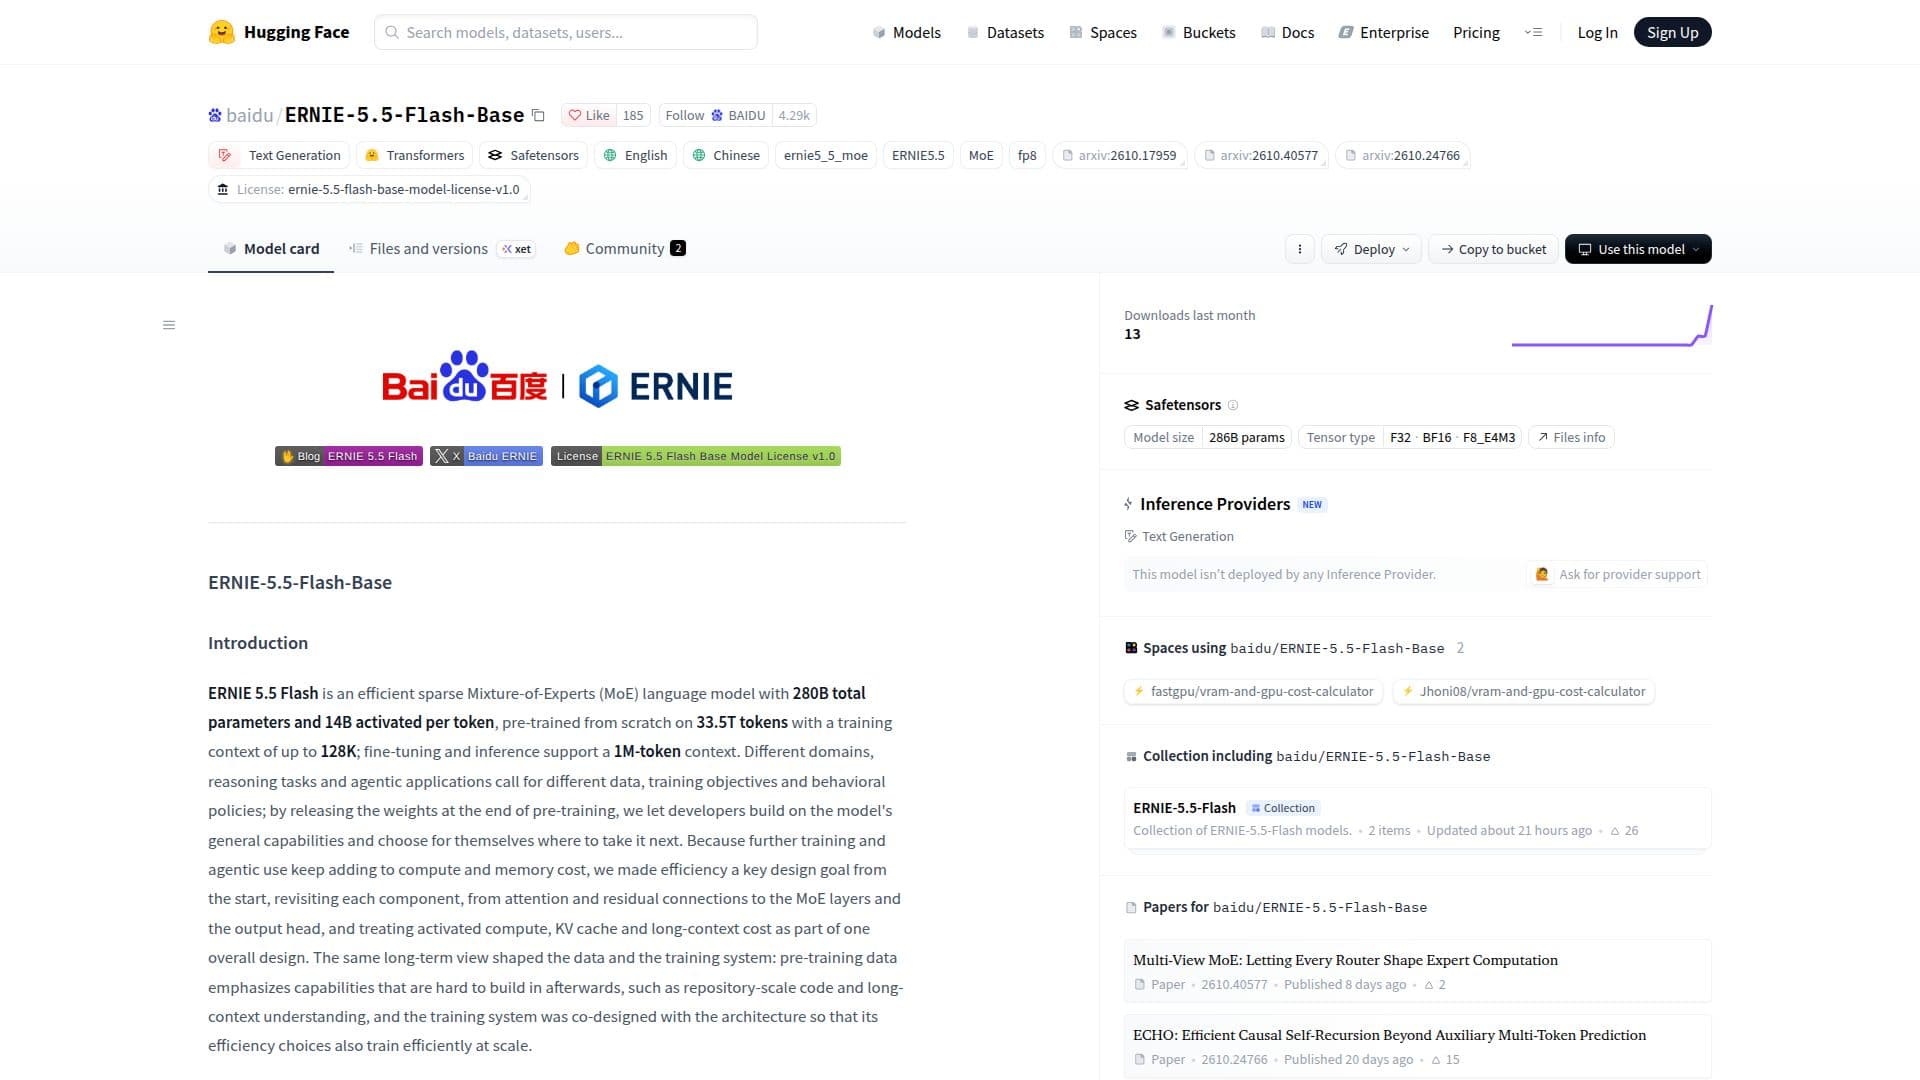
Скриншот ERNIE-5.5-Flash-Base

ERNIE-5.5-Flash-Base — это сложная модель генерации текста, разработанная компанией Baidu и доступная на Hugging Face. Это эффективная разреженная языковая модель Mixture-of-Experts (MoE), содержащая 280 миллиардов параметров, из которых 14 миллиардов активируются на токен. Модель была предварительно обучена с нуля на обширном наборе данных из 33,5 триллионов токенов, используя контекст обучения до 128K. Для дообучения и вывода она поддерживает впечатляющую длину контекста в 1 миллион токенов.

Читать далее

Разработанная с акцентом на эффективность, ERNIE 5.5 Flash пересматривает каждый компонент, начиная от механизмов внимания и остаточных соединений до слоев MoE и выходного узла. Этот целостный подход учитывает активированные вычисления, кэш KV и затраты на длинный контекст как часть интегрированного дизайна. Данные для предварительного обучения подчеркивают возможности, которые сложно развить после обучения, такие как понимание кода на уровне репозитория и понимание длинного контекста. Система обучения была совместно спроектирована с архитектурой для обеспечения эффективного масштабирования.

ERNIE-5.5-Flash-Base представляет собой контрольную точку в конце предварительного обучения, что делает ее идеальной основой для разработчиков. Она позволяет адаптировать модель к домену, настраивать инструкции и проводить исследования в области обучения с подкреплением. Модель демонстрирует сильные результаты в рамках единой оценки, охватывающей знания, рассуждения, математику, код, многоязычные задачи и бенчмарки длинного контекста. Ее производительность оценивается по сравнению с другими крупными моделями, такими как DeepSeek-V4-Flash-Base, Hy3-preview-Base и MiMo-V2.5-Base, все они оценивались в одинаковых условиях.

Архитектура включает в себя гибридное внимание MoE с 280B-A14B и 43 слоя, включая 1 плотный FFN и 42 слоя Multi-Router Latent MoE. Она содержит 37 слоев сильно сжатого внимания (HCA) и 6 слоев многоуровневого латентного внимания с разреженным вниманием (MLA + DSA). Модель использует 512 маршрутизируемых экспертов (топ-10) плюс 1 общий эксперт на слой MoE. Ключевые инновации включают гибридное внимание MLA + HCA с размерами голов, специфичными для слоя, внимание с низким рангом и виртуальное внимание (VHA), многоуровневый латентный MoE, ECHO для предсказания будущих токенов, гиперсвязи с ограничениями многообразия (mHC) и выходной узел MultiMax. Токенизатор использует ≈200K-входной BPE токенизатор, который токенизирует числа справа налево группами до трех цифр.

Развертывание ERNIE-5.5-Flash-Base поддерживается с помощью SGLang и vLLM, что позволяет производить обслуживание с длиной контекста до 1,048,576 токенов для вывода длинного контекста. Модель предоставляется по лицензии ERNIE 5.5 Flash Base Model License Agreement v1.0, авторские права принадлежат Baidu.

  • КатегорияИИ-модели и LLM
  • Модель ценообразованияОткрытый код
  • РазвёртываниеОблако
  • ПлатформыВеб

  • 280 миллиардов параметров с 14 миллиардами активированных на токен

  • Предварительно обучена на 33,5 триллионах токенов

  • Поддерживает контекст в 1 миллион токенов для дообучения и вывода

  • Эффективная разреженная архитектура Mixture-of-Experts (MoE)

  • Гибридное внимание MLA + HCA с размерами голов, специфичными для слоя

  • Внимание с низким рангом и виртуальное внимание (VHA)

  • Многоуровневый латентный MoE с 512 маршрутизируемыми экспертами и 1 общим экспертом

  • ECHO для многогранной потери и спекулятивного декодирования

  • Гиперсвязи с ограничениями многообразия (mHC) для распространения сигнала

  • Выходной узел MultiMax для уточненного распределения словаря

  • ≈200K-входной BPE токенизатор с токенизацией чисел справа налево

  • Поддерживает развертывание с SGLang и vLLM

  • Сильная производительность по бенчмаркам знаний, рассуждений, математики, кода, многоязычных задач и длинного контекста

  • Доступны веса с точностью FP8 и BF16

  1. Доступ к модели: Перейдите на страницу ERNIE-5.5-Flash-Base на Hugging Face.

  2. Скачать модель: Выберите между точностью FP8 (safetensors) или BF16 (safetensors) для загрузки.

  3. Установить инструменты развертывания: Установите vLLM и плагин ERNIE 5.5 или используйте официальный предустановленный образ Docker SGLang.

  4. Запустить сервер: Запустите сервер vLLM или SGLang для хостинга модели.

  5. Отправить запросы: Используйте curl или другие API-клиенты для отправки запросов к конечной точке завершений для генерации текста.

  6. Дообучить модель: Используйте предварительно обученную контрольную точку для адаптации к домену, настройки инструкций или исследований в области обучения с подкреплением.

  • Генерация текста
  • Адаптация к домену
  • Настройка инструкций
  • Исследования в области обучения с подкреплением
  • Генерация и понимание кода
  • Понимание длинного контекста
  • Многоязычные приложения
  • Задачи на рассуждение

От Baidu

Модель в Baidu Wenxin Assistant.

Отзывы о ERNIE-5.5-Flash-Base

Загрузка...

Популярные ИИ-инструменты, похожие на ERNIE-5.5-Flash-Base

DeepSeek-V4-Pro — это продвинутая AI модель, разработанная для эффективного анализа контекста на миллионы токенов. Она имеет гибридную архитектуру внимания и предварительно…

ИИ-модели и LLM
Открыть инструмент

Продвинутая AI модель, разработанная для эффективного анализа контекста на миллионы токенов. Она имеет гибридную архитектуру внимания и предварительно…DeepSeek-V4-Pro — это продвинутая AI модель, разработанная для эффективного анализа контекста на миллионы токенов. Она имеет гибридную архитектуру внимания и предварительно…

РекомендованоИИ-модели и LLM
Топ-50: LLM

DeepSeek-V3 — это языковая модель Mixture-of-Experts с 671 миллиардом параметров, разработанная для эффективного вывода и экономичного обучения. Она демонстрирует отличные…

ИИ-модели и LLM

№37 в LLM

Открыть инструмент

Языковая модель Mixture-of-Experts с 671 миллиардом параметров, разработанная для эффективного вывода и экономичного обучения. Она демонстрирует отличные…DeepSeek-V3 — это языковая модель Mixture-of-Experts с 671 миллиардом параметров, разработанная для эффективного вывода и экономичного обучения. Она демонстрирует отличные…

РекомендованоИИ-модели и LLM
№37 в LLM

AliceAI-Foundation-80B-A3B-Base — это базовая языковая модель с гибридной архитектурой и слоями MoE, содержащая 80 миллиардов параметров. Она превосходно справляется с задачами…

ИИ-модели и LLM

№28 в LLM

Открыть инструмент

Базовая языковая модель с гибридной архитектурой и слоями MoE, содержащая 80 миллиардов параметров. Она превосходно справляется с задачами…AliceAI-Foundation-80B-A3B-Base — это базовая языковая модель с гибридной архитектурой и слоями MoE, содержащая 80 миллиардов параметров. Она превосходно справляется с задачами…

ИИ-модели и LLM
№28 в LLM

Ling-3.0-flash — это модель гибридного рассуждения следующего поколения, разработанная для эффективности и производительности. С 124 миллиардами параметров она превосходно…

ИИ-модели и LLM
Открыть инструмент

Модель гибридного рассуждения следующего поколения, разработанная для эффективности и производительности. С 124 миллиардами параметров она превосходно…Ling-3.0-flash — это модель гибридного рассуждения следующего поколения, разработанная для эффективности и производительности. С 124 миллиардами параметров она превосходно…

ИИ-модели и LLM
Топ-50: LLM

Kimi-K2-Instruct — это современная языковая модель с использованием смеси экспертов, предназначенная для сложных задач ИИ. Она превосходно справляется с рассуждениями,…

ИИ-модели и LLM

№46 в LLM

Открыть инструмент

Kimi-K2-Instruct — это современная языковая модель с использованием смеси экспертов, предназначенная для сложных задач ИИ. Она превосходно справляется с рассуждениями,…

ИИ-модели и LLM
№46 в LLM

MiniMax-M3.1-Flash — это многомодальная модель смешанных экспертов, разработанная для кодирования, агентных рабочих процессов и кибербезопасности. Она поддерживает текстовые,…

ИИ-модели и LLM
Открыть инструмент

Многомодальная модель смешанных экспертов, разработанная для кодирования, агентных рабочих процессов и кибербезопасности. Она поддерживает текстовые,…MiniMax-M3.1-Flash — это многомодальная модель смешанных экспертов, разработанная для кодирования, агентных рабочих процессов и кибербезопасности. Она поддерживает текстовые,…

ИИ-модели и LLM
Топ-50: LLM

DeepSeek-V4-Pro-DSpark — это продвинутая языковая модель с гибридной архитектурой внимания и многообразно ограниченными гиперсвязями. Она поддерживает длину контекста в один…

ИИ-модели и LLM
Открыть инструмент

Продвинутая языковая модель с гибридной архитектурой внимания и многообразно ограниченными гиперсвязями. Она поддерживает длину контекста в один…DeepSeek-V4-Pro-DSpark — это продвинутая языковая модель с гибридной архитектурой внимания и многообразно ограниченными гиперсвязями. Она поддерживает длину контекста в один…

ИИ-модели и LLM
Топ-50: LLM

Solar Open 2 — это большая языковая модель от Upstage, предназначенная для агентных случаев использования, таких как офисная продуктивность и программирование. Она имеет…

ИИ-модели и LLM

№19 в LLM

Открыть инструмент

Большая языковая модель от Upstage, предназначенная для агентных случаев использования, таких как офисная продуктивность и программирование. Она имеет…Solar Open 2 — это большая языковая модель от Upstage, предназначенная для агентных случаев использования, таких как офисная продуктивность и программирование. Она имеет…

ИИ-модели и LLM
№19 в LLM
1 из 8