Descrição
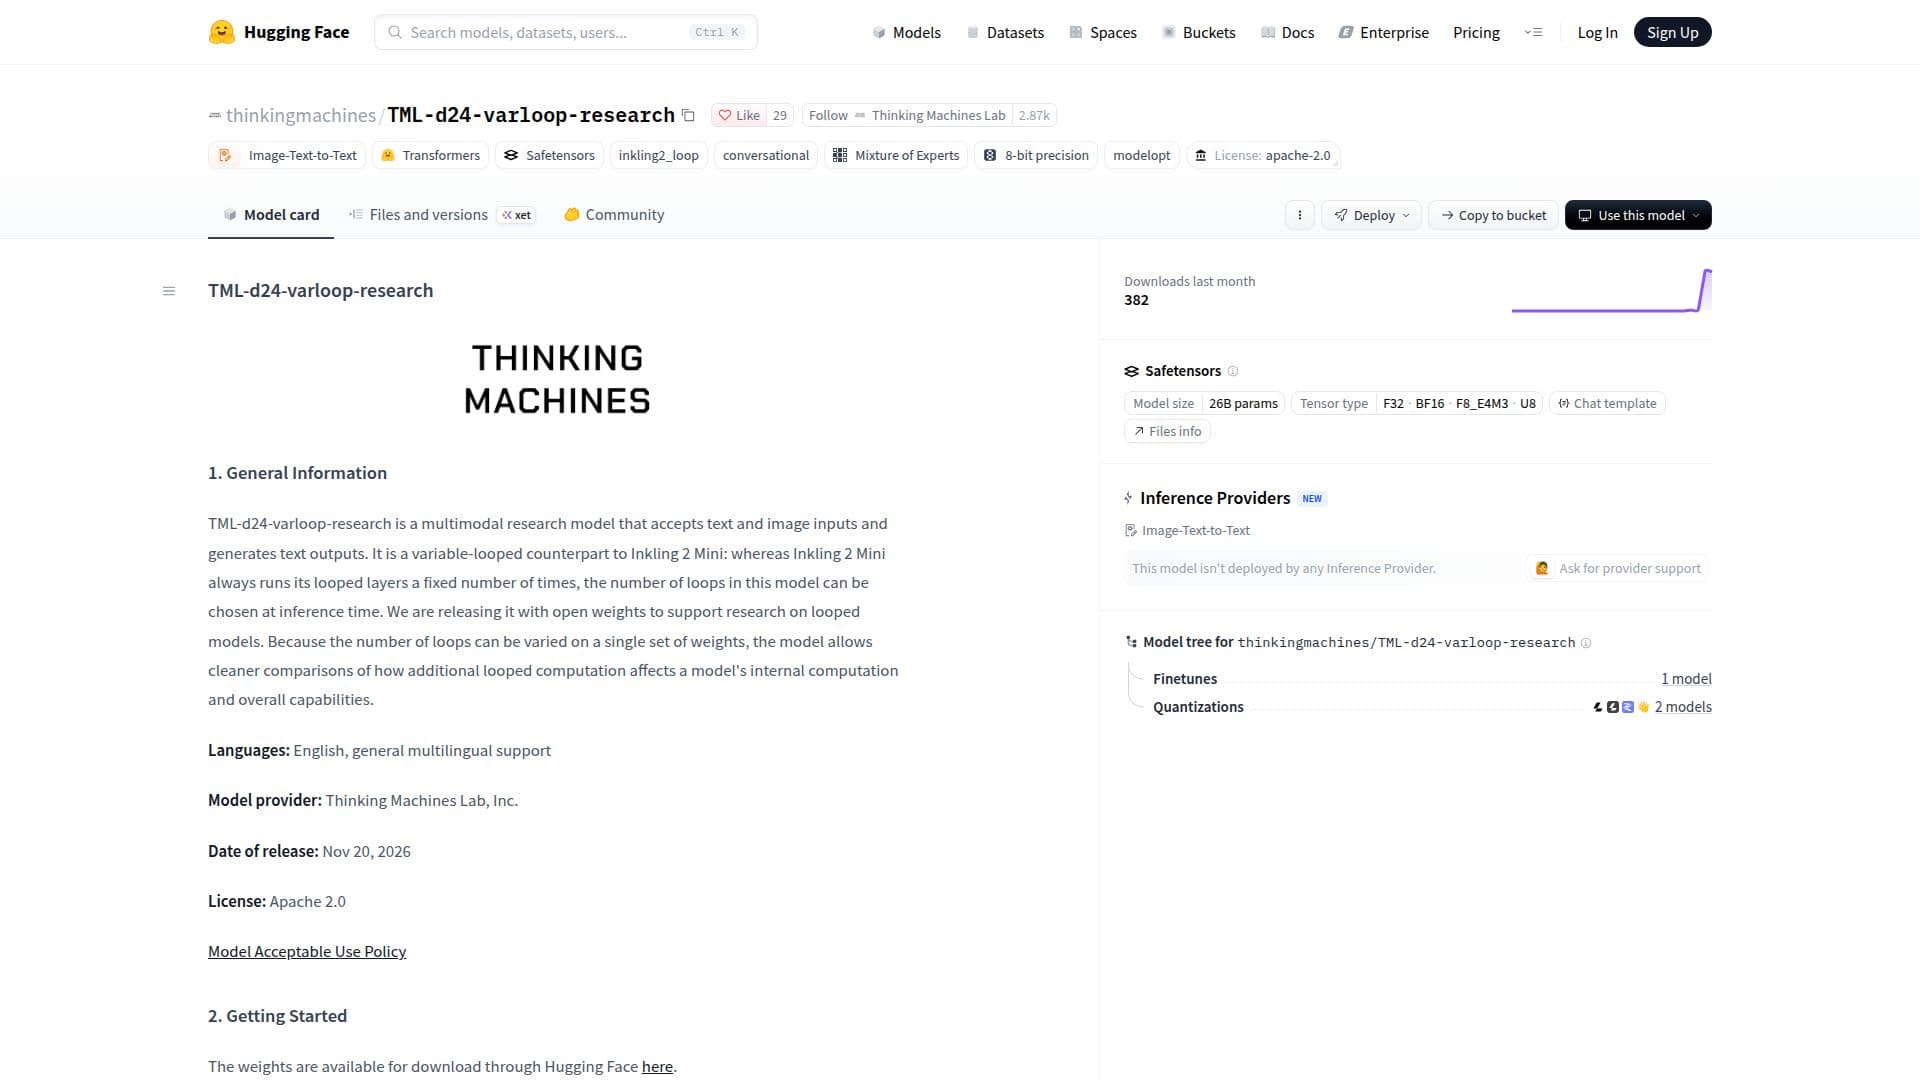
TML-d24-varloop-research é um modelo de pesquisa multimodal desenvolvido pela Thinking Machines Lab, Inc., projetado para processar entradas de texto e imagem e produzir saídas de texto. Lançado em 20 de novembro de 2026, sob uma licença Apache 2.0, este modelo é uma contribuição significativa para o campo dos modelos em loop, oferecendo uma arquitetura de laços variáveis, ao contrário de sua contraparte de laço fixo, Inkling 2 Mini. Os pesquisadores podem ajustar dinamicamente o número de laços durante a inferência, permitindo comparações mais limpas de como a computação adicional impacta os processos internos de um modelo e suas capacidades gerais.
Ler mais
O modelo é distribuído como pesos abertos através do Hugging Face, com um tamanho de ponto de verificação único de aproximadamente 20GB. Ele requer uma máquina com pelo menos 32GB de memória GPU ou unificada, compatível com configurações como NVIDIA DGX Spark, GPUs NVIDIA (por exemplo, GeForce RTX 5090 ou RTX PRO 6000 Blackwell) ou Macs com silício da Apple. TML-d24-varloop-research suporta inferência local usando várias estruturas, incluindo Hugging Face, SGLang, vLLM, TokenSpeed, NVIDIA Dynamo, Unsloth, llama.cpp, Llama App, Ollama e Exo Labs. Também suporta pós-treinamento com Miles e SkyRL.
Arquitetonicamente, TML-d24-varloop-research é um transformador decodificador de 24 camadas apenas, com camadas de avanço esparsas Mixture-of-Experts (MoE). As 12 camadas do meio podem ser executadas um número variável de vezes, compartilhando pesos, e foram treinadas com 1 a 5 passagens. Cada camada roteia tokens para 8 dos 128 especialistas, e a atenção é um híbrido de camadas locais e globais. O modelo é nativamente multimodal, codificando imagens via um transformador de visão e processando-as conjuntamente com texto em um espaço oculto compartilhado. Ele possui 26,4 bilhões de parâmetros (3,4 bilhões ativos em 1 passagem) e suporta numéricos NVFP4 e MXFP8. Ele lida com texto codificado em UTF-8 e entradas de imagem baseadas em pixels (40px a 4096px por dimensão) com uma janela de contexto de até 1 milhão de tokens.
Os dados de treinamento para TML-d24-varloop-research incluem uma ampla variedade de tipos de conteúdo de fontes publicamente disponíveis, aquisições de terceiros e dados gerados internamente/sinteticamente. A curadoria de dados envolveu limpeza, deduplicação e filtragem para garantir qualidade e segurança. O modelo compartilha seu pré-treinamento e a primeira fase de meio treinamento com Inkling 2 Mini, mas diverge em estágios posteriores, particularmente em seu treinamento de looping variável, onde 1 a 5 passagens foram amostradas. Embora as avaliações mostrem desempenho variável em comparação com Inkling 2 Mini em benchmarks como Codificação Agentic, Interpretação de Visão e Raciocínio, ele é principalmente destinado como um artefato de pesquisa e não é recomendado para uso em produção devido ao comportamento potencialmente imprevisível em diferentes contagens de passagens e limitações gerais comuns a modelos de fundação, como alucinação e preconceitos dos dados de treinamento.
- CategoriaModelos de IA e LLMs
- Modelo de preçosCódigo aberto
- ImplantaçãoRoda localmente
- PlataformasWeb
Destaques de TML-d24-varloop-research
Entrada Multimodal: Aceita entradas de texto e imagem
Saída de Texto: Gera texto com base nas entradas
Loop Variável: Número de camadas em loop pode ser escolhido no momento da inferência
Pesos Abertos: Disponíveis para download para apoiar a pesquisa
26,4 Bilhões de Parâmetros: Modelo em grande escala com 3,4B de parâmetros ativos em 1 passagem
Suporte Multilíngue: Suporte geral para múltiplas línguas
Licença Apache 2.0: Licenciamento de código aberto para uso e modificação
Suporte à Inferência Local: Compatível com Hugging Face, SGLang, vLLM, TokenSpeed, NVIDIA Dynamo, Unsloth, llama.cpp, Llama App, Ollama, Exo Labs
Suporte a Pós-treinamento: Pode ser pós-treinado com Miles e SkyRL
Mistura Esparsa de Especialistas (MoE): Utiliza camadas de avanço MoE
Atenção Híbrida: Combina camadas de atenção locais e globais
Multimodalidade Nativa: Imagens codificadas via transformador de visão e processadas conjuntamente com texto
Janela de Contexto Alta: Suporta até 1 milhão de tokens
Numéricos de Precisão Mista: Suporta NVFP4 e MXFP8
Primeiros passos com TML-d24-varloop-research
Baixar Pesos: Acesse os pesos do modelo através do Hugging Face.
Preparar Hardware: Certifique-se de que uma única máquina com pelo menos 32GB de memória GPU ou unificada esteja disponível.
Instalar Software: Configure as estruturas de inferência necessárias, como Hugging Face, SGLang ou vLLM, juntamente com suas dependências.
Configurar Modelo: Carregue o ponto de verificação de 20GB em sua estrutura escolhida.
Definir Passagens de Loop: Escolha o número desejado de camadas em loop para a inferência.
Fornecer Entradas: Alimente texto codificado em UTF-8 e imagens baseadas em pixels (dimensões de 40px a 4096px) ao modelo.
Gerar Saída: Receba saídas de texto do modelo com base nas entradas fornecidas.
Casos de uso de TML-d24-varloop-research
- Pesquisa Multimodal
- Estudos de Modelos em Loop
- Geração de Texto a partir de Imagens
- Processamento de Texto Multilíngue
- Desenvolvimento de Modelos com Pesos Abertos
- Implantação de Inferência Local
- Ajuste Fino do Modelo