Descrição
SenseNova-Loop-9B-Preview é um modelo de linguagem multimodal avançado projetado para lidar com cenários complexos de longo contexto e fluxos de trabalho agentes. Desenvolvido pela SenseNova, este modelo é capaz de aceitar entradas de texto e imagem, gerando posteriormente saídas de texto. Suas principais aplicações abrangem áreas como compreensão abrangente de documentos, tarefas de codificação sofisticadas e interação fluida com várias ferramentas externas.
Ler mais
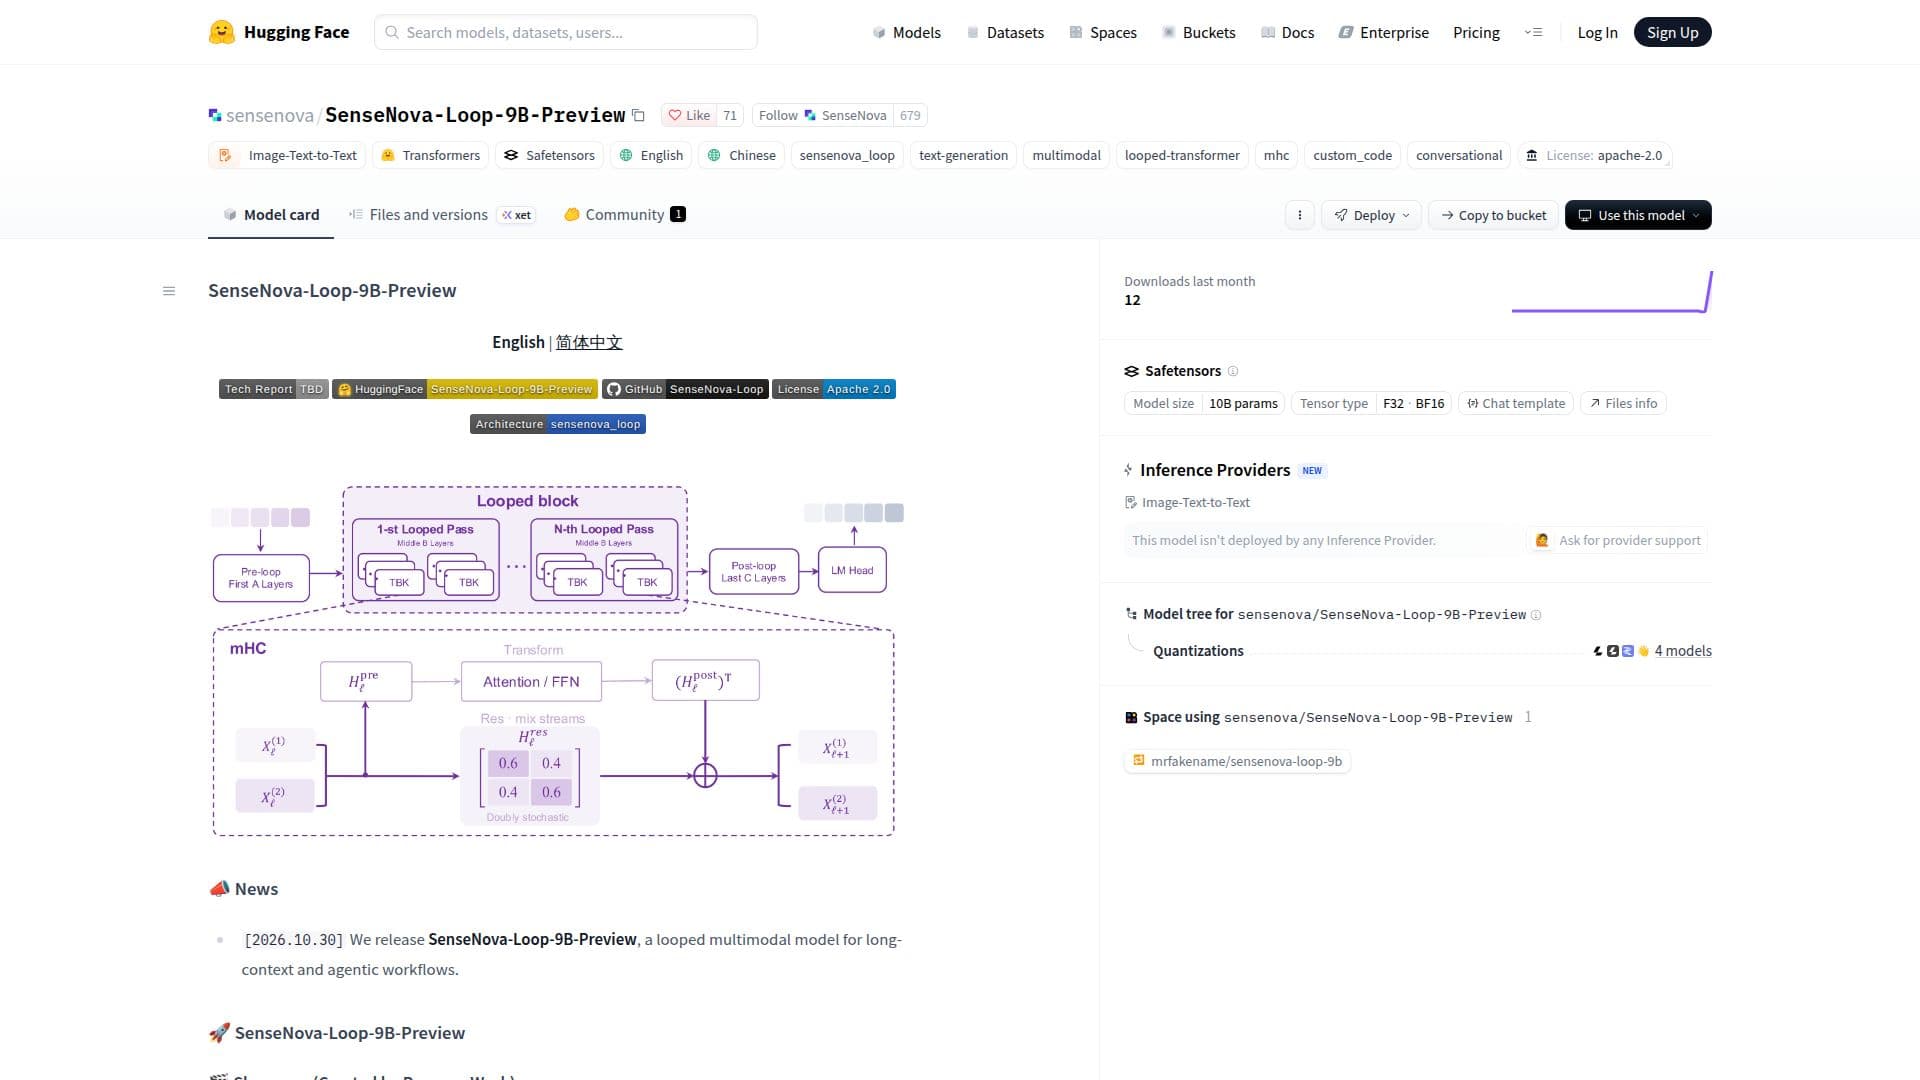
O núcleo da arquitetura do SenseNova-Loop-9B-Preview reside em sua combinação inovadora de um decodificador em loop e hiperconexões manifold-constrained de dois fluxos (mHC). Este design permite que um bloco contíguo de camadas de decodificador seja executado duas vezes usando pesos compartilhados, aprofundando significativamente o caminho de execução sem duplicar parâmetros. Mapeamentos aprendidos dentro do sistema mHC gerenciam eficientemente o fluxo de informações entre dois fluxos residuais na seção em loop, aprimorando a capacidade do modelo de processar e sintetizar informações.
As receitas de treinamento para o modelo incorporam sequências longas, entradas multimodais diversas e trajetórias de tarefas supervisionadas, com um comprimento máximo de sequência de treinamento atingindo 262.144 tokens. Este extenso treinamento permite um desempenho robusto em uma ampla gama de tarefas complexas. Para operação ideal, os usuários são aconselhados a utilizar o ambiente de implantação documentado e os parâmetros de configuração.
Os principais destaques arquitetônicos incluem um bloco em loop compartilhado onde 24 camadas de decodificador são aplicadas duas vezes, resultando em 56 execuções de camadas de decodificador a partir de apenas 32 camadas distintas. O mHC de dois fluxos facilita o roteamento inteligente e a combinação de informações entre os fluxos residuais. Além disso, o decodificador emprega um mecanismo de atenção híbrido, intercalando camadas de atenção linear e total em um padrão repetido de quatro camadas, que é preservado ao longo das passagens do loop. O modelo também suporta MTP para inferência acelerada, com Dspark e Dflash2 atualmente em desenvolvimento para aprimorar ainda mais a velocidade.
- CategoriaModelos de IA e LLMs
- Modelo de preçosCódigo aberto
- ImplantaçãoNuvem
- PlataformasWeb
Destaques de SenseNova-Loop-9B-Preview
Entrada Multimodal: Aceita tanto texto quanto imagens
Geração de Texto: Produz saídas de texto
Arquitetura de Decodificador em Loop: Executa camadas de decodificador duas vezes com pesos compartilhados
Hiperconexões Manifold-Constrained de Dois Fluxos (mHC): Gerencia o fluxo de informações entre fluxos residuais
Processamento de Longo Contexto: Suporta comprimentos de sequência de treinamento de até 262.144 tokens
Suporte a Fluxos de Trabalho Agentes: Projetado para interação com ferramentas externas
Atenção Híbrida: Intercala camadas de atenção linear e total
Eficiência de Parâmetros: Alcança 56 execuções de camadas de decodificador a partir de 32 camadas distintas
Compreensão de Documentos: Capaz de processar documentos complexos
Aplicações de Codificação: Suporta tarefas relacionadas a código
Aceleração de Inferência MTP: Disponível para processamento mais rápido
Suporte a Fine-tuning: Fornece receitas de treinamento documentadas para personalização
Licença Apache 2.0: Licenciamento de código aberto para uso e modificação
Integração com Hugging Face: Disponível para download e implantação no Hugging Face
Primeiros passos com SenseNova-Loop-9B-Preview
Acessar a Página do Modelo: Navegue até a página do SenseNova-Loop-9B-Preview no Hugging Face.
Instalar Dependências: Instale o PyTorch compatível com seu ambiente CUDA, depois instale o Transformers 5.18.0 e o PyTorch 2.11.0.
Carregar o Modelo: Use a biblioteca Transformers para carregar o modelo e sua implementação personalizada do repositório Hugging Face ou de um diretório local.
Configurar Inferência: Defina `model_id` para o ID do repositório ou caminho local e configure parâmetros como `enable_thinking` e `device`.
Gerar Texto: Execute o exemplo em Python fornecido para realizar a geração de texto, especificando o número de novos tokens.
Ajustar o Modelo: Use os comandos de treinamento documentados com seu conjunto de dados SFT em um único nó com 8 GPUs para fine-tuning.
Implantar o Modelo: Utilize opções de implantação como LightLLM ou SGLang substituindo o caminho do modelo local nos exemplos fornecidos.
Casos de uso de SenseNova-Loop-9B-Preview
- Compreensão de Documentos de Longo Contexto
- Automação de Fluxo de Trabalho Agente
- Geração de Conteúdo Multimodal
- Assistência Avançada em Codificação
- Automação de Design de PPT
- Geração de Texto para Design de Movimento
- Relatórios de Análise de Dados
- Pesquisa e Desenvolvimento Multimodal