Descrição
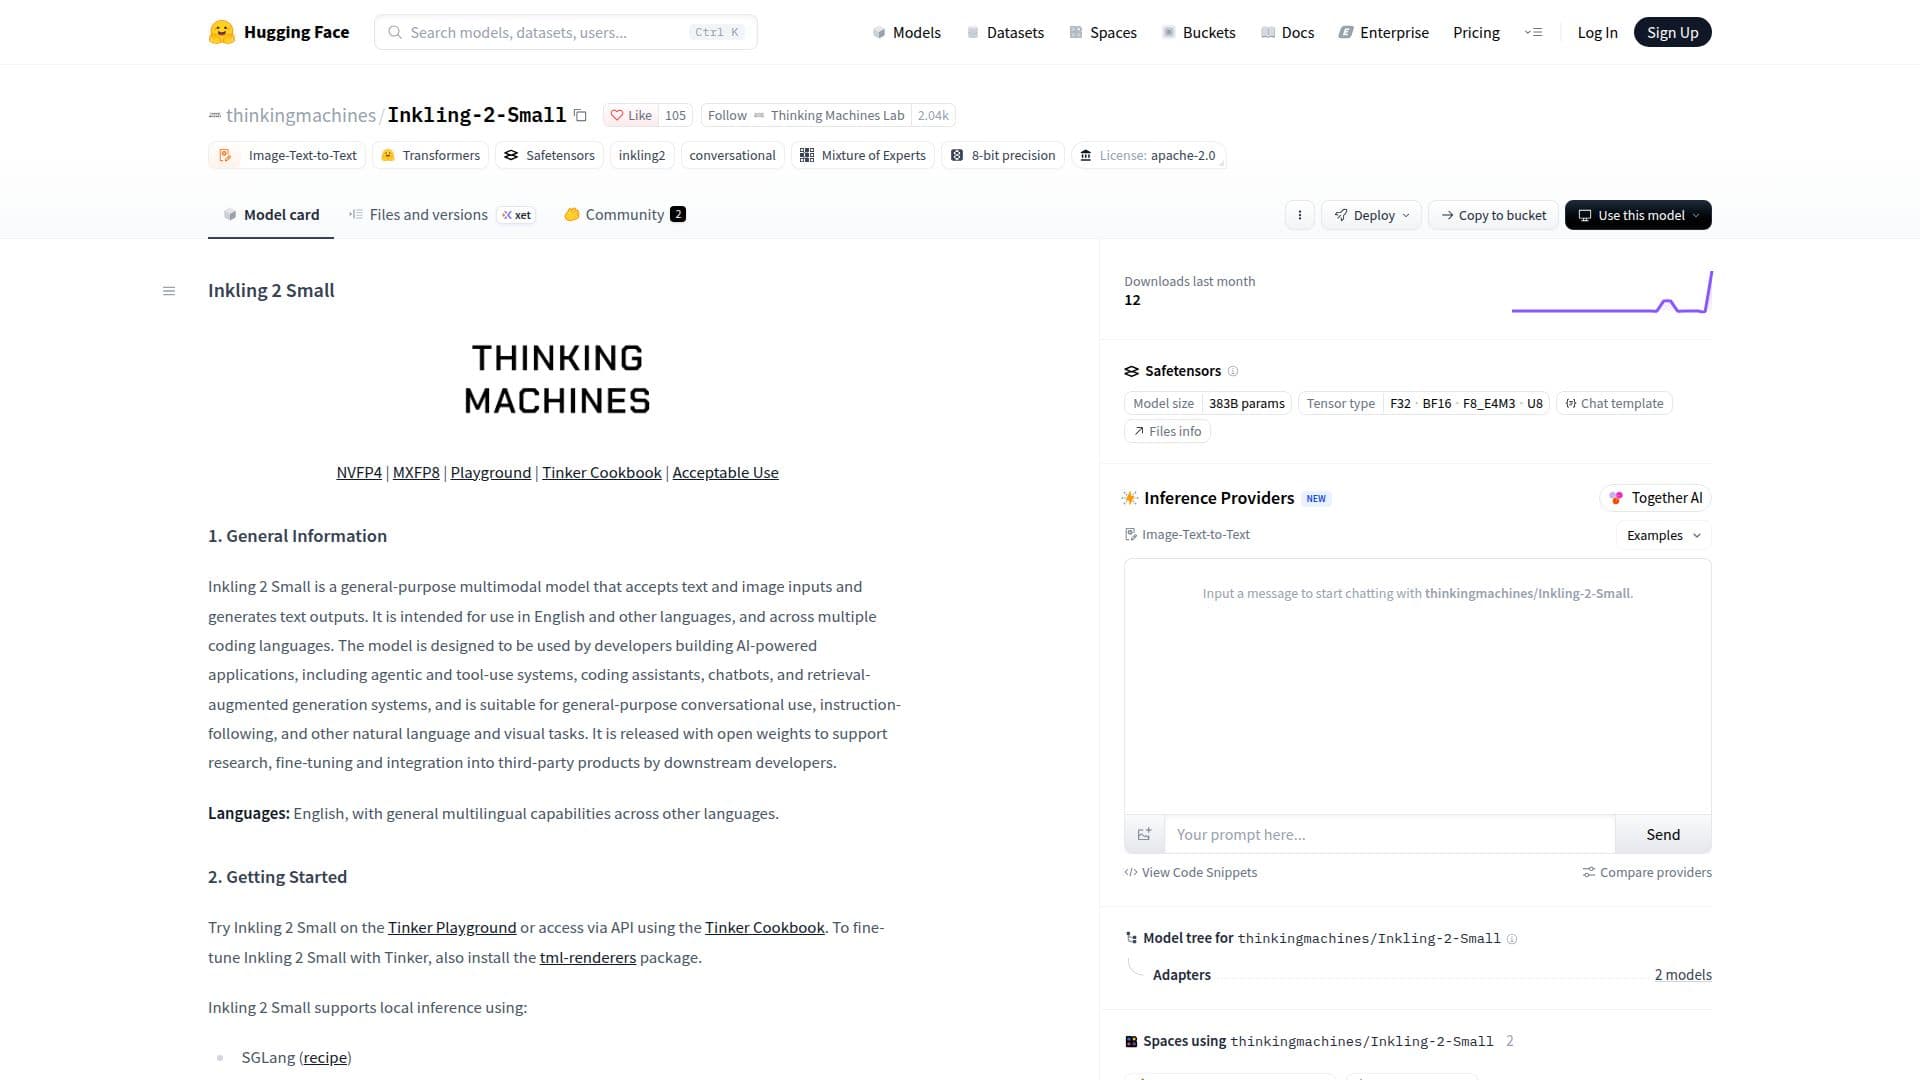
Inkling 2 Small é um modelo multimodal versátil capaz de processar entradas de texto e imagem para produzir saídas de texto. Ele é projetado para ampla aplicabilidade, suportando inglês e outros idiomas, além de várias linguagens de programação. O modelo é especificamente direcionado a desenvolvedores que estão criando aplicações impulsionadas por IA, como sistemas agentes e de uso de ferramentas, assistentes de codificação, chatbots e sistemas de geração aumentada por recuperação (RAG). Seu design também o torna adequado para interações conversacionais de uso geral, seguimento de instruções e uma ampla gama de tarefas de linguagem natural e visuais.
Ler mais
Lançado com pesos abertos, Inkling 2 Small incentiva pesquisa, ajuste fino e integração em produtos de terceiros por desenvolvedores downstream. Os usuários podem experimentar o modelo no Tinker Playground ou acessá-lo via API usando o Tinker Cookbook. Para ajuste fino com Tinker, é necessário o pacote tml-renderers. O modelo suporta inferência local através de várias estruturas, incluindo SGLang, vLLM, TokenSpeed e Unsloth. Além disso, pode ser pós-treinado com Miles, SkyRL e Snowflake Cortex Training. O acesso à API também está disponível através de provedores de inferência de terceiros como NVIDIA, Fireworks, Together, Baseten, Nebius, Modal e Cloudflare.
Os requisitos de hardware para Inkling 2 Small dependem do formato do checkpoint. O checkpoint principal NVFP4 necessita de um cluster de GPU com pelo menos 500GB de VRAM agregada, alcançável com configurações como 2x GPUs NVIDIA B300 ou 4x GPUs NVIDIA H200. O checkpoint alternativo MXFP8 requer pelo menos 800GB de VRAM agregada, atendido por 4x GPUs NVIDIA B300 ou 8x GPUs NVIDIA H200. O checkpoint NVFP4 é recomendado para todos os casos de uso, pois é a precisão nativa do modelo, oferecendo desempenho ideal.
Arquitetonicamente, Inkling 2 Small é um transformador autoregressivo multimodal. Ele apresenta um transformador decodificador de 48 camadas com uma espinha dorsal de feed-forward Mixture-of-Experts (MoE) esparsa, onde cada token é direcionado a 8 dos 384 especialistas. Seu mecanismo de atenção combina camadas locais e globais. O modelo é nativamente multimodal, codificando imagens via um transformador de visão e projetando tanto entradas de imagem quanto de texto em um espaço oculto compartilhado para processamento conjunto pelo decodificador. Ele suporta uma janela de contexto de até 1 milhão de tokens e aceita texto em codificação UTF-8 e formatos de imagem baseados em pixels (idealmente entre 40px e 4096px por dimensão). As saídas são geradas como texto codificado em UTF-8.
Os dados de treinamento para Inkling 2 Small incluem uma ampla gama de tipos de conteúdo, como texto, imagens e vídeo, provenientes de repositórios publicamente disponíveis, terceiros, geração interna e aumento sintético. O processo de curadoria de dados envolve limpeza, processamento e modificação de conjuntos de dados, incluindo deduplicação e filtragem por qualidade e segurança. Avaliações de segurança foram realizadas em interações cotidianas entre humanos e IA e testes de capacidades perigosas, com mitigação aplicada para reduzir riscos. O conhecimento do modelo é limitado ao seu corte de treinamento, e os usuários são aconselhados a aplicar supervisão humana para aplicações de alto risco devido a limitações potenciais, como alucinações e preconceitos dos dados de treinamento.
- CategoriaModelos de IA e LLMs
- Modelo de preçosCódigo aberto
- ImplantaçãoNuvem, Auto-hospedado
- PlataformasWeb
Destaques de Inkling 2 Small
Entrada Multimodal: Aceita entradas de texto e imagem
Saída de Texto: Gera saídas de texto codificadas em UTF-8
Modelo de Uso Geral: Adequado para uma ampla gama de aplicações
Capacidades Multilíngues: Suporta inglês e outros idiomas
Suporte a Múltiplas Linguagens de Programação: Funciona em várias linguagens de programação
Pesos Abertos: Disponíveis para pesquisa, ajuste fino e integração
Acesso à API: Acessível via Tinker Cookbook e provedores de terceiros
Suporte à Inferência Local: Compatível com SGLang, vLLM, TokenSpeed, Unsloth
Opções de Pós-Treinamento: Pode ser pós-treinado com Miles, SkyRL, Snowflake Cortex Training
Transformador Autoregressivo: Utiliza uma arquitetura de decodificador de 48 camadas
Mixture-of-Experts (MoE): Espinha dorsal de feed-forward esparsa com 384 especialistas
Espaço Oculto Compartilhado: Processa entradas de imagem e texto em conjunto
Janela de Contexto: Suporta até 1 milhão de tokens
Alto Número de Parâmetros: 594B de parâmetros totais, 17B ativos
Primeiros passos com Inkling 2 Small
Acessar Modelo: Visite a página do Inkling 2 Small no Hugging Face.
Experimentar Playground: Experimente o modelo diretamente no Tinker Playground.
Acessar via API: Use o Tinker Cookbook para integrar o modelo através de sua API.
Ajustar Modelo: Instale o pacote tml-renderers para ajustar o Inkling 2 Small com Tinker.
Inferência Local: Utilize estruturas como SGLang, vLLM, TokenSpeed ou Unsloth para implantação local.
Pós-Treinamento: Aprimore o modelo com Miles, SkyRL ou Snowflake Cortex Training.
Implantar com Provedores: Acesse a API através de provedores de inferência de terceiros, como NVIDIA ou Fireworks.
Configurar Hardware: Assegure um cluster de GPU com pelo menos 500GB de VRAM para NVFP4 ou 800GB para o checkpoint MXFP8.
Casos de uso de Inkling 2 Small
- Construção de Aplicações de IA
- Desenvolvimento de Sistemas Agentes
- Assistentes de Codificação
- Criação de Chatbots
- Geração Aumentada por Recuperação
- Uso Conversacional Geral
- Seguimento de Instruções
- Tarefas Visuais
- Pesquisa e Experimentação
- Integração de Produtos de Terceiros