Pular para o conteúdo principal
ToolPotion
Consultor de IA
Enviar

ERNIE-5.5-Flash-Base-BF16

ERNIE-5.5-Flash-Base-BF16 é um modelo de linguagem eficiente e esparso Mixture-of-Experts (MoE) com 280 bilhões de parâmetros totais. Pré-treinado em 33,5 trilhões de tokens, suporta fine-tuning e inferência com um contexto de 1 milhão de tokens. Este modelo é projetado para várias aplicações, incluindo adaptação de domínio, ajuste de instruções e pesquisa em aprendizado por reforço, oferecendo um desempenho robusto em múltiplos benchmarks.

Visitar URL
Compartilhar
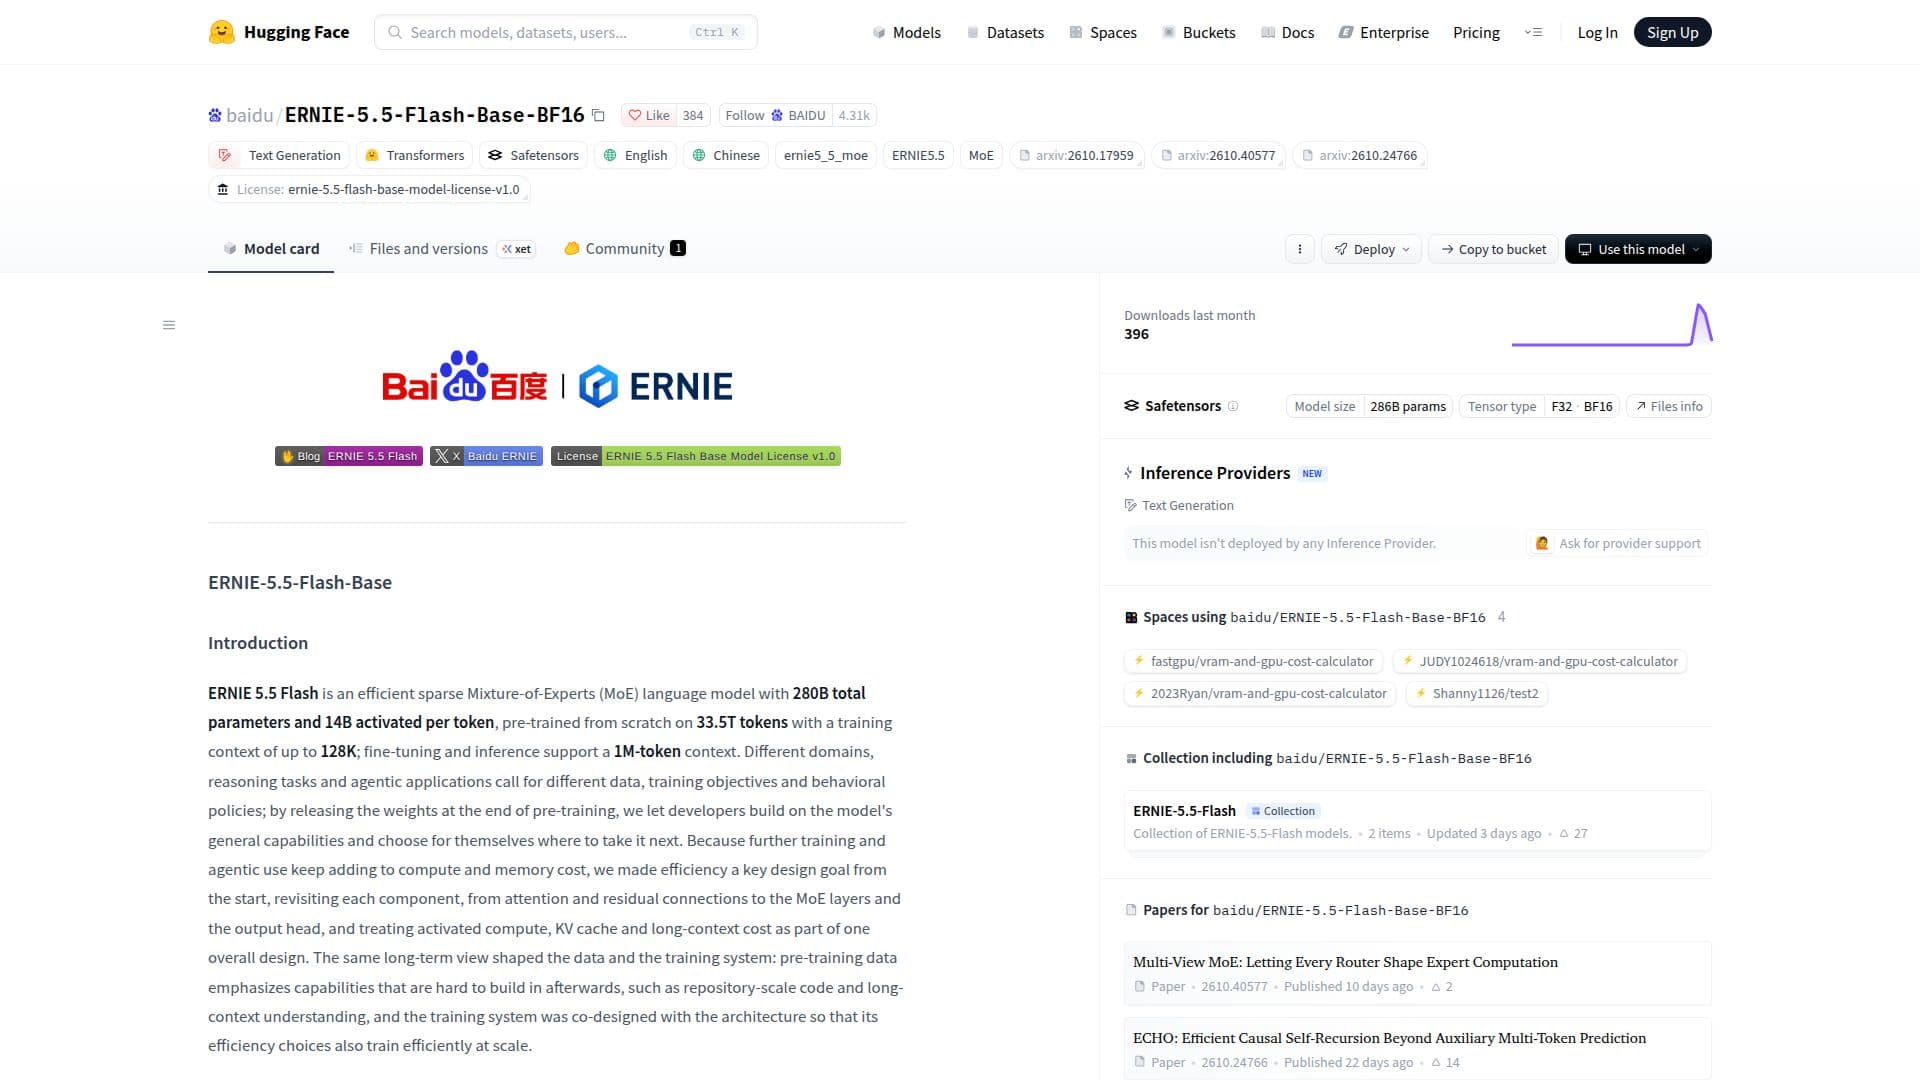
Captura de tela do ERNIE-5.5-Flash-Base-BF16

ERNIE-5.5-Flash-Base-BF16 é um sofisticado modelo de linguagem esparso Mixture-of-Experts (MoE) desenvolvido pela Baidu. Ele possui um total substancial de 280 bilhões de parâmetros, com 14 bilhões ativados por token, tornando-o altamente eficiente para tarefas complexas de linguagem. O modelo foi pré-treinado do zero em um extenso conjunto de dados de 33,5 trilhões de tokens, utilizando um contexto de treinamento de até 128.000 tokens. Para fine-tuning e inferência, suporta um impressionante comprimento de contexto de 1 milhão de tokens, permitindo uma compreensão profunda e geração de conteúdo longo.

Ler mais

Projetado com a eficiência como princípio central, ERNIE 5.5 Flash revisita cada componente, desde mecanismos de atenção e conexões residuais até camadas MoE e a cabeça de saída. Esta abordagem holística garante desempenho ideal enquanto gerencia custos de computação, cache KV e long-context. Os dados de pré-treinamento enfatizam capacidades cruciais para aplicações avançadas, como compreensão de código em escala de repositório e compreensão de long-context, permitindo que desenvolvedores construam sobre suas capacidades gerais para diversos casos de uso.

ERNIE-5.5-Flash-Base-BF16 representa o ponto de verificação no final do pré-treinamento, servindo como um modelo fundamental antes de quaisquer estágios de treinamento intermediário ou posterior. Isso o torna um ponto de partida ideal para pesquisadores e desenvolvedores envolvidos em adaptação de domínio, ajuste de instruções e aprendizado por reforço. O modelo demonstrou resultados fortes em um pipeline de avaliação unificado, destacando-se em benchmarks relacionados a conhecimento, raciocínio, matemática, código, tarefas multilíngues e compreensão de long-context.

A arquitetura incorpora um MoE híbrido de atenção 280B-A14B com 43 camadas, incluindo 1 FFN densa e 42 camadas MoE Latente Multi-Router. Ele apresenta 37 camadas de Atenção Comprimida Pesada (HCA) e 6 camadas de Atenção Latente Multi-head (MLA + DSA) com atenção esparsa. O modelo utiliza 512 especialistas roteados (top-10) mais 1 especialista compartilhado por camada MoE. Inovações como Atenção Gated de Baixa Classificação, Atenção de Cabeça Virtual (VHA), MoE Latente Multi-Router, ECHO, Conexões Hiper-Manifold Constrangidas (mHC) e Cabeça de Saída MultiMax contribuem para suas capacidades avançadas e eficiência. O tokenizer suporta aproximadamente 200.000 entradas e tokeniza números da direita para a esquerda em grupos de até três dígitos.

A implantação é suportada com SGLang e vLLM, permitindo o serviço em produção com comprimentos de contexto de até 1.048.576 tokens. O modelo está disponível sob o Acordo de Licença do Modelo ERNIE 5.5 Flash Base v1.0.

  • CategoriaModelos de IA e LLMs
  • ImplantaçãoNuvem
  • PlataformasWeb

  • 280 bilhões de parâmetros totais

  • 14 bilhões de parâmetros ativados por token

  • Pré-treinado em 33,5 trilhões de tokens

  • Contexto de treinamento de até 128.000 tokens

  • Fine-tuning e inferência suportam contexto de 1 milhão de tokens

  • Arquitetura esparsa Mixture-of-Experts (MoE) eficiente

  • MoE de atenção híbrida com 43 camadas

  • 37 camadas de Atenção Comprimida Pesada (HCA)

  • 6 camadas de Atenção Latente Multi-head (MLA + DSA)

  • 512 especialistas roteados (top-10) mais 1 especialista compartilhado por camada MoE

  • Atenção Gated de Baixa Classificação e Atenção de Cabeça Virtual (VHA)

  • MoE Latente Multi-Router para seleção precisa de especialistas

  • ECHO para perda multi-horizonte e decodificação especulativa

  • Conexões Hiper-Manifold Constrangidas (mHC) para propagação de sinal

  • Cabeça de Saída MultiMax para distribuição de vocabulário aprimorada

  • Tokenizer BPE de aproximadamente 200.000 entradas

  • Suporte para SGLang e vLLM para serviço em produção

  1. Acesse a Página do Modelo: Navegue até a página do ERNIE-5.5-Flash-Base-BF16 no Hugging Face.

  2. Explore os Arquivos: Revise os arquivos do modelo e a documentação disponível na página.

  3. Baixe o Modelo: Baixe o ponto de verificação do modelo ERNIE-5.5-Flash-Base-BF16.

  4. Instale o vLLM e o Plugin: Instale o vLLM e o plugin ERNIE 5.5 para implantação.

  5. Inicie o Servidor: Use SGLang ou vLLM para iniciar o servidor do modelo.

  6. Envie Solicitações: Envie solicitações para o endpoint de completions usando ferramentas como curl para inferência.

  • Geração de Texto
  • Adaptação de Domínio
  • Ajuste de Instruções
  • Pesquisa em Aprendizado por Reforço
  • Compreensão de Código
  • Compreensão de Long-Context
  • Aplicações Multilíngues
  • Tarefas de Raciocínio
  • Aplicações Agentes

De Baidu

Um modelo de Baidu Wenxin Assistant.

Avaliações de ERNIE-5.5-Flash-Base-BF16

Carregando...

Ferramentas de IA populares como ERNIE-5.5-Flash-Base-BF16

ERNIE-5.5-Flash-Base é um modelo de linguagem eficiente e esparso Mixture-of-Experts (MoE) com 280 bilhões de parâmetros totais, projetado para geração de texto. Pré-treinado em…

Modelos de IA e LLMs
Ver ferramenta

Modelo de linguagem eficiente e esparso Mixture-of-Experts (MoE) com 280 bilhões de parâmetros totais, projetado para geração de texto. Pré-treinado em…ERNIE-5.5-Flash-Base é um modelo de linguagem eficiente e esparso Mixture-of-Experts (MoE) com 280 bilhões de parâmetros totais, projetado para geração de texto. Pré-treinado em…

Modelos de IA e LLMs
Ver o Top 100 de LLMs

DeepSeek-V4-Pro é um modelo de IA avançado projetado para inteligência de contexto eficiente com milhões de tokens. Ele apresenta uma arquitetura de atenção híbrida e é…

Modelos de IA e LLMs
Ver ferramenta

Modelo de IA avançado projetado para inteligência de contexto eficiente com milhões de tokens. Ele apresenta uma arquitetura de atenção híbrida e é…DeepSeek-V4-Pro é um modelo de IA avançado projetado para inteligência de contexto eficiente com milhões de tokens. Ele apresenta uma arquitetura de atenção híbrida e é…

DestaqueModelos de IA e LLMs
Ver o Top 100 de LLMs

DeepSeek-V3 é um modelo de linguagem Mixture-of-Experts com 671 bilhões de parâmetros, projetado para inferência eficiente e treinamento econômico. Ele se destaca em vários…

Modelos de IA e LLMs

Nº 42 em LLMs

Ver ferramenta

Modelo de linguagem Mixture-of-Experts com 671 bilhões de parâmetros, projetado para inferência eficiente e treinamento econômico. Ele se destaca em vários…DeepSeek-V3 é um modelo de linguagem Mixture-of-Experts com 671 bilhões de parâmetros, projetado para inferência eficiente e treinamento econômico. Ele se destaca em vários…

DestaqueModelos de IA e LLMs
Nº 42 em LLMs

DeepSeek-V4-Pro-DSpark é um modelo de linguagem avançado com uma arquitetura de atenção híbrida e hiper-conexões com restrição de variedade. Ele suporta um comprimento de contexto…

Modelos de IA e LLMs

Nº 71 em LLMs

Ver ferramenta

Modelo de linguagem avançado com uma arquitetura de atenção híbrida e hiper-conexões com restrição de variedade. Ele suporta um comprimento de contexto…DeepSeek-V4-Pro-DSpark é um modelo de linguagem avançado com uma arquitetura de atenção híbrida e hiper-conexões com restrição de variedade. Ele suporta um comprimento de contexto…

Modelos de IA e LLMs
Nº 71 em LLMs

AliceAI-Foundation-80B-A3B-Base é um modelo de linguagem fundamental com uma arquitetura híbrida e camadas MoE, apresentando 80 bilhões de parâmetros. Ele se destaca em tarefas de…

Modelos de IA e LLMs

Nº 31 em LLMs

Ver ferramenta

Modelo de linguagem fundamental com uma arquitetura híbrida e camadas MoE, apresentando 80 bilhões de parâmetros. Ele se destaca em tarefas de…AliceAI-Foundation-80B-A3B-Base é um modelo de linguagem fundamental com uma arquitetura híbrida e camadas MoE, apresentando 80 bilhões de parâmetros. Ele se destaca em tarefas de…

Modelos de IA e LLMs
Nº 31 em LLMs

Ling-3.0-flash é um modelo de raciocínio híbrido de próxima geração projetado para eficiência e desempenho. Com 124 bilhões de parâmetros, ele se destaca em raciocínio, seguimento…

Modelos de IA e LLMs

Nº 64 em LLMs

Ver ferramenta

Modelo de raciocínio híbrido de próxima geração projetado para eficiência e desempenho. Com 124 bilhões de parâmetros, ele se destaca em raciocínio, seguimento…Ling-3.0-flash é um modelo de raciocínio híbrido de próxima geração projetado para eficiência e desempenho. Com 124 bilhões de parâmetros, ele se destaca em raciocínio, seguimento…

Modelos de IA e LLMs
Nº 64 em LLMs

DeepSeek-V3

Repositórios de IA no GitHub

DeepSeek-V3 é um modelo de linguagem Mixture-of-Experts de peso aberto da DeepSeek, com 671 bilhões de parâmetros no total e 37 bilhões ativados por token. Pré-treinado em 14,8…

Modelos de IA e LLMs
Ver ferramenta

Repositórios de IA no GitHub

Modelo de linguagem Mixture-of-Experts de peso aberto da DeepSeek, com 671 bilhões de parâmetros no total e 37 bilhões ativados por token. Pré-treinado em 14,8…DeepSeek-V3 é um modelo de linguagem Mixture-of-Experts de peso aberto da DeepSeek, com 671 bilhões de parâmetros no total e 37 bilhões ativados por token. Pré-treinado em 14,8…

Modelos de IA e LLMs
Ver o Top 250 de Repositórios de IA no GitHub

Kimi-K2-Instruct é um modelo de linguagem de mistura de especialistas de última geração, projetado para tarefas avançadas de IA. Ele se destaca em raciocínio, codificação e uso de…

Modelos de IA e LLMs

Nº 51 em LLMs

Ver ferramenta

Kimi-K2-Instruct é um modelo de linguagem de mistura de especialistas de última geração, projetado para tarefas avançadas de IA. Ele se destaca em raciocínio, codificação e uso de…

Modelos de IA e LLMs
Nº 51 em LLMs
1 de 8