Pular para o conteúdo principal
ToolPotion
Consultor de IA
Enviar

ERNIE-5.5-Flash-Base

LLMsModelos de IA e LLMsCódigo aberto · Web

ERNIE-5.5-Flash-Base é um modelo de linguagem eficiente e esparso Mixture-of-Experts (MoE) com 280 bilhões de parâmetros totais, projetado para geração de texto. Pré-treinado em 33,5 trilhões de tokens, suporta fine-tuning e inferência com um contexto de 1 milhão de tokens. Este modelo serve como um ponto de partida robusto para adaptação de domínio, ajuste de instruções e pesquisa em aprendizado por reforço, oferecendo um desempenho forte em vários benchmarks.

Visitar URL
Compartilhar
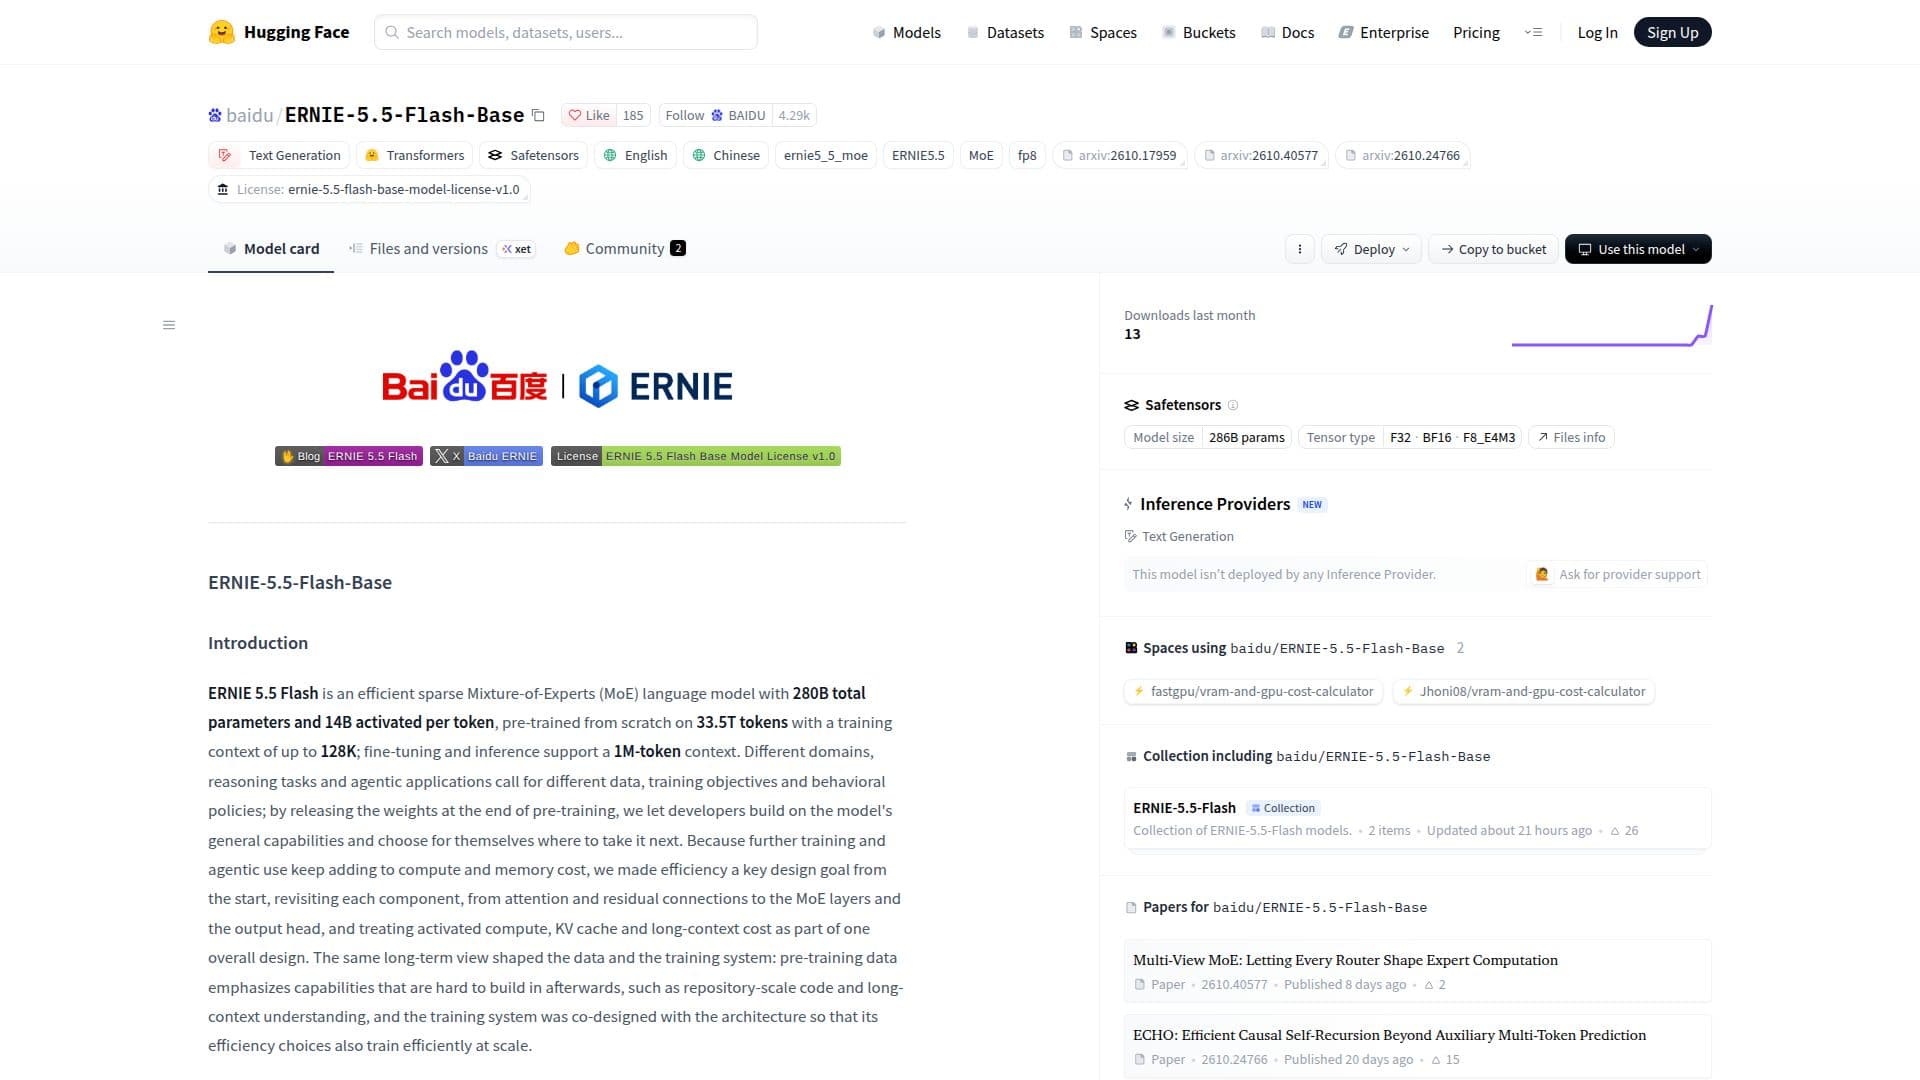
Captura de tela do ERNIE-5.5-Flash-Base

ERNIE-5.5-Flash-Base é um sofisticado modelo de geração de texto desenvolvido pela Baidu, disponível no Hugging Face. É um modelo de linguagem eficiente e esparso Mixture-of-Experts (MoE), com 280 bilhões de parâmetros totais e 14 bilhões ativados por token. O modelo foi pré-treinado do zero em um extenso conjunto de dados de 33,5 trilhões de tokens, utilizando um contexto de treinamento de até 128K. Para fine-tuning e inferência, suporta um impressionante comprimento de contexto de 1 milhão de tokens.

Ler mais

Projetado com eficiência como um objetivo central, ERNIE 5.5 Flash revisita cada componente, desde mecanismos de atenção e conexões residuais até camadas MoE e a cabeça de saída. Esta abordagem holística considera o cálculo ativado, cache KV e custos de longo contexto como parte de um design integrado. Os dados de pré-treinamento enfatizam capacidades que são desafiadoras de construir pós-treinamento, como compreensão de código em escala de repositório e compreensão de longo contexto. O sistema de treinamento foi co-projetado com a arquitetura para garantir escalabilidade eficiente.

ERNIE-5.5-Flash-Base representa o ponto de verificação no final do pré-treinamento, tornando-se uma base ideal para desenvolvedores. Permite adaptação de domínio, ajuste de instruções e pesquisa em aprendizado por reforço. O modelo demonstra resultados fortes em um pipeline de avaliação unificado, cobrindo conhecimento, raciocínio, matemática, código, tarefas multilíngues e benchmarks de longo contexto. Seu desempenho é avaliado em comparação com outros grandes modelos como DeepSeek-V4-Flash-Base, Hy3-preview-Base e MiMo-V2.5-Base, todos avaliados sob condições consistentes.

A arquitetura incorpora um MoE de atenção híbrida 280B-A14B com 43 camadas, incluindo 1 FFN densa e 42 camadas MoE Latente Multi-Router. Apresenta 37 camadas de Atenção Comprimida Pesada (HCA) e 6 camadas de Atenção Latente Multi-cabeça com atenção esparsa (MLA + DSA). O modelo utiliza 512 especialistas roteados (top-10) além de 1 especialista compartilhado por camada MoE. Inovações chave incluem atenção híbrida MLA + HCA com dimensões de cabeça específicas da camada, Atenção Gated de Baixa Classificação, Atenção de Cabeça Virtual (VHA), MoE Latente Multi-Router, ECHO para previsão de tokens futuros, Conexões Hiper-Manifold (mHC) e uma Cabeça de Saída MultiMax. O tokenizer utiliza um tokenizer BPE de ≈200K entradas que tokeniza números da direita para a esquerda em grupos de até três dígitos.

A implementação do ERNIE-5.5-Flash-Base é suportada com SGLang e vLLM, permitindo serviço de produção com comprimentos de contexto de até 1.048.576 tokens para inferência de longo contexto. O modelo é fornecido sob o Acordo de Licença do Modelo ERNIE 5.5 Flash Base v1.0, com direitos autorais mantidos pela Baidu.

  • CategoriaModelos de IA e LLMs
  • Modelo de preçosCódigo aberto
  • ImplantaçãoNuvem
  • PlataformasWeb

  • 280 bilhões de parâmetros totais com 14 bilhões ativados por token

  • Pré-treinado em 33,5 trilhões de tokens

  • Suporta contexto de 1 milhão de tokens para fine-tuning e inferência

  • Arquitetura eficiente de Mixture-of-Experts (MoE) esparsa

  • Atenção híbrida MLA + HCA com dimensões de cabeça específicas da camada

  • Atenção Gated de Baixa Classificação e Atenção de Cabeça Virtual (VHA)

  • MoE Latente Multi-Router com 512 especialistas roteados e 1 especialista compartilhado

  • ECHO para perda multi-horizonte e decodificação especulativa

  • Conexões Hiper-Manifold (mHC) para propagação de sinal

  • Cabeça de Saída MultiMax para distribuição de vocabulário aprimorada

  • Tokenizer BPE de ≈200K entradas com tokenização de números da direita para a esquerda

  • Suporta implementação com SGLang e vLLM

  • Desempenho forte em benchmarks de conhecimento, raciocínio, matemática, código, multilíngue e longo contexto

  • Pesos de precisão FP8 e BF16 disponíveis

  1. Acessar Modelo: Navegue até a página do ERNIE-5.5-Flash-Base no Hugging Face.

  2. Baixar Modelo: Escolha entre precisão FP8 (safetensors) ou BF16 (safetensors) para download.

  3. Instalar Ferramentas de Implementação: Instale vLLM e o plugin ERNIE 5.5, ou use a imagem Docker pré-construída oficial do SGLang.

  4. Iniciar Servidor: Inicie o servidor vLLM ou SGLang para hospedar o modelo.

  5. Enviar Solicitações: Use curl ou outros clientes de API para enviar solicitações ao endpoint de completions para geração de texto.

  6. Ajustar Modelo: Utilize o ponto de verificação pré-treinado para adaptação de domínio, ajuste de instruções ou pesquisa em aprendizado por reforço.

  • Geração de Texto
  • Adaptação de Domínio
  • Ajuste de Instruções
  • Pesquisa em Aprendizado por Reforço
  • Geração e Compreensão de Código
  • Compreensão de Longo Contexto
  • Aplicações Multilíngues
  • Tarefas de Raciocínio

De Baidu

Um modelo de Baidu Wenxin Assistant.

Avaliações de ERNIE-5.5-Flash-Base

Carregando...

Ferramentas de IA populares como ERNIE-5.5-Flash-Base

DeepSeek-V4-Pro é um modelo de IA avançado projetado para inteligência de contexto eficiente com milhões de tokens. Ele apresenta uma arquitetura de atenção híbrida e é…

Modelos de IA e LLMs
Ver ferramenta

Modelo de IA avançado projetado para inteligência de contexto eficiente com milhões de tokens. Ele apresenta uma arquitetura de atenção híbrida e é…DeepSeek-V4-Pro é um modelo de IA avançado projetado para inteligência de contexto eficiente com milhões de tokens. Ele apresenta uma arquitetura de atenção híbrida e é…

DestaqueModelos de IA e LLMs
Ver o Top 50 de LLMs

DeepSeek-V3 é um modelo de linguagem Mixture-of-Experts com 671 bilhões de parâmetros, projetado para inferência eficiente e treinamento econômico. Ele se destaca em vários…

Modelos de IA e LLMs

Nº 37 em LLMs

Ver ferramenta

Modelo de linguagem Mixture-of-Experts com 671 bilhões de parâmetros, projetado para inferência eficiente e treinamento econômico. Ele se destaca em vários…DeepSeek-V3 é um modelo de linguagem Mixture-of-Experts com 671 bilhões de parâmetros, projetado para inferência eficiente e treinamento econômico. Ele se destaca em vários…

DestaqueModelos de IA e LLMs
Nº 37 em LLMs

AliceAI-Foundation-80B-A3B-Base é um modelo de linguagem fundamental com uma arquitetura híbrida e camadas MoE, apresentando 80 bilhões de parâmetros. Ele se destaca em tarefas de…

Modelos de IA e LLMs

Nº 28 em LLMs

Ver ferramenta

Modelo de linguagem fundamental com uma arquitetura híbrida e camadas MoE, apresentando 80 bilhões de parâmetros. Ele se destaca em tarefas de…AliceAI-Foundation-80B-A3B-Base é um modelo de linguagem fundamental com uma arquitetura híbrida e camadas MoE, apresentando 80 bilhões de parâmetros. Ele se destaca em tarefas de…

Modelos de IA e LLMs
Nº 28 em LLMs

Ling-3.0-flash é um modelo de raciocínio híbrido de próxima geração projetado para eficiência e desempenho. Com 124 bilhões de parâmetros, ele se destaca em raciocínio, seguimento…

Modelos de IA e LLMs
Ver ferramenta

Modelo de raciocínio híbrido de próxima geração projetado para eficiência e desempenho. Com 124 bilhões de parâmetros, ele se destaca em raciocínio, seguimento…Ling-3.0-flash é um modelo de raciocínio híbrido de próxima geração projetado para eficiência e desempenho. Com 124 bilhões de parâmetros, ele se destaca em raciocínio, seguimento…

Modelos de IA e LLMs
Ver o Top 50 de LLMs

Kimi-K2-Instruct é um modelo de linguagem de mistura de especialistas de última geração, projetado para tarefas avançadas de IA. Ele se destaca em raciocínio, codificação e uso de…

Modelos de IA e LLMs

Nº 46 em LLMs

Ver ferramenta

Kimi-K2-Instruct é um modelo de linguagem de mistura de especialistas de última geração, projetado para tarefas avançadas de IA. Ele se destaca em raciocínio, codificação e uso de…

Modelos de IA e LLMs
Nº 46 em LLMs

MiniMax-M3.1-Flash é um modelo multimodal de mistura de especialistas projetado para codificação, fluxos de trabalho agentes e cibersegurança. Ele suporta entradas de texto,…

Modelos de IA e LLMs
Ver ferramenta

Modelo multimodal de mistura de especialistas projetado para codificação, fluxos de trabalho agentes e cibersegurança. Ele suporta entradas de texto,…MiniMax-M3.1-Flash é um modelo multimodal de mistura de especialistas projetado para codificação, fluxos de trabalho agentes e cibersegurança. Ele suporta entradas de texto,…

Modelos de IA e LLMs
Ver o Top 50 de LLMs

DeepSeek-V4-Pro-DSpark é um modelo de linguagem avançado com uma arquitetura de atenção híbrida e hiper-conexões com restrição de variedade. Ele suporta um comprimento de contexto…

Modelos de IA e LLMs
Ver ferramenta

Modelo de linguagem avançado com uma arquitetura de atenção híbrida e hiper-conexões com restrição de variedade. Ele suporta um comprimento de contexto…DeepSeek-V4-Pro-DSpark é um modelo de linguagem avançado com uma arquitetura de atenção híbrida e hiper-conexões com restrição de variedade. Ele suporta um comprimento de contexto…

Modelos de IA e LLMs
Ver o Top 50 de LLMs

Solar Open 2 é um modelo de linguagem de grande porte da Upstage, projetado para casos de uso agentivos como produtividade em escritório e programação. Ele apresenta uma…

Modelos de IA e LLMs

Nº 19 em LLMs

Ver ferramenta

Modelo de linguagem de grande porte da Upstage, projetado para casos de uso agentivos como produtividade em escritório e programação. Ele apresenta uma…Solar Open 2 é um modelo de linguagem de grande porte da Upstage, projetado para casos de uso agentivos como produtividade em escritório e programação. Ele apresenta uma…

Modelos de IA e LLMs
Nº 19 em LLMs
1 de 8