본문으로 건너뛰기
ToolPotion
AI 어드바이저
제출 (무료)

WeMM-Video-35B-A3B

LLM#38AI 모델 및 LLM오픈소스 · 웹

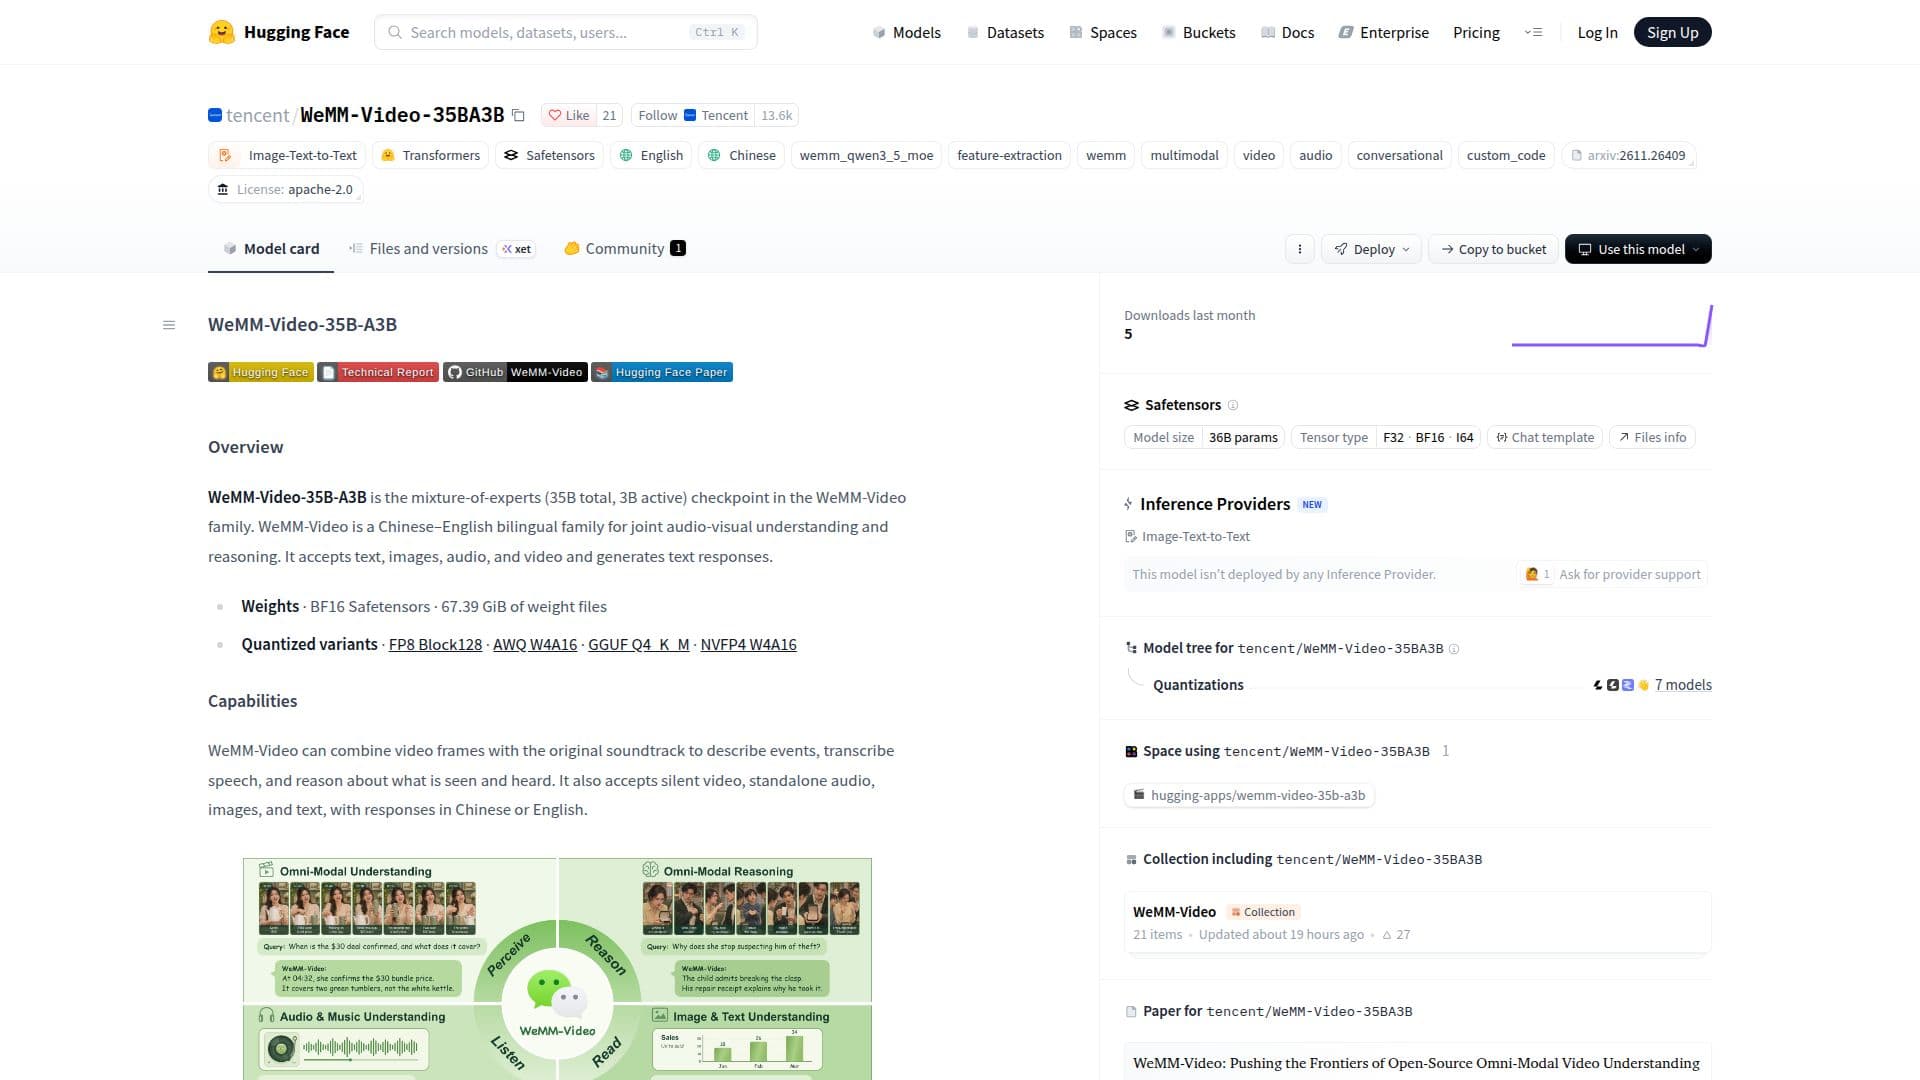
WeMM-Video-35B-A3B는 WeMM-Video 계열의 전문가 혼합 모델로, 공동 오디오-비주얼 이해 및 추론을 위해 설계되었습니다. 이 중국어-영어 이중 언어 모델은 텍스트, 이미지, 오디오 및 비디오 입력을 받아 텍스트 응답을 생성합니다. 사건을 설명하고, 음성을 기록하며, 보고 들은 것에 대해 추론할 수 있으며, 직접 응답 및 추론 응답 모드를 제공합니다.

URL 방문
공유
WeMM-Video-35B-A3B 스크린샷

WeMM-Video-35B-A3B는 포괄적인 오디오-비주얼 이해 및 추론을 위해 개발된 정교한 전문가 혼합 모델로, WeMM-Video 계열의 일부입니다. 총 350억 개의 매개변수와 30억 개의 활성 매개변수를 가진 이 모델은 텍스트, 이미지, 오디오 및 비디오를 포함한 다중 모드 입력을 처리하고 해석하도록 특별히 설계되어 있으며, 중국어 또는 영어로 일관된 텍스트 응답을 생성합니다.

더 읽기

모델의 핵심 기능은 비디오 프레임과 원래 사운드트랙을 결합하여 사건을 설명하고, 음성을 정확하게 기록하며, 시각적 및 청각적 정보를 기반으로 추론 작업을 수행하는 능력을 포함합니다. 또한 무음 비디오, 독립 오디오, 이미지 및 텍스트 입력을 독립적으로 처리할 수 있을 만큼 다재다능합니다. 이는 다양한 미디어 유형에 걸쳐 깊은 맥락 이해가 필요한 광범위한 응용 프로그램에 적합합니다.

구조적으로 WeMM-Video-35B-A3B는 비전 및 오디오 인코더를 사용하여 미디어 입력을 토큰으로 변환하며, 이는 텍스트와 함께 언어 모델에 의해 처리됩니다. 비디오 프레임은 시간적 맥락을 유지하기 위해 타임스탬프가 추가됩니다. 모델 계열은 약 1.2조 개의 다중 모드 토큰에 대해 광범위한 사전 훈련을 거쳤으며, 이후 성능과 강인성을 향상시키기 위해 다중 교사 OPD, 반복 방지 MrDPO 및 전문 강화 학습과 같은 고급 후 훈련 기술을 적용했습니다.

배포 및 통합은 다양한 서비스 옵션을 통해 용이하게 이루어집니다. 사용자는 Transformers 환경을 설정하고 WeMM-Video 리포지토리에서 직접 예제를 실행할 수 있습니다. 이 모델은 FP8 Block128, AWQ W4A16, GGUF Q4_K_M 및 NVFP4 W4A16과 같은 양자화된 변형을 지원합니다. 서비스 제공을 위해 패치된 vLLM(0.18.0 및 0.31.0) 및 SGLang(0.5.16 또는 0.5.19) 버전과 호환되어 여러 GPU에 걸쳐 텐서 병렬성을 포함한 효율적인 추론을 가능하게 합니다. 또한 기본 지시 모드와 추론 응답을 위한 '사고 모드'를 포함한 다양한 채팅 모드를 제공합니다.

WeMM-Video-35B-A3B는 강력한 성능을 입증하며 새로운 오픈 소스 최첨단 기술을 확립했습니다. Qwen3.5-Omni-Flash 및 Seed2.0-Mini-0428과 같은 독점 모델을 능가하며, Gemini-3.0-Flash와 같은 고급 모델과의 성능 격차를 크게 좁혔습니다. 이 모델은 Apache License 2.0 하에 출시되어 AI 커뮤니티 내에서의 개방형 접근 및 협업을 촉진합니다.

  • 카테고리AI 모델 및 LLM
  • 요금제오픈소스
  • 배포클라우드
  • 플랫폼웹

  • 중국어-영어 이중 언어 처리

  • 공동 오디오-비주얼 이해 및 추론

  • 텍스트, 이미지, 오디오 및 비디오 입력 수용

  • 텍스트 응답 생성

  • 비디오 프레임 및 사운드트랙에서 사건 설명

  • 오디오에서 음성 기록

  • 시각적 및 청각적 정보에 대한 추론

  • 무음 비디오 및 독립 오디오 처리 지원

  • 전문가 혼합 아키텍처 (총 35B, 활성 3B 매개변수)

  • 1.2조 개의 다중 모드 토큰에 대해 사전 훈련됨

  • 다중 교사 OPD 및 MrDPO로 후 훈련됨

  • 성능 향상을 위한 전문 강화 학습

  • 다양한 양자화 변형 지원 (FP8, AWQ, GGUF, NVFP4)

  • 서비스 제공을 위한 패치된 vLLM 및 SGLang과 호환

  • 지시 및 사고 채팅 모드 제공

  1. 환경 설정: Transformers 환경 및 필요한 종속성을 설치합니다.

  2. 모델 로드: Hugging Face Hub에서 WeMM-Video-35B-A3B 모델 및 프로세서를 로드합니다.

  3. 입력 준비: MP4 비디오 파일, 독립 오디오, 이미지 또는 텍스트와 같은 미디어 입력을 제공합니다.

  4. 미디어 처리: 스크립트를 사용하여 비디오 프레임을 원래 오디오 트랙과 함께 또는 단독으로 처리합니다.

  5. 응답 생성: 모델에 요청을 보내고 텍스트 생성을 위한 채팅 모드(지시 또는 사고)를 지정합니다.

  6. 모델 제공(선택 사항): WeMM 런타임 패치를 설치하고 패치된 vLLM 또는 SGLang을 사용하여 API 서비스를 제공합니다.

  7. API 요청 전송: 번들된 요청 클라이언트를 사용하여 OpenAI 호환 채팅 엔드포인트에 미디어를 인라인으로 전송합니다.

  • 비디오 콘텐츠 분석
  • 음성 기록
  • 다중 모드 추론
  • 이중 언어 콘텐츠 처리
  • 오디오-비주얼 사건 설명
  • AI 모델 개발
  • 연구 및 실험

WeMM-Video-35B-A3B와(과) 비슷한 인기 AI 도구

Llama-3.2-11B-Vision-Instruct는 시각 인식, 이미지 추론 및 캡션 생성을 위해 설계된 다중 모달 AI 모델입니다. Meta에서 개발하였으며, 텍스트와 이미지 입력을 통합하여 고급 이미지 이해 기능을 제공합니다.

AI 모델 및 LLM
도구 보기

시각 인식, 이미지 추론 및 캡션 생성을 위해 설계된 다중 모달 AI 모델입니다. Meta에서 개발하였으며, 텍스트와 이미지 입력을 통합하여 고급 이미지 이해 기능을 제공합니다.Llama-3.2-11B-Vision-Instruct는 시각 인식, 이미지 추론 및 캡션 생성을 위해 설계된 다중 모달 AI 모델입니다. Meta에서 개발하였으며, 텍스트와 이미지 입력을 통합하여 고급 이미지 이해 기능을 제공합니다.

AI 모델 및 LLM
AI 모델 TOP 5 보기

Step 3.7 Flash는 고주파 생산 작업을 위해 설계된 희소 Mixture-of-Experts 비전-언어 모델입니다. 이는 언어 백본과 비전 인코더를 결합하여 재무 보고서 파싱 및 다단계 검색 루프 실행과 같은 집중적인 작업을 지원합니다.

AI 모델 및 LLM

LLM 81위

도구 보기

고주파 생산 작업을 위해 설계된 희소 Mixture-of-Experts 비전-언어 모델입니다. 이는 언어 백본과 비전 인코더를 결합하여 재무 보고서 파싱 및 다단계 검색 루프 실행과 같은 집중적인 작업을 지원합니다.Step 3.7 Flash는 고주파 생산 작업을 위해 설계된 희소 Mixture-of-Experts 비전-언어 모델입니다. 이는 언어 백본과 비전 인코더를 결합하여 재무 보고서 파싱 및 다단계 검색 루프 실행과 같은 집중적인 작업을 지원합니다.

AI 모델 및 LLM
LLM 81위

Apertus 1.5는 다양한 언어와 맥락을 지원하도록 설계된 다국어, 다중 모드 언어 모델의 집합입니다. 오픈 소스 접근과 향상된 추론 기능을 제공하여 다양한 AI 애플리케이션에 적합합니다.

AI 모델 및 LLM

LLM 72위

도구 보기

다양한 언어와 맥락을 지원하도록 설계된 다국어, 다중 모드 언어 모델의 집합입니다. 오픈 소스 접근과 향상된 추론 기능을 제공하여 다양한 AI 애플리케이션에 적합합니다.Apertus 1.5는 다양한 언어와 맥락을 지원하도록 설계된 다국어, 다중 모드 언어 모델의 집합입니다. 오픈 소스 접근과 향상된 추론 기능을 제공하여 다양한 AI 애플리케이션에 적합합니다.

AI 모델 및 LLM
LLM 72위

Llama-4 Maverick 17B-128E Instruct는 Meta에서 개발한 다중 모달 AI 모델로, 고급 텍스트 및 이미지 이해를 위해 설계되었습니다. 다양한 응용 프로그램에서 높은 성능을 제공하기 위해 전문가 혼합 아키텍처를 활용합니다.

AI 모델 및 LLM
도구 보기

Meta에서 개발한 다중 모달 AI 모델로, 고급 텍스트 및 이미지 이해를 위해 설계되었습니다. 다양한 응용 프로그램에서 높은 성능을 제공하기 위해 전문가 혼합 아키텍처를 활용합니다.Llama-4 Maverick 17B-128E Instruct는 Meta에서 개발한 다중 모달 AI 모델로, 고급 텍스트 및 이미지 이해를 위해 설계되었습니다. 다양한 응용 프로그램에서 높은 성능을 제공하기 위해 전문가 혼합 아키텍처를 활용합니다.

AI 모델 및 LLM
AI 모델 TOP 5 보기

Nemotron-Labs-Audex-2B는 이해, 인식 및 번역과 같은 오디오 작업을 위해 설계된 통합 오디오-텍스트 대형 언어 모델입니다. 사고 및 지시 모드를 모두 지원하며, 다양한 오디오 및 텍스트 응용 프로그램을 위한 컴팩트하고 효율적인 솔루션을 제공합니다.

AI 모델 및 LLM

LLM 33위

도구 보기

이해, 인식 및 번역과 같은 오디오 작업을 위해 설계된 통합 오디오-텍스트 대형 언어 모델입니다. 사고 및 지시 모드를 모두 지원하며, 다양한 오디오 및 텍스트 응용 프로그램을 위한 컴팩트하고 효율적인 솔루션을 제공합니다.Nemotron-Labs-Audex-2B는 이해, 인식 및 번역과 같은 오디오 작업을 위해 설계된 통합 오디오-텍스트 대형 언어 모델입니다. 사고 및 지시 모드를 모두 지원하며, 다양한 오디오 및 텍스트 응용 프로그램을 위한 컴팩트하고 효율적인 솔루션을 제공합니다.

AI 모델 및 LLM
LLM 33위

제미니 3.1 프로는 복잡한 작업과 깊은 추론을 위해 설계된 고급 AI 모델입니다. 다중 모드 이해에 뛰어나며, 스마트하고 간결한 응답을 제공하여 학습, 계획 및 혁신적인 애플리케이션 구축에 이상적입니다.

AI 모델 및 LLM
도구 보기

복잡한 작업과 깊은 추론을 위해 설계된 고급 AI 모델입니다. 다중 모드 이해에 뛰어나며, 스마트하고 간결한 응답을 제공하여 학습, 계획 및 혁신적인 애플리케이션 구축에 이상적입니다.제미니 3.1 프로는 복잡한 작업과 깊은 추론을 위해 설계된 고급 AI 모델입니다. 다중 모드 이해에 뛰어나며, 스마트하고 간결한 응답을 제공하여 학습, 계획 및 혁신적인 애플리케이션 구축에 이상적입니다.

추천AI 모델 및 LLM
AI 모델 TOP 5 보기

Llama-4-Scout-17B-16E-Instruct는 Meta에서 설계한 다중 모달 AI 모델입니다. 이 모델은 전문가 혼합 아키텍처를 활용하여 고급 텍스트 및 이미지 이해 기능을 제공하며, 다국어 출력과 다양한 응용 프로그램을 위한 미세 조정을 지원합니다.

AI 모델 및 LLM
도구 보기

Meta에서 설계한 다중 모달 AI 모델입니다. 이 모델은 전문가 혼합 아키텍처를 활용하여 고급 텍스트 및 이미지 이해 기능을 제공하며, 다국어 출력과 다양한 응용 프로그램을 위한 미세 조정을 지원합니다.Llama-4-Scout-17B-16E-Instruct는 Meta에서 설계한 다중 모달 AI 모델입니다. 이 모델은 전문가 혼합 아키텍처를 활용하여 고급 텍스트 및 이미지 이해 기능을 제공하며, 다국어 출력과 다양한 응용 프로그램을 위한 미세 조정을 지원합니다.

AI 모델 및 LLM
AI 모델 TOP 5 보기

Qwen3-VL

AI GitHub 저장소

Qwen3-VL은 Alibaba Cloud의 Qwen 팀에서 개발한 비전-언어 모델 시리즈로, Dense 및 Mixture-of-Experts 크기로 출시되었으며, 지시 및 추론("Thinking") 버전이 포함되어 있습니다. 이 모델은 이미지, 비디오 및 텍스트를 함께 읽으며, 기본 256K 컨텍스트 창을 1M으로…

AI 모델 및 LLM
도구 보기

AI GitHub 저장소

Alibaba Cloud의 Qwen 팀에서 개발한 비전-언어 모델 시리즈로, Dense 및 Mixture-of-Experts 크기로 출시되었으며, 지시 및 추론("Thinking") 버전이 포함되어 있습니다. 이 모델은 이미지, 비디오 및 텍스트를 함께 읽으며, 기본 256K 컨텍스트 창을 1M으로…Qwen3-VL은 Alibaba Cloud의 Qwen 팀에서 개발한 비전-언어 모델 시리즈로, Dense 및 Mixture-of-Experts 크기로 출시되었으며, 지시 및 추론("Thinking") 버전이 포함되어 있습니다. 이 모델은 이미지, 비디오 및 텍스트를 함께 읽으며, 기본 256K 컨텍스트 창을 1M으로…

AI 모델 및 LLM
AI GitHub 저장소 TOP 250 보기
1/8