설명
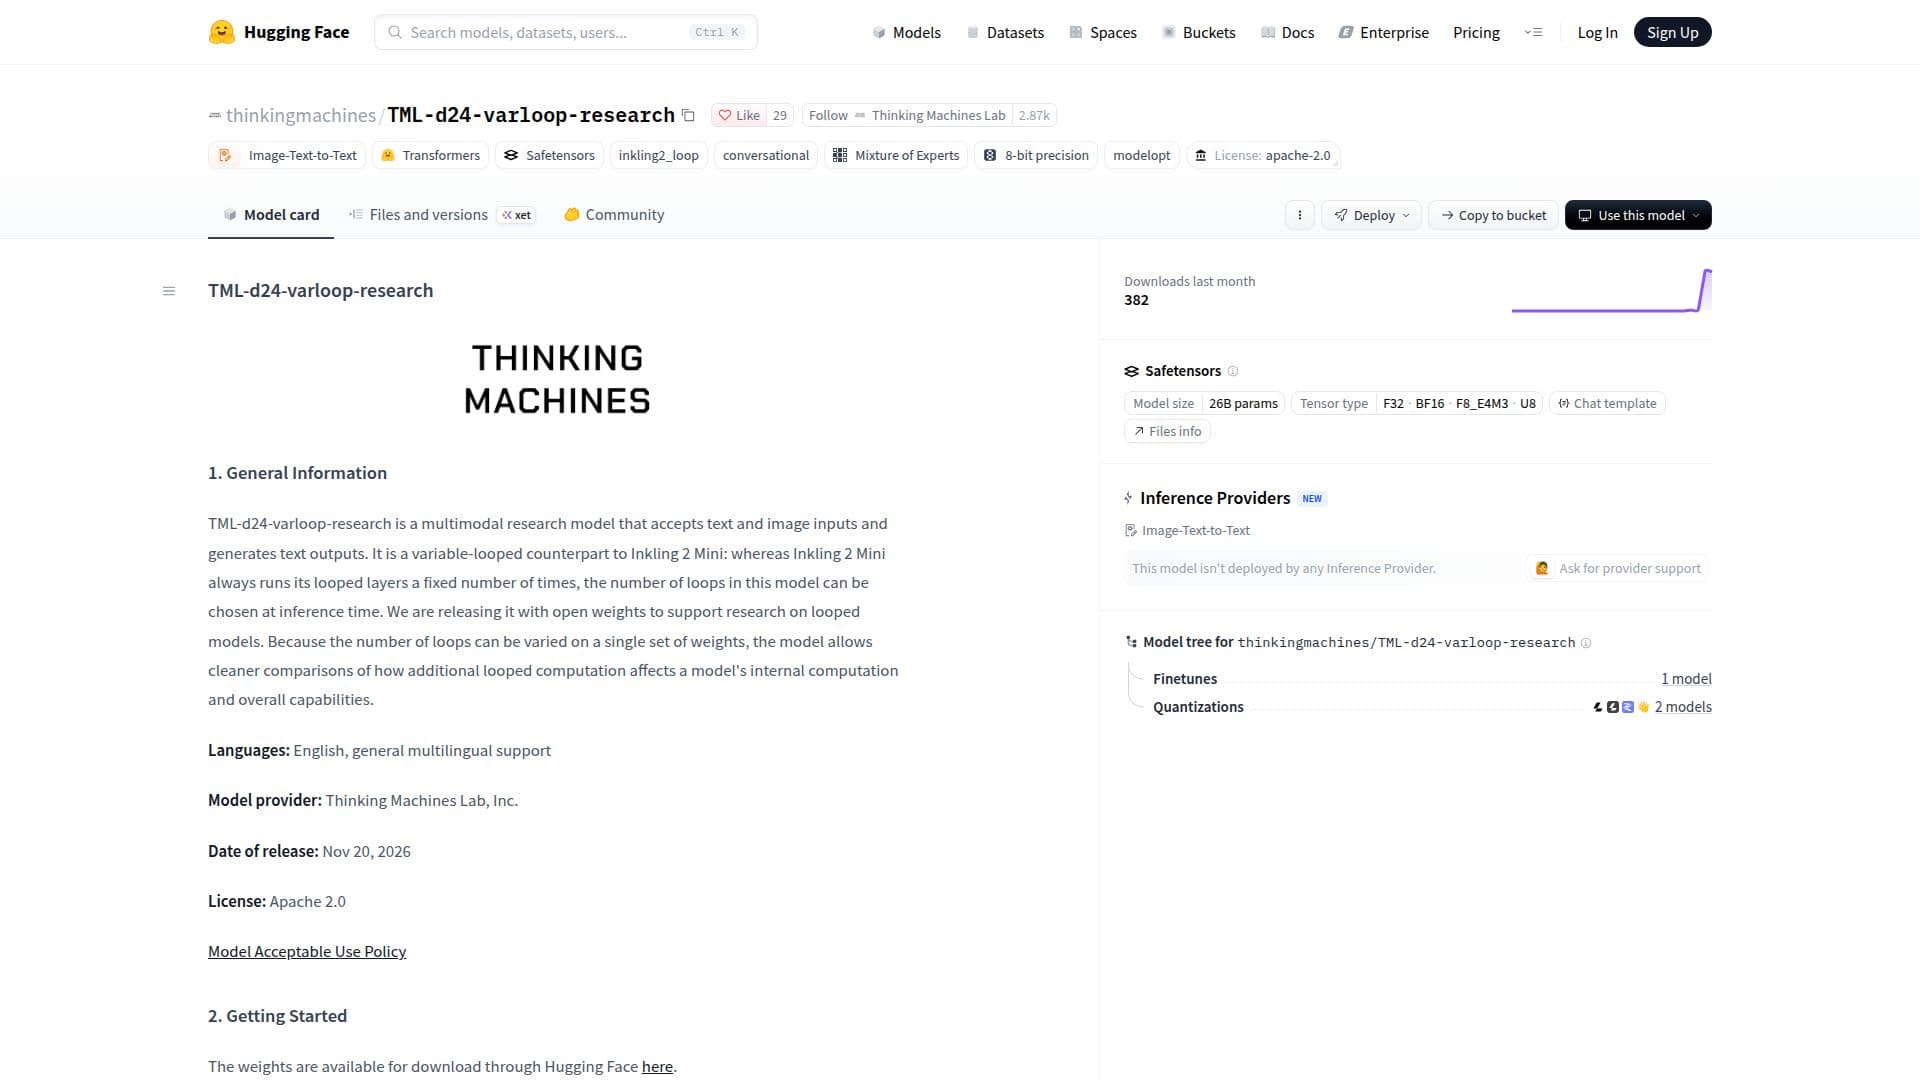
TML-d24-varloop-research는 Thinking Machines Lab, Inc.에서 개발한 다중 모달 연구 모델로, 텍스트와 이미지 입력을 처리하고 텍스트 출력을 생성하도록 설계되었습니다. 2026년 11월 20일에 Apache 2.0 라이선스 하에 출시된 이 모델은 루프 모델 분야에 중요한 기여를 하며, 고정 루프 구조인 Inkling 2 Mini와는 다른 변형 루프 아키텍처를 제공합니다. 연구자들은 추론 중에 루프 수를 동적으로 조정할 수 있어 추가 계산이 모델의 내부 프로세스와 전반적인 능력에 미치는 영향을 보다 명확하게 비교할 수 있습니다.
더 읽기
이 모델은 Hugging Face를 통해 오픈 가중치로 배포되며, 단일 체크포인트 크기는 약 20GB입니다. NVIDIA DGX Spark, NVIDIA GPU(예: GeForce RTX 5090 또는 RTX PRO 6000 Blackwell) 또는 Apple 실리콘 Mac과 같은 구성과 호환되는 최소 32GB의 GPU 또는 통합 메모리를 갖춘 머신이 필요합니다. TML-d24-varloop-research는 Hugging Face, SGLang, vLLM, TokenSpeed, NVIDIA Dynamo, Unsloth, llama.cpp, Llama App, Ollama 및 Exo Labs와 같은 다양한 프레임워크를 사용하여 로컬 추론을 지원합니다. 또한 Miles 및 SkyRL과 함께 후속 훈련을 지원합니다.
구조적으로 TML-d24-varloop-research는 희소 혼합 전문가(MoE) 피드포워드 레이어를 갖춘 24층 디코더 전용 변환기입니다. 중간 12개 레이어는 가변 횟수로 실행할 수 있으며, 가중치를 공유하고 1회에서 5회까지 훈련되었습니다. 각 레이어는 128명의 전문가 중 8명에게 토큰을 라우팅하며, 주의(attention)는 지역 및 글로벌 레이어의 하이브리드입니다. 이 모델은 본래 다중 모달로, 비전 변환기를 통해 이미지를 인코딩하고 텍스트와 함께 공유된 숨겨진 공간에서 함께 처리합니다. 264억 개의 매개변수를 특징으로 하며(1회 통과 시 34억 개 활성화), NVFP4 및 MXFP8 수치 형식을 지원합니다. UTF-8로 인코딩된 텍스트와 픽셀 기반 이미지 입력(차원당 40px에서 4096px까지)을 처리하며 최대 100만 개의 토큰을 지원하는 컨텍스트 윈도우를 갖추고 있습니다.
TML-d24-varloop-research의 훈련 데이터는 공개적으로 사용 가능한 소스, 제3자 인수 및 내부/합성 생성 데이터의 다양한 콘텐츠 유형을 포함합니다. 데이터 큐레이션 과정에서는 품질과 안전성을 보장하기 위해 정리, 중복 제거 및 필터링이 이루어졌습니다. 이 모델은 Inkling 2 Mini와 사전 훈련 및 중간 훈련의 첫 번째 단계를 공유하지만, 특히 가변 루프 훈련에서 1회에서 5회까지 샘플링되는 후속 단계에서 차별화됩니다. 평가 결과는 Agentic Coding, Vision Interpretation 및 Reasoning과 같은 벤치마크에서 Inkling 2 Mini와 비교하여 다양한 성능을 보여주지만, 주로 연구 아티팩트로 의도되며, 다양한 통과 수에서의 예측할 수 없는 행동과 기초 모델에서 일반적으로 발생하는 한계(예: 환각 및 훈련 데이터의 편향)로 인해 생산 사용을 권장하지 않습니다.
- 카테고리AI 모델 및 LLM
- 요금제오픈소스
- 배포로컬 실행
- 플랫폼웹
TML-d24-varloop-research 하이라이트
다중 모달 입력: 텍스트와 이미지 입력을 모두 수용
텍스트 출력: 입력에 따라 텍스트 생성
가변 루핑: 추론 시 루프 레이어 수 선택 가능
오픈 가중치: 연구 지원을 위해 다운로드 가능
264억 개 매개변수: 1회 통과 시 34억 개 활성화된 대규모 모델
다국어 지원: 여러 언어에 대한 일반적인 지원
Apache 2.0 라이선스: 사용 및 수정에 대한 오픈 소스 라이선스
로컬 추론 지원: Hugging Face, SGLang, vLLM, TokenSpeed, NVIDIA Dynamo, Unsloth, llama.cpp, Llama App, Ollama, Exo Labs와 호환
후속 훈련 지원: Miles 및 SkyRL과 함께 후속 훈련 가능
희소 혼합 전문가(MoE): MoE 피드포워드 레이어 활용
하이브리드 주의: 지역 및 글로벌 주의 레이어 결합
본래 다중 모달성: 비전 변환기를 통해 인코딩된 이미지와 텍스트를 함께 처리
높은 컨텍스트 윈도우: 최대 100만 개의 토큰 지원
혼합 정밀도 수치: NVFP4 및 MXFP8 지원
TML-d24-varloop-research 시작하기
가중치 다운로드: Hugging Face를 통해 모델 가중치에 접근합니다.
하드웨어 준비: 최소 32GB의 GPU 또는 통합 메모리를 갖춘 단일 머신을 준비합니다.
소프트웨어 설치: Hugging Face, SGLang 또는 vLLM과 같은 필요한 추론 프레임워크와 그 종속성을 설정합니다.
모델 구성: 선택한 프레임워크에 20GB 체크포인트를 로드합니다.
루프 통과 설정: 추론을 위한 원하는 루프 레이어 수를 선택합니다.
입력 제공: UTF-8로 인코딩된 텍스트와 픽셀 기반 이미지(40px-4096px 차원)를 모델에 제공합니다.
출력 생성: 제공된 입력에 따라 모델에서 텍스트 출력을 받습니다.
TML-d24-varloop-research의 사용 사례
- 다중 모달 연구
- 루프 모델 연구
- 이미지에서 텍스트 생성
- 다국어 텍스트 처리
- 오픈 가중치 모델 개발
- 로컬 추론 배포
- 모델 미세 조정