본문으로 건너뛰기
ToolPotion
AI 어드바이저
제출 (무료)

SenseNova-Loop-9B-Preview

LLM#85AI 모델 및 LLM오픈소스 · 웹

SenseNova-Loop-9B-Preview는 긴 맥락과 에이전트 워크플로우를 위해 설계된 다중 모달 언어 모델입니다. 텍스트와 이미지를 모두 처리하여 텍스트 출력을 생성하며, 문서 이해, 코딩 및 외부 도구 상호작용과 같은 애플리케이션을 지원합니다. 이 모델은 독특한 루프 디코더 아키텍처와 효율적이고 깊은 실행 경로를 위한 두 개의 스트림 매니폴드 제약 하이퍼 연결을 특징으로 합니다.

URL 방문
공유
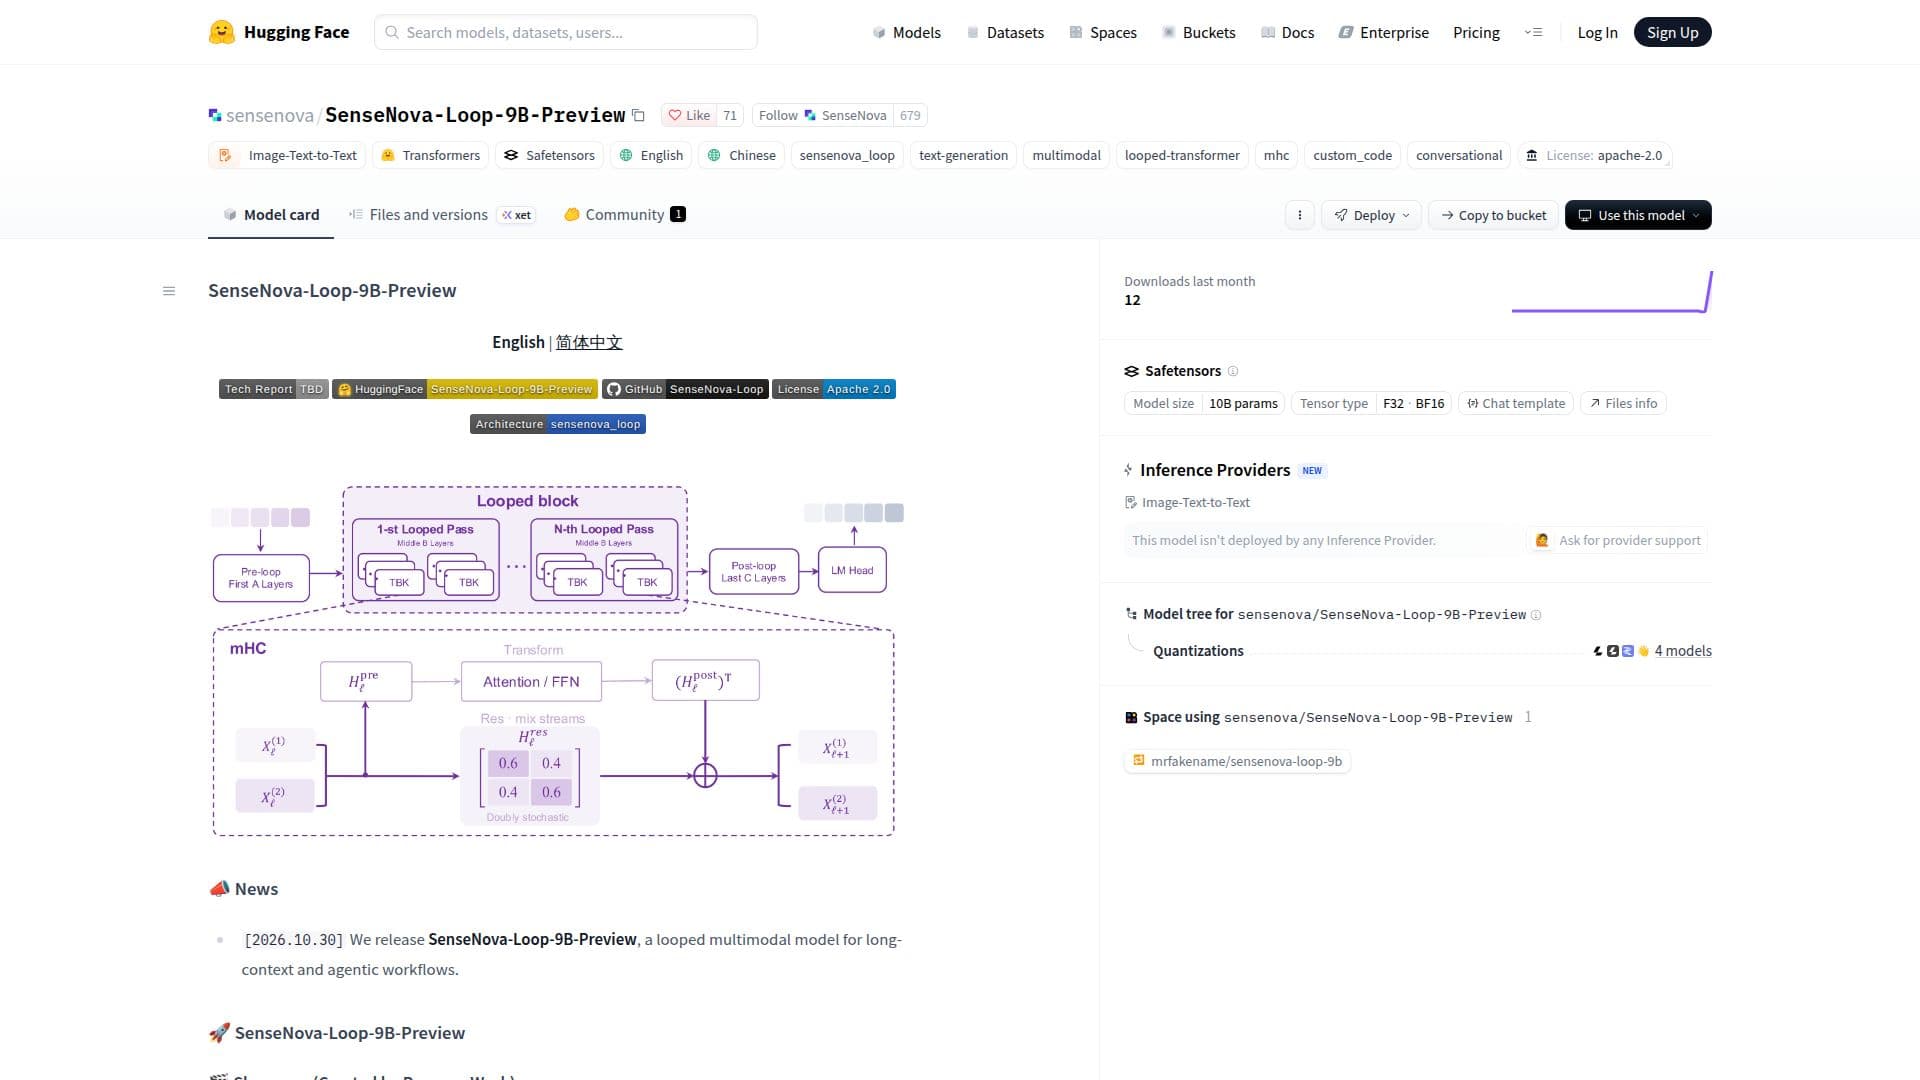
SenseNova-Loop-9B-Preview 스크린샷

SenseNova-Loop-9B-Preview는 복잡하고 긴 맥락 시나리오 및 에이전트 워크플로우를 처리하도록 설계된 고급 다중 모달 언어 모델입니다. SenseNova에 의해 개발된 이 모델은 텍스트와 이미지 입력을 모두 수용할 수 있으며, 이후 텍스트 출력을 생성합니다. 주요 애플리케이션은 포괄적인 문서 이해, 정교한 코딩 작업 및 다양한 외부 도구와의 원활한 상호작용을 포함합니다.

더 읽기

SenseNova-Loop-9B-Preview 아키텍처의 핵심은 루프 디코더와 두 개의 스트림 매니폴드 제약 하이퍼 연결(mHC)의 혁신적인 조합에 있습니다. 이 설계는 공유 가중치를 사용하여 디코더 레이어의 연속 블록을 두 번 실행할 수 있게 하여, 매개변수를 중복하지 않고 실행 경로를 크게 깊게 만듭니다. mHC 시스템 내에서 학습된 매핑은 루프 섹션의 두 개의 잔여 스트림 간의 정보 흐름을 효율적으로 관리하여 모델의 정보 처리 및 합성 능력을 향상시킵니다.

모델의 훈련 레시피는 긴 시퀀스, 다양한 다중 모달 입력 및 감독된 작업 경로를 포함하며, 최대 훈련 시퀀스 길이는 262,144 토큰에 달합니다. 이러한 광범위한 훈련은 다양한 복잡한 작업에서 강력한 성능을 가능하게 합니다. 최적의 작동을 위해 사용자는 문서화된 배포 환경 및 구성 매개변수를 활용할 것을 권장합니다.

주요 아키텍처 하이라이트에는 24개의 디코더 레이어가 두 번 적용되는 공유 루프 블록이 포함되어 있으며, 이는 단 32개의 고유 레이어에서 56개의 디코더 레이어 실행을 생성합니다. 두 개의 스트림 mHC는 잔여 스트림 간의 정보의 지능적인 라우팅 및 결합을 촉진합니다. 또한 디코더는 선형 및 전체 주의를 반복적인 네 개의 레이어 패턴으로 교차하여 하이브리드 주의 메커니즘을 사용하며, 이는 루프 패스 전반에 걸쳐 유지됩니다. 이 모델은 또한 가속화된 추론을 위한 MTP를 지원하며, 현재 Dspark 및 Dflash2가 속도 향상을 위해 개발 중입니다.

  • 카테고리AI 모델 및 LLM
  • 요금제오픈소스
  • 배포클라우드
  • 플랫폼웹

  • 다중 모달 입력: 텍스트와 이미지를 모두 수용

  • 텍스트 생성: 텍스트 출력을 생성

  • 루프 디코더 아키텍처: 공유 가중치로 디코더 레이어를 두 번 실행

  • 두 개의 스트림 매니폴드 제약 하이퍼 연결(mHC): 잔여 스트림 간의 정보 흐름 관리

  • 긴 맥락 처리: 최대 262,144 토큰의 훈련 시퀀스 길이 지원

  • 에이전트 워크플로우 지원: 외부 도구와의 상호작용을 위해 설계됨

  • 하이브리드 주의: 선형 및 전체 주의 레이어를 교차

  • 매개변수 효율성: 32개의 고유 레이어에서 56개의 디코더 레이어 실행 달성

  • 문서 이해: 복잡한 문서 처리 가능

  • 코딩 애플리케이션: 코드 관련 작업 지원

  • MTP 추론 가속화: 더 빠른 처리를 위해 사용 가능

  • 미세 조정 지원: 사용자 정의를 위한 문서화된 훈련 레시피 제공

  • Apache License 2.0: 사용 및 수정에 대한 오픈 소스 라이센스

  • Hugging Face 통합: Hugging Face에서 다운로드 및 배포 가능

  1. 모델 페이지 접근: Hugging Face에서 SenseNova-Loop-9B-Preview 페이지로 이동합니다.

  2. 종속성 설치: CUDA 환경에 맞는 PyTorch를 설치한 후, Transformers 5.18.0 및 PyTorch 2.11.0을 설치합니다.

  3. 모델 로드: Transformers 라이브러리를 사용하여 Hugging Face 리포지토리 또는 로컬 디렉토리에서 모델과 그 사용자 정의 구현을 로드합니다.

  4. 추론 구성: `model_id`를 리포지토리 ID 또는 로컬 경로로 설정하고 `enable_thinking` 및 `device`와 같은 매개변수를 구성합니다.

  5. 텍스트 생성: 제공된 Python 예제를 실행하여 새로운 토큰 수를 지정하여 텍스트 생성을 수행합니다.

  6. 모델 미세 조정: 문서화된 훈련 명령을 사용하여 SFT 데이터셋으로 8개의 GPU가 있는 단일 노드에서 미세 조정합니다.

  7. 모델 배포: 제공된 예제에서 로컬 모델 경로를 교체하여 LightLLM 또는 SGLang과 같은 배포 옵션을 활용합니다.

  • 긴 맥락 문서 이해
  • 에이전트 워크플로우 자동화
  • 다중 모달 콘텐츠 생성
  • 고급 코딩 지원
  • PPT 디자인 자동화
  • 모션 디자인 텍스트 생성
  • 데이터 분석 보고서
  • 다중 모달 연구 및 개발

SenseNova-Loop-9B-Preview 리뷰

로딩 중...

SenseNova-Loop-9B-Preview와(과) 비슷한 인기 AI 도구

MiniMax M3는 코딩 및 에이전틱 작업에서 뛰어난 성능을 발휘하는 고급 AI 모델입니다. 1M 컨텍스트 윈도우와 네이티브 멀티모달 이해 기능을 갖추고 있으며, MSA 아키텍처에 의해 구동됩니다. 이 모델은 오픈 웨이트 기능을 제공하여 개발자와 연구자에게 다재다능한 도구가 됩니다.

AI 모델 및 LLM

LLM 61위

도구 보기

코딩 및 에이전틱 작업에서 뛰어난 성능을 발휘하는 고급 AI 모델입니다. 1M 컨텍스트 윈도우와 네이티브 멀티모달 이해 기능을 갖추고 있으며, MSA 아키텍처에 의해 구동됩니다. 이 모델은 오픈 웨이트 기능을 제공하여 개발자와 연구자에게 다재다능한 도구가 됩니다.MiniMax M3는 코딩 및 에이전틱 작업에서 뛰어난 성능을 발휘하는 고급 AI 모델입니다. 1M 컨텍스트 윈도우와 네이티브 멀티모달 이해 기능을 갖추고 있으며, MSA 아키텍처에 의해 구동됩니다. 이 모델은 오픈 웨이트 기능을 제공하여 개발자와 연구자에게 다재다능한 도구가 됩니다.

AI 모델 및 LLM
LLM 61위

LiquidAI LFM3-1.7B는 로컬 에이전트 및 전문 애플리케이션을 위해 설계된 텍스트 모델입니다. 이 모델은 트라이 하이브리드 아키텍처를 특징으로 하며 256K 토큰의 컨텍스트 윈도우를 지원하여 엣지 장치에 적합합니다. 이 모델은 도메인별 파인 튜닝에 적합합니다.

AI 모델 및 LLM

LLM 91위

도구 보기

로컬 에이전트 및 전문 애플리케이션을 위해 설계된 텍스트 모델입니다. 이 모델은 트라이 하이브리드 아키텍처를 특징으로 하며 256K 토큰의 컨텍스트 윈도우를 지원하여 엣지 장치에 적합합니다. 이 모델은 도메인별 파인 튜닝에 적합합니다.LiquidAI LFM3-1.7B는 로컬 에이전트 및 전문 애플리케이션을 위해 설계된 텍스트 모델입니다. 이 모델은 트라이 하이브리드 아키텍처를 특징으로 하며 256K 토큰의 컨텍스트 윈도우를 지원하여 엣지 장치에 적합합니다. 이 모델은 도메인별 파인 튜닝에 적합합니다.

AI 모델 및 LLM
LLM 91위

DeepSeek-V4-Flash-Vision-Exp는 시각적 이해 능력을 향상시키는 DeepSeek-V4 계열의 실험적인 다중 모달 모델입니다. 이는 DeepSeek-V4-Flash 아키텍처를 기반으로 하여 텍스트 전용 성능을 유지하면서 개선된 다중 모달 에이전트 기능을 제공합니다.

AI 모델 및 LLM

LLM 70위

도구 보기

시각적 이해 능력을 향상시키는 DeepSeek-V4 계열의 실험적인 다중 모달 모델입니다. 이는 DeepSeek-V4-Flash 아키텍처를 기반으로 하여 텍스트 전용 성능을 유지하면서 개선된 다중 모달 에이전트 기능을 제공합니다.DeepSeek-V4-Flash-Vision-Exp는 시각적 이해 능력을 향상시키는 DeepSeek-V4 계열의 실험적인 다중 모달 모델입니다. 이는 DeepSeek-V4-Flash 아키텍처를 기반으로 하여 텍스트 전용 성능을 유지하면서 개선된 다중 모달 에이전트 기능을 제공합니다.

AI 모델 및 LLM
LLM 70위

Inkling-Small은 텍스트, 이미지 및 오디오 입력을 처리하여 텍스트 출력을 생성하는 다목적 다중 모달 모델입니다. 개발자가 챗봇 및 코딩 도우미와 같은 AI 애플리케이션을 생성하는 데 지원하며, 연구 및 통합을 위한 공개 가중치를 제공합니다.

AI 모델 및 LLM

LLM 27위

도구 보기

텍스트, 이미지 및 오디오 입력을 처리하여 텍스트 출력을 생성하는 다목적 다중 모달 모델입니다. 개발자가 챗봇 및 코딩 도우미와 같은 AI 애플리케이션을 생성하는 데 지원하며, 연구 및 통합을 위한 공개 가중치를 제공합니다.Inkling-Small은 텍스트, 이미지 및 오디오 입력을 처리하여 텍스트 출력을 생성하는 다목적 다중 모달 모델입니다. 개발자가 챗봇 및 코딩 도우미와 같은 AI 애플리케이션을 생성하는 데 지원하며, 연구 및 통합을 위한 공개 가중치를 제공합니다.

AI 모델 및 LLM
LLM 27위

pplx-embed-v2-context-9b-preview는 RAG 시스템에서 문서 청크를 위한 컨텍스트 임베딩 모델입니다. 이 모델은 문서 청크를 함께 인코딩하여 주변 컨텍스트를 반영하고, 청크당 하나의 임베딩을 반환합니다.

AI 모델 및 LLM
도구 보기

RAG 시스템에서 문서 청크를 위한 컨텍스트 임베딩 모델입니다. 이 모델은 문서 청크를 함께 인코딩하여 주변 컨텍스트를 반영하고, 청크당 하나의 임베딩을 반환합니다.pplx-embed-v2-context-9b-preview는 RAG 시스템에서 문서 청크를 위한 컨텍스트 임베딩 모델입니다. 이 모델은 문서 청크를 함께 인코딩하여 주변 컨텍스트를 반영하고, 청크당 하나의 임베딩을 반환합니다.

AI 모델 및 LLM
AI 모델 TOP 5 보기

DeepSeek V4 Flash는 고급 텍스트 생성 작업을 위해 설계된 AI 모델 컬렉션입니다. 오픈 소스 및 오픈 사이언스 원칙을 활용하여 인공지능을 민주화하고, 다양한 응용 프로그램을 위한 다양한 매개변수를 가진 모델을 제공합니다.

AI 모델 및 LLM
도구 보기

고급 텍스트 생성 작업을 위해 설계된 AI 모델 컬렉션입니다. 오픈 소스 및 오픈 사이언스 원칙을 활용하여 인공지능을 민주화하고, 다양한 응용 프로그램을 위한 다양한 매개변수를 가진 모델을 제공합니다.DeepSeek V4 Flash는 고급 텍스트 생성 작업을 위해 설계된 AI 모델 컬렉션입니다. 오픈 소스 및 오픈 사이언스 원칙을 활용하여 인공지능을 민주화하고, 다양한 응용 프로그램을 위한 다양한 매개변수를 가진 모델을 제공합니다.

AI 모델 및 LLM
AI 모델 TOP 5 보기

Muse Spark 1.3는 Meta의 에이전트 및 코딩 워크플로우를 위한 AI 모델로, 신뢰할 수 있는 도구 호출과 다단계 추론이 필요한 장기 작업을 위해 구축되었습니다. 비디오, 이미지 및 문서에 대한 기본 멀티모달 인식을 제공하며, 100만 토큰의 컨텍스트 윈도우를 가지고 있으며, Meta Model API 또는…

AI 모델 및 LLM
도구 보기

Meta의 에이전트 및 코딩 워크플로우를 위한 AI 모델로, 신뢰할 수 있는 도구 호출과 다단계 추론이 필요한 장기 작업을 위해 구축되었습니다. 비디오, 이미지 및 문서에 대한 기본 멀티모달 인식을 제공하며, 100만 토큰의 컨텍스트 윈도우를 가지고 있으며, Meta Model API 또는…Muse Spark 1.3는 Meta의 에이전트 및 코딩 워크플로우를 위한 AI 모델로, 신뢰할 수 있는 도구 호출과 다단계 추론이 필요한 장기 작업을 위해 구축되었습니다. 비디오, 이미지 및 문서에 대한 기본 멀티모달 인식을 제공하며, 100만 토큰의 컨텍스트 윈도우를 가지고 있으며, Meta Model API 또는…

추천AI 모델 및 LLM
AI 모델 TOP 5 보기

LLaVA

AI GitHub 저장소

LLaVA는 대규모 언어 및 시각 기능을 결합한 시각적 명령어 튜닝 모델입니다. GPT-4V 수준의 성능 달성을 목표로 하며, 멀티모달 이해 및 상호작용을 가능하게 합니다. 이 프로젝트는 연구원 및 개발자를 위한 코드, 모델 및 리소스를 제공합니다.

AI 모델 및 LLM
도구 보기

AI GitHub 저장소

대규모 언어 및 시각 기능을 결합한 시각적 명령어 튜닝 모델입니다. GPT-4V 수준의 성능 달성을 목표로 하며, 멀티모달 이해 및 상호작용을 가능하게 합니다. 이 프로젝트는 연구원 및 개발자를 위한 코드, 모델 및 리소스를 제공합니다.LLaVA는 대규모 언어 및 시각 기능을 결합한 시각적 명령어 튜닝 모델입니다. GPT-4V 수준의 성능 달성을 목표로 하며, 멀티모달 이해 및 상호작용을 가능하게 합니다. 이 프로젝트는 연구원 및 개발자를 위한 코드, 모델 및 리소스를 제공합니다.

AI 모델 및 LLM
AI GitHub 저장소 TOP 250 보기
1/8