설명
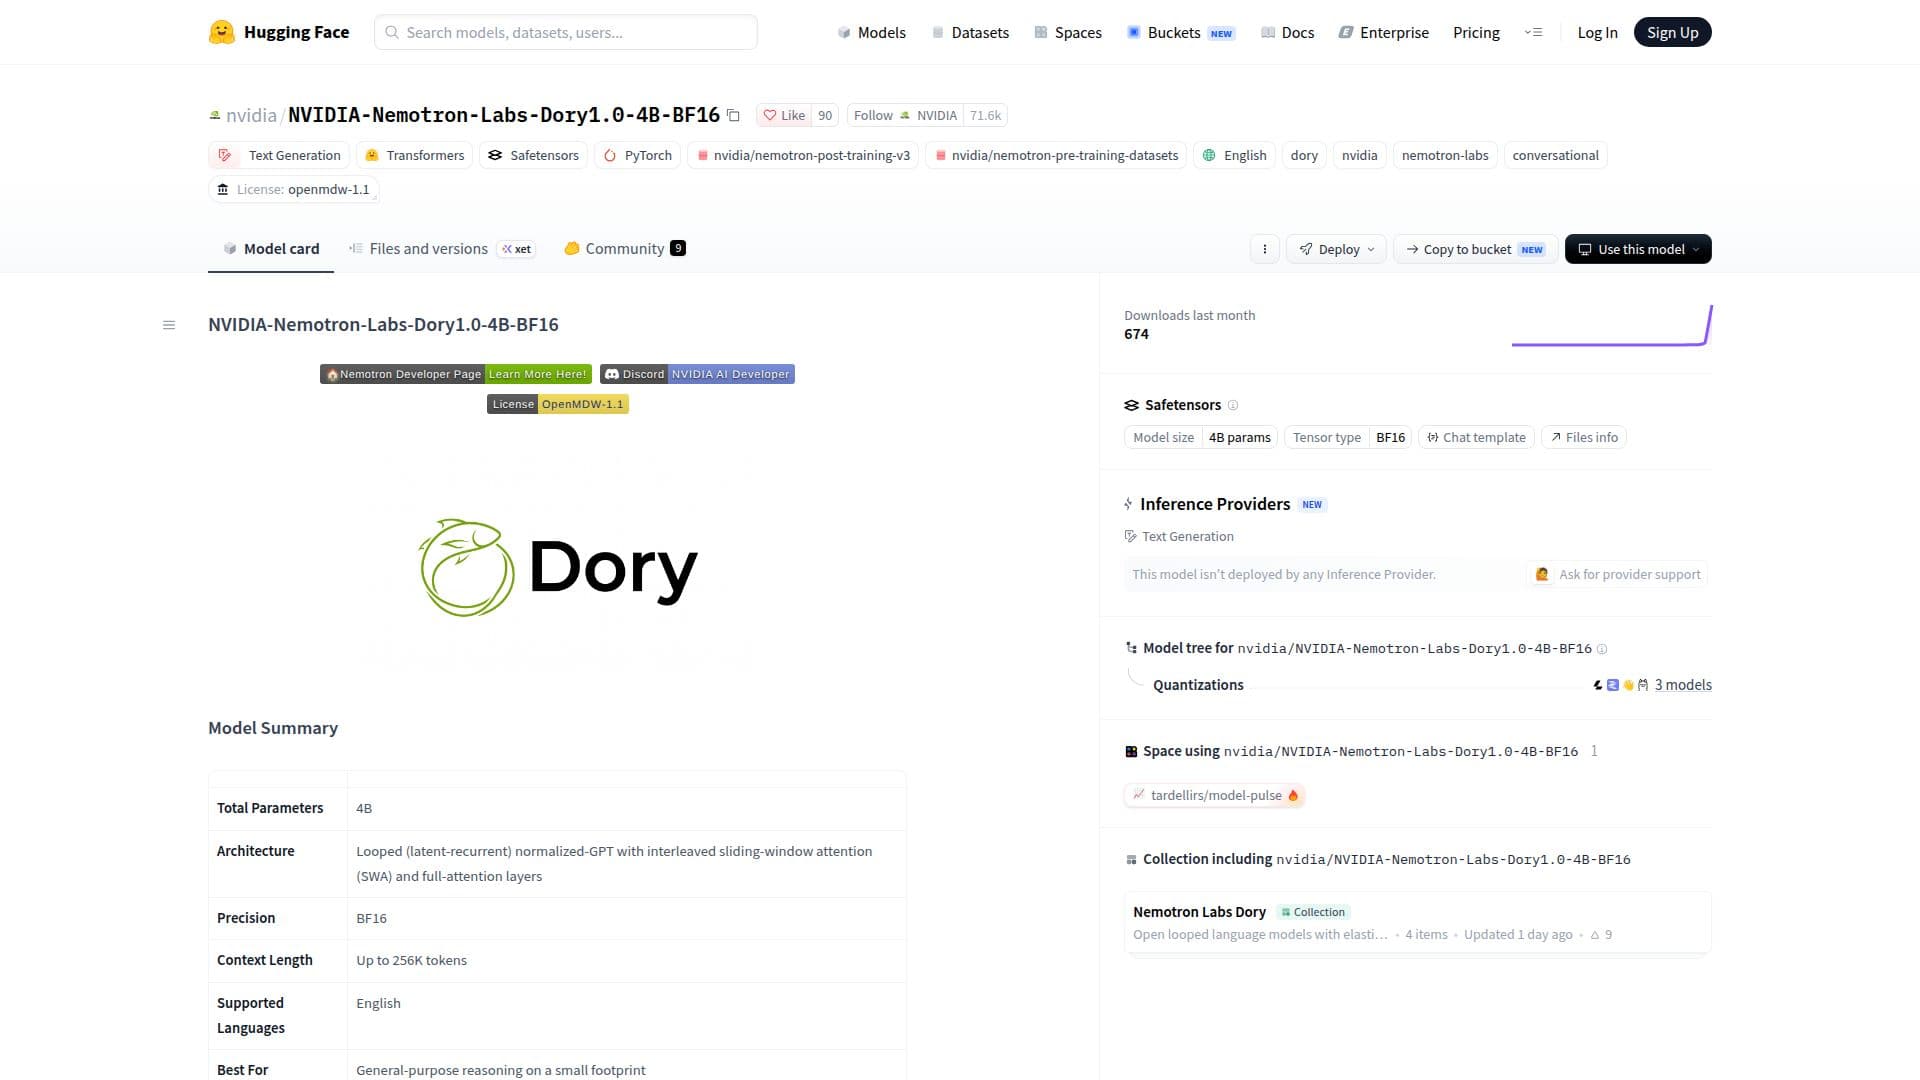
NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16는 NVIDIA에서 개발한 대형 언어 모델로, 루프형(잠재-재귀) 정규화된-GPT 아키텍처를 활용합니다. 이 모델은 작은 계산 자원을 유지하면서 일반적인 추론 작업을 처리하도록 설계되었습니다. 슬라이딩 윈도우 주의(SWA)와 전체 주의 레이어가 교차하여 최대 256K 토큰의 컨텍스트 길이를 효율적으로 처리할 수 있습니다.
더 읽기
이 모델은 40억 개의 매개변수로 구성되어 있으며 BF16 정밀도를 사용하여 상업적 및 비상업적 응용 프로그램 모두에 적합합니다. 영어 언어 처리를 지원하며 일반적인 추론 능력이 필요한 작업에 가장 적합합니다. 모델의 아키텍처는 탄력적인 추론 컴퓨팅을 가능하게 하여 사용자가 루프 수를 조정하여 계산 효율성과 정확성 간의 균형을 맞출 수 있도록 하며, 재교육이 필요하지 않습니다.
Dory1.0-4B-BF16는 NVIDIA의 NVFP4 형식을 사용하여 사전 훈련된 후 BF16으로 계속 진행되어 NVIDIA GPU 가속 시스템에서 높은 성능을 보장합니다. BF16, MXFP8, NVFP4 및 Q5_K_M을 포함한 여러 형식으로 제공되어 다양한 하드웨어 구성에서의 배포에 유연성을 제공합니다.
모델의 훈련에는 6조 개의 토큰이 사용되었으며, 수학, 과학 및 일반 지식과 같은 다양한 도메인에 중점을 두었습니다. 다단계 도구 사용, 지시 사항 준수 및 구조화된 출력 환경에서 성능을 향상시키기 위해 감독된 미세 조정 및 강화 학습을 거쳤습니다. 모델의 벤치마크는 코딩, 추론 및 지시 사항 준수와 같은 다양한 작업에서 경쟁력 있는 성능을 보여줍니다.
NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16는 OpenMDW 라이선스 계약 버전 1.1에 따라 관리되며, 2026년 10월 16일에 출시되었습니다. NVIDIA의 Hopper 및 Blackwell 아키텍처에서 최적의 성능을 발휘하도록 설계되었으며, Linux 운영 체제를 지원합니다.
- 카테고리AI 모델 및 LLM
- 요금제오픈소스
- 배포클라우드
- 플랫폼Linux
NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16 하이라이트
루프형 잠재-재귀 아키텍처
교차 슬라이딩 윈도우 주의
256K 토큰 컨텍스트 길이
BF16 정밀도
탄력적인 추론 컴퓨팅
네이티브 NVFP4 사전 훈련
메모리 효율적인 루핑
OpenMDW 라이선스 계약
NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16 시작하기
모델 페이지 접근: NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16의 Hugging Face 모델 페이지를 방문하세요.
인증: 모델에 접근하기 위한 필요한 자격 증명이 있는지 확인하세요.
구성: 루프 수 및 KV 캐시 설정을 포함하여 모델 매개변수를 설정하세요.
프롬프트 전송: 모델에 처리할 텍스트 시퀀스를 입력하세요.
미세 조정: 필요에 따라 특정 작업을 위한 모델 설정을 조정하세요.
NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16의 사용 사례
- 일반 추론
- 코딩 작업
- 지시 사항 준수
- 긴 컨텍스트 처리
- 과학 연구