설명
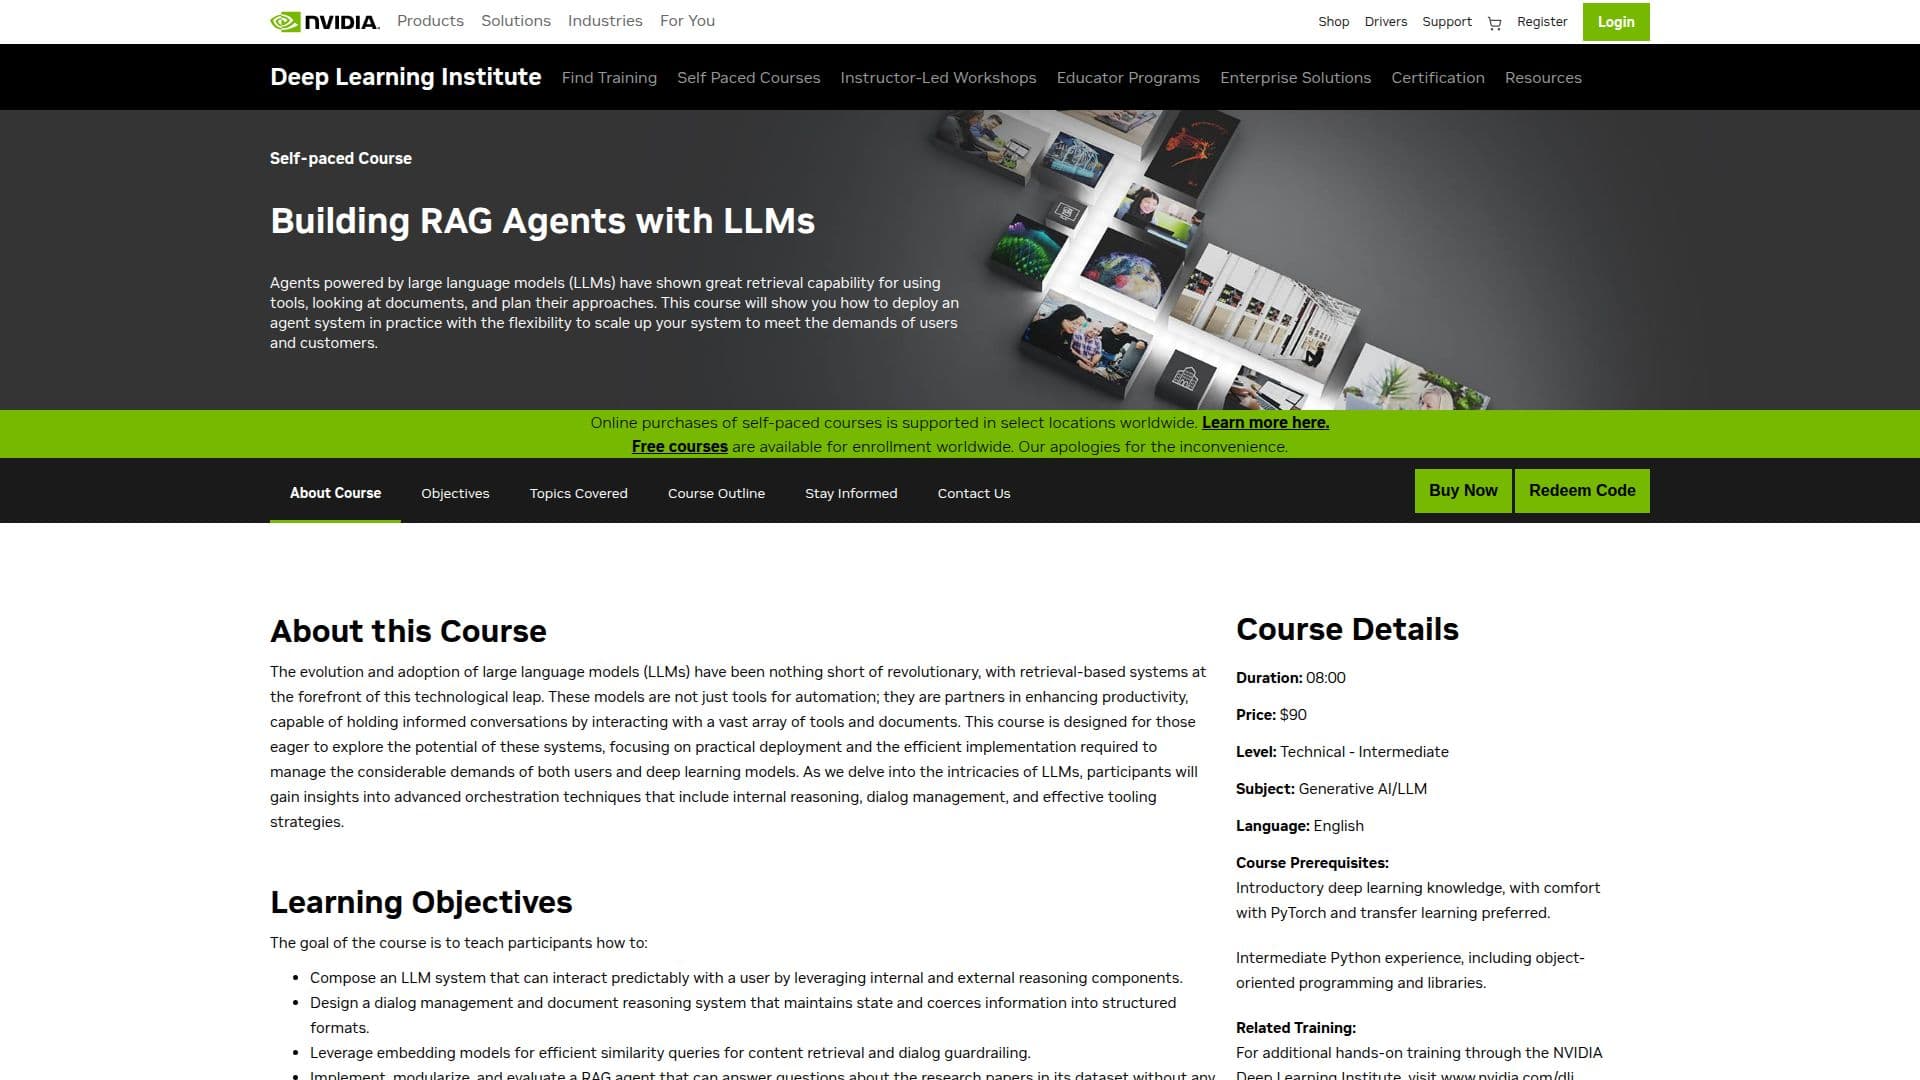
NVIDIA의 LLM을 활용한 RAG 에이전트 구축 과정은 대규모 언어 모델(LLM)의 혁신적인 발전과 검색 기반 시스템에서의 적용에 대해 깊이 있게 다룹니다. 이러한 모델은 다양한 도구 및 문서와의 상호작용을 통해 정보에 기반한 대화를 가능하게 하여 생산성을 향상시킵니다. 이 과정은 LLM의 잠재력을 탐구하고자 하는 개인을 위해 맞춤 설계되었으며, 사용자와 딥러닝 모델의 요구를 관리하기 위한 실용적인 배포 및 효율적인 구현에 중점을 둡니다.
더 읽기
참가자들은 내부 추론, 대화 관리 및 효과적인 도구 전략을 포함한 고급 오케스트레이션 기술에 대한 통찰을 얻게 됩니다. 이 과정은 참가자들이 내부 및 외부 추론 구성 요소를 활용하여 사용자와 예측 가능한 상호작용을 하는 LLM 시스템을 구성하는 방법을 가르치는 것을 목표로 합니다. 또한 상태 및 구조 정보를 유지하는 대화 관리 및 문서 추론 시스템 설계에 대해서도 다룹니다.
이 과정은 LLM 추론 인터페이스, LangChain, Gradio 및 LangServe를 이용한 파이프라인 설계, 실행 상태를 통한 대화 관리, 문서 작업과 같은 주제를 포함합니다. 참가자들은 의미적 유사성을 위한 임베딩 활용 및 가드레일링을 배우고, 효율적인 문서 검색을 위한 벡터 저장소를 구현하는 방법을 배웁니다. 워크숍이 끝날 무렵, 참가자들은 RAG 에이전트에 대한 확고한 이해와 자신의 LLM 애플리케이션을 개발하는 데 필요한 도구를 갖추게 됩니다.
이 과정은 기초적인 딥러닝 지식, PyTorch 및 전이 학습에 대한 친숙함, 중급 수준의 Python 경험이 있는 사람들에게 적합합니다. RAG 에이전트에 대한 포괄적인 이해를 제공하며, 참가자들이 고급 LLM 시스템을 효과적으로 개발하고 배포할 수 있는 기술을 갖추도록 합니다.
- 카테고리기업 교육 및 이러닝
- 요금제무료
NVIDIA LLM을 활용한 RAG 에이전트 구축의 핵심 기능
내부 및 외부 추론을 활용한 LLM 시스템 구성
대화 관리 시스템 설계
유사성 쿼리를 위한 임베딩 모델 활용
미세 조정 없이 RAG 에이전트 구현
LLM 추론 인터페이스 탐색
LangChain, Gradio 및 LangServe를 이용한 파이프라인 설계
대화 상태 관리 및 지식 추출 통합
의미적 유사성을 위한 임베딩 활용
NVIDIA LLM을 활용한 RAG 에이전트 구축 사용 방법은?
구성: 워크숍을 위한 환경 설정
사용: LLM 추론 인터페이스 및 마이크로서비스 탐색
최적화: LangChain, Gradio 및 LangServe를 이용한 LLM 파이프라인 설계
평가: 효율적인 문서 검색을 위한 벡터 저장소 구현
NVIDIA LLM을 활용한 RAG 에이전트 구축의 사용 사례
- 대화 시스템 설계
- 콘텐츠 검색
- LLM 애플리케이션 개발
- 의미적 유사성
- 지식 추출